Yosys 综合流程:一条 synth 命令背后七步各做什么,stat 报告怎么读
更新时间:2026-10-28。本文是「集成电路大类 · 芯片设计」初学者层(beginner)的一篇实验文。概念篇 综合入门:RTL 如何变成门级网表 讲了综合「是什么」,逻辑综合 一篇梳理了综合在整条芯片流程里的位置。但真把 Yosys 跑起来,多数人只敲过一句
synth -top xxx,然后盯着末尾一张 stat 表发懵:这些$_DFF_PN0_、$_MUX_是什么?单元数为什么和想象对不上?本篇把一个 8 位宽、16 深度的异步 FIFO(就是 用 cocotb 验证异步 FIFO 里那块 RTL)拿过来,分步手动综合一遍、一键synth再跑一遍,每个大阶段后打一次 stat,用三份快照把 Yosys 综合流程的每一步摊开看。
本文要回答的问题
- 一句
synth宏命令展开后,read / hierarchy / proc / opt / techmap / abc / stat 这七步各自做什么? proc之后「进程数变 0」意味着什么?$adff、$_DFF_PN0_这些单元名怎么读?- stat 报告里的 wires、cells、memories 三组数字,哪个反映「面积」?
- 分步跑和一键
synth的结果为什么差出好几倍单元?差的这部分是什么?
先把整条流水线摆出来,七个编号就是后面逐节拆解的顺序:
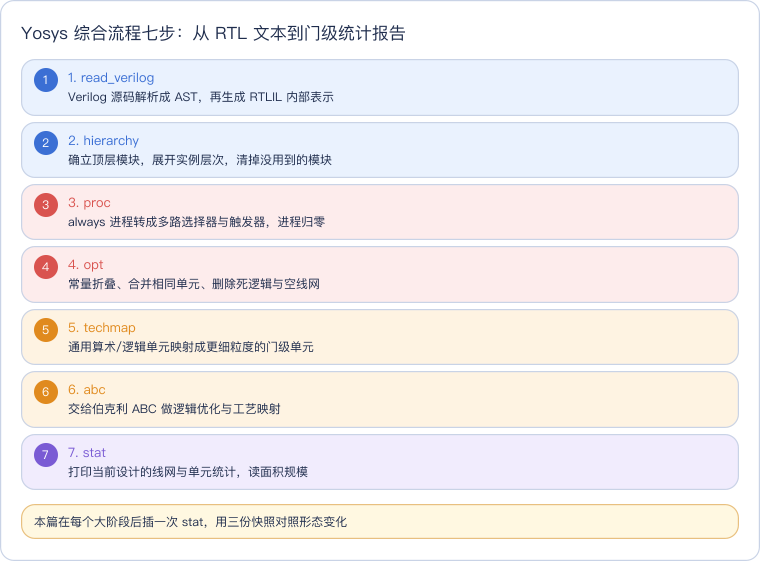
读这张流程卡抓住一个分界:前两步(蓝色)处理的是「文本与结构」,设计此时还是高级描述;中间两步(红色)是真正的「综合」——行为级进程消失,变成触发器加组合逻辑;后两步(橙色)处理的是「工艺」,把通用单元换成目标库里真实存在的门;最后 stat(紫色)只是观察者,不改设计,负责把结果翻译成你能比较的数字。
一、实验对象与两种跑法
实验对象是一块经典异步 FIFO:写读两个时钟域,指针跨域走格雷码加两级同步,内部带一块 16×8 的存储阵列(格雷码跨域的原理见 多 bit CDC:异步 FIFO 与 Gray 码指针设计)。选它是因为结构够典型:有存储、有触发器、有组合逻辑,stat 表里的每类单元都能对上号。
两种跑法写在两个脚本里。分步版 steps.ys 把七个动作一条条写出来,并在三个位置插入 stat 打快照:
read_verilog rtl/async_fifo.v
hierarchy -check -top async_fifo
stat
proc
opt
stat
techmap
opt
abc
opt_clean
stat
对照版 synth.ys 只有三行:read_verilog 读源码、synth -top async_fifo 一把梭、stat 看结果。synth 本身是个宏命令,展开后大致就是分步版那串动作再加几道额外的清洗与存储映射,后文第五节的数字会直观告诉你差在哪。两次运行在同一台机器、同一 Yosys 版本下完成,命令与原始输出见文末实验环境。
二、七步各做什么:跟着日志走一遍
在看数字之前,先定位这一步在整条芯片设计流程里的位置——综合是「前端行为描述」与「后端物理实现」之间的翻译官:
红色块是本文的地界:它的输入是仿真验证过的 RTL(蓝色),输出是交给形式验证(橙色)与布局布线(紫色)的门级网表。stat 报告之所以重要,是因为它是综合这一步唯一「看得见摸得着」的产出摘要——网表本身是几万行的单元例化,人读不动,数字才能比。下面跟着真实日志逐段看。
read_verilog:文本进,RTLIL 出。 日志第一行 Executing Verilog-2005 frontend 把 async_fifo.v 解析成抽象语法树,再生成 Yosys 的内部表示 RTLIL。此刻的设计还非常「高级」:进程(always 块)、存储器、加法器都以抽象节点存在。紧随其后的 hierarchy 确立顶层模块 async_fifo,检查有没有悬空实例——脚本里的 -check 会在层次有问题时直接报错退出,这是脚本健壮性的第一道保险。
proc:always 块消失的地方。 这是整个综合里语义变化最大的一步。日志里能清楚看到 proc 自己的一串子步骤:PROC_ARST 在六个进程里识别出 \wrst_n、\rrst_n 两个异步复位;PROC_MUX 把 if/case 决策树改写成多路选择器;PROC_DFF 把进程里的时序逻辑物化成触发器单元,比如这一行:
4.7. Executing PROC_DFF pass (convert process syncs to FFs).
Creating register for signal `\async_fifo.\empty_r' using process `\async_fifo.$proc$rtl/async_fifo.v:62$33'.
  created $adff cell `$procdff$43' with positive edge clock and negative level reset.
$adff 读作「带异步复位的 D 触发器」(A 即 async reset),positive edge clock、negative level reset 对应 RTL 里的 posedge wclk or negedge wrst_n。六个进程各物化出若干触发器,日志里一共创建了 $procdff$43 到 $procdff$55 共 13 个触发器单元,其中 10 个带异步复位、3 个不带(那 3 个正是存储器写口的内部寄存)。proc 跑完,第二次 stat 里 Number of processes: 0——行为级描述到此清零,设计里只剩单元与线网。
这里可以顺手读一下第一次 stat(read 刚结束时):25 个单元里有 2 个 $add(写读两个指针的加一)、2 个 $eq(空满判断的指针比较)、1 个 $memrd 加 1 个 $memwr(存储阵列的两个口)、7 个 $logic_not(格雷码与复位逻辑里的取反),再加 7 个 processes——七个 always 块原封不动地躺在统计里。这时的单元数是「RTL 写了什么」的直接镜像,还不代表任何硬件规模;它真正的价值是当基准线,后面每一步的增减都拿它对照。
opt:反复打磨直到不动。 opt 不是一个动作而是一组 pass 的循环:常量折叠(OPT_EXPR)、合并相同单元(OPT_MERGE)、删除死分支(OPT_MUXTREE)、清理孤儿线网(OPT_CLEAN)。日志里第一轮 OPT_MERGE 删了 4 个重复单元、OPT_CLEAN 删了 2 个单元和 31 根线,循环到「There is nothing left to do」才停。techmap 之后再跑一轮 opt,又删了 11 个单元和 77 根线——映射展开的冗余在这里被收掉。日志里还能看到 OPT_REDUCE 的一次典型操作:一个 8 位的 $mux 两个输入分别是全 0 和全 1,被压缩成 1 位选择再加 7 根直连线。这类「宽mux退化为选择器」的化简在控制逻辑里非常常见,也是 opt 存在感的来源。
techmap 与 abc:通用单元换成门。 techmap 把 $add、$eq 这类通用算术单元展开成更细的门级结构——日志里能看到 5 位加法器被套进 alumacc 模板(加法器与累加器的通用包装)、$mux/$not/$and 走 simplemap 直接翻译。abc 则把网表导出成 BLIF 格式,调用伯克利的 ABC 工具做逻辑优化与映射,再导回 Yosys。ABC 自己的报告把组合逻辑的优化结果列得很直白:
9.1.1. Executing ABC.
ABC: + strash
ABC: + ifraig
ABC: + scorr
ABC: + dc2
ABC: + dretime
ABC RESULTS:               AND cells:       23
ABC RESULTS:            ANDNOT cells:        5
ABC RESULTS:              AOI3 cells:        2
ABC RESULTS:              MUX cells:         2
ABC RESULTS:              NOR cells:         9
ABC RESULTS:              NOT cells:         6
ABC RESULTS:             XNOR cells:       14
ABC RESULTS: XOR cells: 5strash、dc2、dretime 这串命令是 ABC 的经典优化脚本:先把网表转成 AIG(与-非图)结构,再做重构与重定时。回来后单元名从 $add 风格换成 $_AND_、$_XOR_ 这种带下划线包围的名字——名字里带 $_..._ 就是门级单元,这是读 stat 表时区分「映射前 / 映射后」的一眼判据。注意 ABC 只处理组合逻辑,触发器原样保留,所以快照三里 DFF 与门是混排的。
三、三次 stat 快照:形态变化全在数字里
把三份快照并排,形态迁移一目了然:
| 统计项 | 快照一(read 后) | 快照二(proc+opt 后) | 快照三(techmap+abc 后) |
|---|---|---|---|
| wires | 64 | 39 | 68 |
| wire bits | 248 | 152 | 164 |
| processes | 7 | 0 | 0 |
| memories | 1(128 bit) | 1(128 bit) | 1(128 bit) |
| cells 总数 | 25 | 31 | 124 |
| 代表性单元 | $add 2、$memrd 1 | $adff 10、$dff 3 | $AND 23、$XNOR 14 |
快照一到快照二,单元数从 25 涨到 31:proc 物化出 13 个触发器单元,opt 又删掉了一些冗余,净增 6 个。真正的跳变在快照三:124 个单元,几乎全是 $_..._ 门。组合逻辑被 ABC 重构成与或非门为主的样子——$_AND_ 23 个、$_XNOR_ 14 个(格雷码转换与指针比较是异或密集型逻辑,这个数字很符合直觉)、$_XOR_ 5 个。
单元命名其实是本「词典」,把 stat 里出现过的名字对照着认一遍,以后看任何报告都不慌:
| 单元名 | 含义 | 来源阶段 |
|---|---|---|
| $add / $eq / $shr | 通用算术与比较单元(加法、相等、移位) | read 后直接存在 |
| $mux | 多路选择器,if/case 决策树的化身 | proc |
| $dff / $adff | D 触发器 / 带异步复位的 D 触发器 | proc |
| $memrd / $memwr | 存储器读口 / 写口(阵列还保持整体形态) | read 后直接存在 |
| $AND / $XOR 等 | 门级单元,下划线包围是标志 | techmap / abc 之后 |
| $DFF_P / $DFF_PN0 | 门级触发器,P=上升沿时钟,N0=低有效复位到 0 | techmap / abc 之后 |
这张表还隐含一个排错技巧:如果跑到最后 stat 里还残留 $add、$mux 这类不带下划线的通用单元,说明 techmap/abc 没有覆盖到它们——多半是流程脚本漏了步骤,或某些单元被显式保留了(比如本篇分步版里的 $memrd/$memwr 就是刻意留给后端的)。
触发器这一栏值得单独读。快照三里三种 DFF:$_DFF_PN0_ 39 个、$_DFF_P_ 13 个、$_DFF_PN1_ 1 个,合计 53 个。命名规则是「时钟沿 + 复位极性 + 复位值」:P 表示时钟上升沿,N0 表示低电平异步复位且复位到 0。39 个 PN0 对应带异步复位清零的寄存器位——四个 5 bit 指针(rbin/rgray/wbin/wgray)加四条 5 bit 跨域同步链正好 40 bit,其中一位在优化中被重构,39 落在这一类;13 个 $_DFF_P_ 是存储器写口内部寄存出的地址、数据与使能位(4+8+1=13,与日志里 proc 阶段创建的三个 $dff 单元位宽吻合);剩下 1 个 PN1 是复位到 1 的寄存器位。RTL 里每一个 always @(posedge ... or negedge ...) 块,最后都能在这张表里点出名来。
还有一个不变的量值得注意:三次快照里 Number of public wire bits: 86 纹丝不动。public wire 是模块的对外端口,综合内部怎么折腾,接口承诺不变——这正是综合「保持功能等价」在统计表上的投影。
四、stat 报告实录与读法
下面这张终端实录是分步跑第三次 stat 的真实输出,也就是上文快照三的原文:
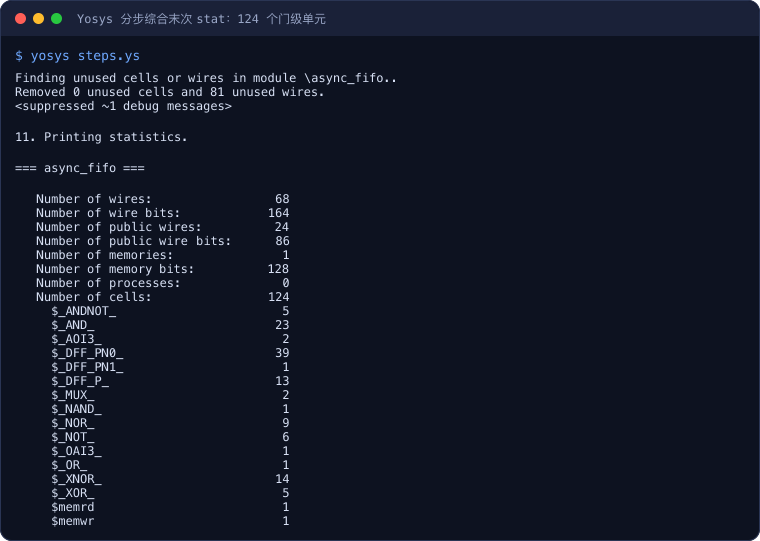
读这份报告按四行一组来:wires / wire bits 反映连线规模,线多不一定差,但异常膨胀往往意味着结构没收敛;memories 告诉你存储阵列是否还保持「存储器」形态,这里是 1 块 128 bit,说明分步脚本没有做存储映射,它留给了后端或 FPGA 的块 RAM 推断;cells 按类型逐行列出,是估算面积的主要依据;末尾的 CPU/MEM 行给出这次运行花了 0.07 秒用户时间、17 MB 内存,小设计的综合快到可以随便迭代。
说到面积估算,通用工艺下 Yosys 不给官方面积数字(那要映射到具体标准单元库、读 Liberty 里的 area 字段才有),但工程上有套粗估办法:给每类门一个相对权重——以最小二输入 NAND 为 1,AND 约 1.3、XOR/XNOR 约 2.5、MUX 约 2、DFF 约 4——加权求和后在设计之间做横向比较。拿快照三演练一遍:23 个 AND 约 30、14 个 XNOR 加 5 个 XOR 约 48、53 个 DFF 约 212,再算上 NOR/NOT/AOI 等杂项约 30,总量级在 320 个「NAND 等效」上下,其中触发器占了三分之二。这个比例本身就是结论:这块 FIFO 的面积大头是状态不是逻辑,想省面积得从位宽与深度下手,抠组合逻辑意义不大。这也是 stat 报告的正确用法——不追求绝对准确,追求的是「钱花在哪儿」的分布感。
日志结尾还有一行容易被忽略的 Time spent: 21% 6x opt_clean, 14% 7x opt_merge, ...——它告诉你时间花在哪类 pass 上。设计变大以后这行就是你的性能剖析入口:哪个 pass 占比异常高,就去查它为什么收敛慢。想深入这类「单元级对照」的玩法,可以看 用 Yosys 对比时钟门控前后的综合结果 与 FSM 编码方式对综合面积的影响,两篇都是用 stat 数字说话的姊妹实验。
五、对照实验:一键 synth 多出近四百个单元
同样的 RTL,换 synth -top async_fifo 一键跑,末次 stat 的格子完全变了样:
   Number of cells:                519
     $_ANDNOT_                      11
     $_DFF_PN0_                     39
     $_DFF_PN1_                      1
     $_DFF_P_                      128
     $_MUX_                        248
     $_NAND_                         4
     $_NOR_                          1
     $_NOT_                         16
     $_ORNOT_                        6
     $_OR_                          37
     $_XNOR_                         7
$_XOR_ 21两个变化最扎眼。第一,memories 从 1 变成 0——synth 宏里包含 memory 相关的映射步骤,把 128 bit 的存储阵列直接展开成了触发器,这就是 $_DFF_P_ 从 13 暴涨到 128 的原因:每一位存储单元变成一个触发器。第二,$_MUX_ 高达 248 个——存储阵列一旦摊平成触发器堆,读写端口就退化成「128 选 1」的多路选择器树,MUX 数量随之爆炸。单元总数 124 对 519,四倍多的差距全部来自这个存储映射决策。
这个对照回答了一个新手常困惑的问题:为什么我的设计综合出来单元数比预想多得多?先别急着怀疑 RTL,先看 memories 那行——如果它是 0,说明存储被摊平了。对 FPGA 流程,你通常希望存储保持形态、交给厂商原语去推断块 RAM;对某些 ASIC 前门仿真或没有存储编译器的场景,摊平反而是需要的。stat 报告里 memories 与 DFF 的此消彼长,是判断「存储去了哪」的第一线索。 一键 synth 的那次运行末尾 Time spent: 23% 15x opt_clean, 16% 13x opt_expr——opt_clean 跑了 15 趟、opt_expr 跑了 13 趟,宏命令内部的清洗密度明显高于手写分步版,这也是两者结果不可能逐单元相同的原因之一。
值得强调的是,519 对 124 不代表一键版「更差」。多出来的近四百个单元不是浪费,而是同一个存储阵列的另一种存在形态:128 个触发器加读写选择树,功能上与分步版里那块保持整体的 128 bit 存储完全等价。两种结果谁更优取决于后端——有块 RAM 可推断时,分步版的 $memrd/$memwr 会被替换成一两个硬核存储块,面积远小于 519 个散装单元;没有存储资源时,摊平反而是唯一出路。综合报告的单元数只有在「同一映射策略」下才可比,跨策略比总数就像拿集装箱与散货比件数。
实验环境
- 机器/系统:云主机,eda-golden-v1 镜像,Ubuntu 22.04
- 工具版本:Yosys 0.9 (git sha1 1979e0b)
- 日期:2026-10-28
- 完整命令:
yosys steps.ys(分步综合,三次 stat 快照);yosys synth.ys(一键 synth 对照),两个脚本与 RTL 见下方代码获取
代码获取:本文全部 RTL 与 Yosys 脚本在公开仓库 https://github.com/derekzhuo/geek-doc.cn/tree/main/experiments/yosys-synthesis-flow-report ,克隆后在目录下执行 yosys steps.ys 或 yosys synth.ys 即可复现两份日志。
这一篇在知识体系里的位置
本篇是综合主题的「第一块实验砖」:概念上承 综合入门:RTL 如何变成门级网表 与 逻辑综合,把「综合就是把 RTL 翻译成门级网表」这句话落实成七步可复现的动作;实验方法(分步插 stat、对照宏命令)与同簇的 用 Yosys 对比时钟门控前后的综合结果、FSM 编码方式对综合面积的影响 一脉相承;被综合的异步 FIFO 本身,其原理在 多 bit CDC:异步 FIFO 与 Gray 码指针设计、功能验证在 用 cocotb 验证异步 FIFO,三篇合起来刚好覆盖「设计—验证—综合」的小闭环。
一句话总结
Yosys 综合流程的七步各有明确分工:read 与 hierarchy 把文本变成结构,proc 把 always 进程物化成触发器与多路选择器(进程数归零是它的毕业礼),opt 循环收敛冗余,techmap 与 abc 把通用单元换成门级单元,stat 则是贯穿始终的观察者——读它抓住三件事:processes 是否归零、单元名是否换成 $_..._ 门级风格、memories 与 DFF 的此消彼长暴露存储被映射成了什么形态,掌握了这三点,任何一份综合报告你都能在五秒内读出设计的规模与形态。