AI 集群网络之争:InfiniBand 与 UEC 以太网的攻防
数据截止 2026-09。承接胖树与 Rail 优化、UALink,关联博通。
当集群从几百张卡扩展到几万张,一个残酷的事实会浮现:贵的是 GPU,但真正决定这些 GPU 能不能高效协同的,是网络。 训练一个大模型时,各张卡要频繁同步梯度、交换中间结果,任何网络延迟、拥塞或带宽不足,都会让大量昂贵的计算单元空等。AI 集群网络因此从“配角”变成了与算力并列的核心。过去十余年,这一层几乎是英伟达 InfiniBand 的天下;而现在,以博通、Arista、AMD 等组成的以太网阵营,正带着“超以太网联盟(UEC)”发起近年来最有底气的一次反攻。
先说结论
- 先分清两类网络:Scale-Up(机柜内 GPU 高速直连,NVLink/UALink)和 Scale-Out(跨机柜/跨集群互联,InfiniBand/以太网),二者分工不同,争论焦点主要在 Scale-Out。
- InfiniBand 长期主导 AI 后端网络,靠的是天生为 RDMA、低延迟和无损/拥塞控制设计,加上与英伟达 GPU、软件栈的深度协同,性能与省心程度最高。
- 以太网反攻的底气来自规模成本、开放生态和供应商选择:借助 RoCE/RDMA、改进的拥塞控制,以及 UEC 提出的新一代传输(包喷射、多路径、现代负载均衡),它正把 AI 网络的性能差距缩小。
- 客户的核心诉求往往不是“绝对最快”,而是“足够快 + 不被单一厂商锁定 + 成本可控”,这正是以太网最有力的卖点。
- 最终格局更可能是分层共存:最高端、最敏感的训练仍偏 InfiniBand/NVLink,大规模推理与通用训练越来越多用以太网,而非任何一方被彻底取代。
节点速览:技术 / 玩家 / 成熟度 / 预期
数据截止 2026-09。标尺说明见 AI 产业链总览。
| 象限 | 要点 |
|---|---|
| 关键技术 | ① RDMA/内核旁路低延迟(TRL-5)② InfiniBand 无损网络与自适应路由(TRL-4~5)③ 以太网 RoCE + 拥塞控制(DCQCN 等,TRL-4)④ UEC 包喷射/多路径/新传输(TRL-2~3,落地中) |
| 主要玩家 | InfiniBand:英伟达(Mellanox);以太网:博通(Tomahawk)、Arista、AMD、思科、Eviden + UEC 联盟(含超大规模厂商) |
| 做到什么程度 | InfiniBand 在大规模训练中份额仍领先;以太网在推理与大型云 AI 集群中快速渗透,UEC 标准与产品从规范走向早期部署 |
一、先分清 Scale-Up 和 Scale-Out
讨论 AI 网络前,必须先建立一个基本框架,否则很容易把 NVLink、InfiniBand、以太网混为一谈。它们其实处在不同的层级。
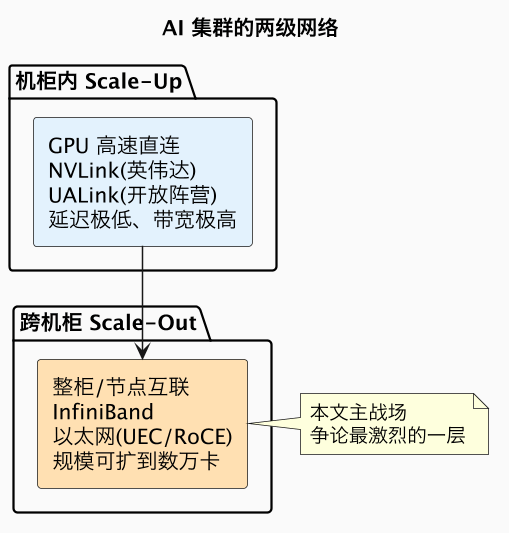
Scale-Up 解决的是“一个机柜内,几颗到几十颗 GPU 如何像一颗巨型芯片一样共享内存、高速通信”的问题。英伟达的 NVLink/NVSwitch 和开放阵营的 UALink 都属于这一层,特点是距离短、带宽极高、延迟极低,通常只在机柜或相邻机柜范围。
Scale-Out 解决的是“如何把成千上万个节点、跨越整个数据中心连起来,协同训练同一个模型”。这一层要在规模、成本和性能之间平衡,InfiniBand 和以太网的正面交锋就发生在这里。本文讨论的“I/O 网络之争”,主要指 Scale-Out 后端网络(fabric)。理解了这层区分,就不会把“NVLink 打不打得过以太网”这种错位问题当成真问题——它们是互补的层级,而不是直接替代。
二、InfiniBand 为什么统治 AI 后端
InfiniBand 并非为 AI 而生,它最早用于高性能计算(HPC),但它的设计特性恰好命中了大规模训练的需求。
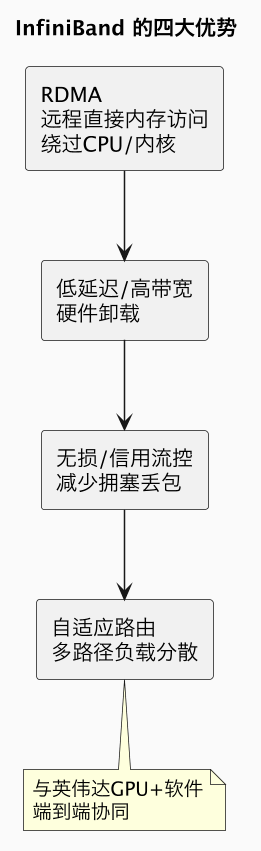
第一是 RDMA(远程直接内存访问):网卡可以直接读写远端机器的内存,数据路径绕过 CPU 和操作系统内核,省去大量协议栈开销,延迟极低、CPU 占用极少。第二是 InfiniBand 从一开始就按“无损、信用制流控”设计,网络拥塞时通过信用机制避免丢包——这点对 AI 集合通信至关重要,因为一次丢包重传就可能让大批 GPU 同时空等。第三是它的自适应路由能把流量分散到多条路径,缓解大规模集群中的热点与拥塞。
更关键的是“端到端协同”:英伟达在 2019 年收购 Mellanox 后,把 InfiniBand 网卡、交换机与自家 GPU、NVLink、CUDA、集合通信库(NCCL)和整套管理软件打通。客户买到的不是一堆零件,而是一个经过验证、调优、出问题有单一厂商负责的系统。在万卡集群这种“网络复杂度极高、容错空间极小”的场景里,这种省心本身就是巨大的价值。这也是 InfiniBand 虽贵、却长期被最前沿训练团队选择的根本原因。
三、以太网反攻:开放、规模与 UEC
以太网是数据中心和互联网的绝对主流,它的优势不在“单点最极致”,而在规模、成本、生态和开放。问题是:传统以太网是为“尽力而为、允许丢包”设计的,要承载 AI 这种对延迟和拥塞极度敏感的通信,必须补上 RDMA 和拥塞控制的课。
| 阶段 | 以太网的武器 | 解决的问题 |
|---|---|---|
| RoCE v2 | 在以太网上跑 RDMA | 获得内核旁路、低延迟 |
| 无损以太网 + DCQCN 等 | PFC、ECN 拥塞控制 | 减少丢包、缓解拥塞 |
| UEC(超以太网联盟) | 包喷射、多路径、新传输/软件栈 | 从根上改善负载均衡与尾延迟 |
第一步是 RoCE,让以太网也能做 RDMA;第二步是引入 PFC(优先级流控)和 ECN/DCQCN 等拥塞控制机制,构造“无损以太网”。这些技术让以太网在 AI 集群中逐渐可用,但 PFC 配置复杂、容易引发暂停帧扩散等问题,调优门槛高,因此在最极致的训练上仍稍逊 InfiniBand。
真正改变叙事的是 UEC(Ultra Ethernet Consortium,超以太网联盟)。它不满足于在旧 TCP/以太网之上打补丁,而是提出一套面向 AI/HPC 的新一代传输与网络规范:核心思路包括包喷射(packet spraying,把一条消息打散到多条路径并行发送)、原生多路径、基于多路径的现代拥塞控制和负载均衡,目标是在保持以太网规模与开放优势的同时,把尾延迟和链路利用率做到接近甚至优于 InfiniBand。联盟背后有博通、AMD、Arista、思科、Eviden,以及多家把“去英伟达锁定”当作战略目标的超大规模厂商。随着 UEC 1.0 规范落地、交换芯片(如博通 Tomahawk 新世代)和网卡跟进,以太网第一次拥有了“为 AI 量身重构”的体系化武器。
四、客户到底在选什么:不只是性能
技术参数之外,真正驱动这场攻防的是客户的商业与风险考量。
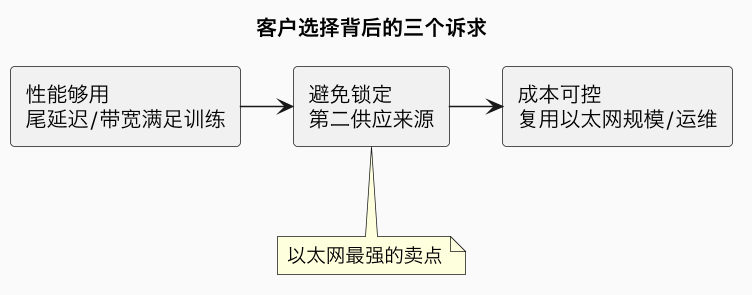
对于超大云厂和大型算力买家,单一供应商锁定是真实而沉重的风险:网络与 GPU 如果都来自英伟达,议价能力、供给安全都会受制于人。以太网提供了一条横向打通多家供应商的路——交换芯片可以选博通,交换机可以选 Arista/思科,网卡和组网有多家可选,还能复用企业内部海量的以太网运维经验、工具和人才。当以太网的性能差距缩小到“足够好”的区间,商业天平就会自然向“开放+成本+第二供应”倾斜。
这并不意味着大家会为了开放牺牲性能。更现实的决策是按负载分层:对网络最敏感、最不容忍抖动的前沿超大模型训练,仍愿意为 InfiniBand+NVLink 的确定性付溢价;而规模更大、容错和成本更敏感的推理负载,以及相当一部分训练集群,会转向开放以太网。换句话说,以太网赢的不一定是“最高端那一小撮”,而是数量最大、增长最快的中间地带——这已足以改变整个网络层的利润与格局。
五、终局:双轨分层,而非赢家通吃
综合技术与商业,最可能的结局不是某一方完胜,而是一个长期双轨、按场景分层的网络世界。
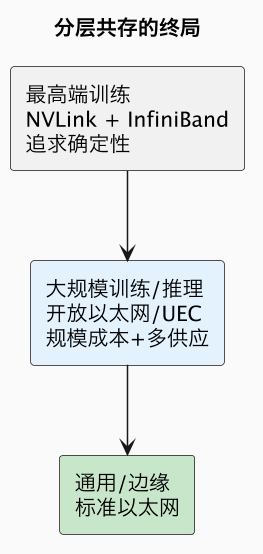
英伟达不会轻易丢掉高端——它仍在持续演进 NVLink、InfiniBand 和整柜方案,并通过软硬件协同守住最挑剔的客户;以太网阵营则会凭 UEC、规模和开放,把“AI 网络=InfiniBand”的等号逐渐擦除,吃下增长最快的主流场景。这和历史上大多数网络制式之争的规律一致:性能极致者守塔尖,开放规模者占主体,最后各据其位、长期并存。
因此,判断这一层的投资与竞争,关键不是追问“谁会赢”,而是跟踪三个指标:UEC 生态(标准、芯片、网卡)的落地速度、以太网在真实大规模训练(而不只是推理)中的表现验证,以及英伟达用新一代产品与整柜/软件锁定回应的力度。这三者的拉锯,会在未来两三年逐步划定 InfiniBand 与以太网各自的边界。
常见误区
- 误区:以太网会很快全面取代 InfiniBand。 最高端训练仍看重其确定性,更可能是以太网拿下主流增量、二者长期并存。
- 误区:InfiniBand 贵所以会被淘汰。 在万卡集群里,端到端验证、单一厂商负责和低尾延迟的价值,足以支撑其溢价。
- 误区:普通以太网直接就能跑 AI。 需要 RoCE、无损/拥塞控制乃至 UEC 新传输,配置与调优门槛并不低。
- 误区:NVLink 和以太网是直接竞争。 NVLink 是机柜内 Scale-Up,以太网是 Scale-Out,二者是互补层级。
总结
InfiniBand 靠 RDMA、无损网络和与英伟达的端到端协同守住最高端训练,而以太网携规模、开放与多供应商优势、再以 UEC 的包喷射和多路径补齐性能短板,反攻 AI 后端——终局大概率不是谁吃掉谁,而是‘高端 InfiniBand、主流以太网’双轨分层、长期共存。
相关与延伸
- 机柜内的另一半:UALink 与开放 Scale-Up
- 组网拓扑:Rail 优化胖树
- 以太网芯片主力:博通与 Marvell
- 光互联支撑:光模块 800G/1.6T