HBM 供应链深拆
一、一句话回答
HBM 不是一颗普通内存,而是一条高度协同、多环相扣的供应链的产物,任何一环卡住,整块高端 AI 加速卡就交付不了。它的链路大致是:存储厂先做出合格的 DRAM 裸片,在裸片上打出密集的 TSV 垂直通孔,把多层裸片精确堆叠、通过微凸点/混合键合连起来,堆叠底部再加一层逻辑基底裸片(负责与外部接口),形成一个完整的 HBM 堆栈;随后这些 HBM 堆栈并不是单独卖给用户,而是和 GPU 裸片一起,交给台积电等封进 CoWoS 这类 2.5D 封装——多颗 HBM 围在 GPU 四周、焊到同一块硅中介层上。因此 HBM 的供给要同时满足三个条件:存储厂的多层堆叠良率、封装厂的 CoWoS 产能、以及键合/测试设备的供给,是「封装拉动、认证锁定」的产品。客户结构上,SK 海力士凭先发和与英伟达的深度认证领先,三星和美光全力追赶,而主流 AI 加速器厂通常要对 HBM 做严格认证、一旦定型就深度绑定,并通过预付、长单去锁定稀缺产能。正因为扩产需要存储厂、封装厂、设备厂甚至基板厂同步投资,HBM 的供给曲线很难短时间快速拉起,长期处于偏紧、溢价状态。中国在标准 DRAM 上持续追赶,但 HBM 所需的先进 DRAM、TSV、键合与 CoWoS 生态叠加,差距比单一品类更大。
为什么从供应链看 HBM。HBM 的核心矛盾不在「能不能设计」,而在多厂商协同下的良率与产能,谁锁住这条链,谁才拿得到 AI 芯片产能。
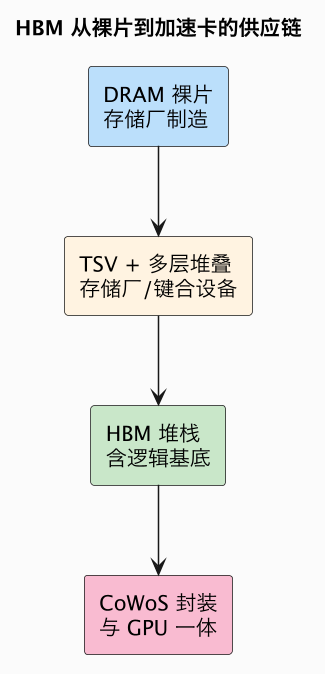
二、链条上的每一道约束
HBM 的每一层堆叠都引入额外良率损耗:层数越多,对单层裸片质量和键合对准要求越高,任何一层出问题都可能使整个堆栈报废。除了堆叠本身,还要有合格的逻辑基底裸片、高带宽中介层布线、高可靠测试与散热设计,这些分别由不同供应商承担。
| 环节 | 关键供给方 | 约束 |
|---|---|---|
| 先进 DRAM 裸片 | 三大存储厂 | 工艺、良率、EUV |
| TSV/堆叠/键合 | 存储厂 + Besi/EVG/ASMPT | 设备产能、精度 |
| 逻辑基底 | 存储厂/代工 | 接口与测试 |
| CoWoS 中介层 | 台积电等 | 2.5D 产能 |
| 认证/绑定 | 英伟达等加速器厂 | 周期长、份额锁定 |
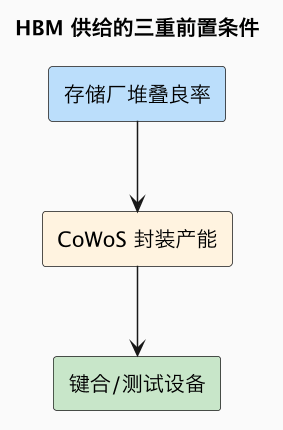
三、客户绑定、分配与国产化
HBM 的分配带有明显的「认证 + 长协」特征。AI 加速器厂出于性能和可靠性,会和某一家存储厂共同定义、长时间验证,定型后短期不会轻易切换,先发者因此占据份额优势。为保障供给,大客户普遍通过预付款、多年协议和共同投资的方式锁定 HBM 与 CoWoS 产能,后来者要抢到产能并不容易。
- 瓶颈叠加:即便存储厂做出更多 HBM,若 CoWoS 或键合机不足,仍无法变成可出货的加速卡。
- 良率经济:HBM 存在可用位宽/堆栈良率问题,实际有效产能比晶圆投入看起来更紧。
- 中国处境:HBM 同时要求先进 DRAM 工艺、TSV、高端键合与先进封装生态,多重门槛叠加,短期内难以形成有竞争力的供应。
节点速览:技术 / 玩家 / 成熟度 / 预期
数据截止 2026-09。标尺说明见 AI 产业链总览。
| 象限 | 要点 |
|---|---|
| 关键技术 | ① 多层 TSV 堆叠(TRL-3~4)② HBM 与 CoWoS 集成(TRL-4)③ 更高层数/混合键合 HBM(TRL-2~3) |
| 主要玩家 | SK海力士(领先)、三星、美光;封装:台积电;设备:Besi/EVG/ASMPT |
| 做到什么程度 | 供给偏紧、认证锁定、客户预付锁产能;中国差距明显 |
| 后续预期 | 6 个月:HBM 维持紧缺(高);18 个月:层数与产能提升、份额追赶(中);36 个月:国产化仍难、瓶颈缓解(中) |
常见误区
- 以为 HBM 就是普通内存多叠几层:它是存储、封装、设备多链协同的系统产品。
- 只看存储厂产能:CoWoS 和键合设备是同样硬的瓶颈。
- 认为可在市场随意采购:它靠认证和长协分配,新客户难抢。
- 低估中国 HBM 难度:比单一标准 DRAM 的门槛叠加得更多。
总结
HBM 要穿过先进 DRAM 裸片、TSV、多层堆叠键合、逻辑基底,再与 GPU 一起封进 CoWoS 才能成为可出货产品,供给同时受制于存储厂良率、封装产能和键合测试设备,三大存储厂借认证与长协被深度绑定、客户以预付锁产能,长期偏紧溢价;中国面临多环节叠加门槛——它说明 AI 时代最稀缺的不是单个元件,而是一条被精密组织、难以快速复制的协同供应链。