深度学习框架史
先说结论
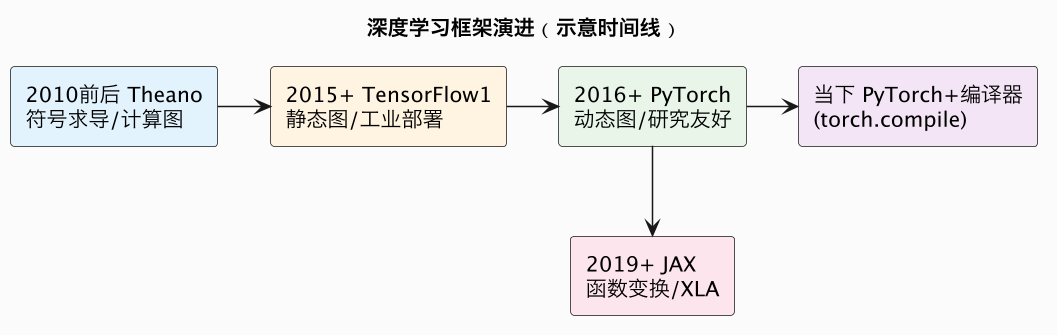
- 框架解决三件事:自动求导(不用手写反向传播)、把计算映射到 GPU/TPU、提供可复用的算子与生态。
- 主线是“易用性”和“性能”的钟摆:静态图性能好但反直觉,动态图(define-by-run)贴合普通 Python、调试友好;PyTorch 靠动态图赢得研究者,再用编译器把性能补回来。
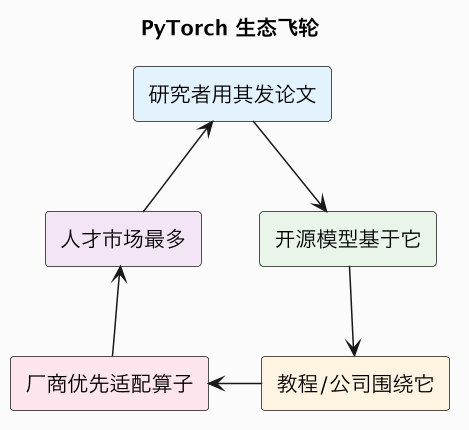
- 胜负往往不在技术单点,而在生态飞轮:研究者用它发论文 → 开源模型基于它 → 工程师和教程都围绕它 → 事实标准形成。
- JAX 代表另一种哲学:一切都是可组合的函数变换,极致、函数式、适合大规模与研究,但生态与工业落地不及 PyTorch 普及。
一、静态图 vs 动态图
| 维度 | 静态图(TF1) | 动态图(PyTorch) |
|---|---|---|
| 执行方式 | 先建图再运行 | 写一行算一行 |
| 调试 | 难(图期/运行期分离) | 像普通 Python |
| 优化 | 便于全局编译优化 | 运行时才知道图 |
| 部署 | 图可序列化、成熟 | 早期较弱,后补齐 |
| 研究体验 | 笨重 | 灵活直观 |
二、PyTorch 为什么赢
- define-by-run:前向代码即普通 Python,反向由自动微分自动构建,心智负担低;
- 贴近研究节奏:快速试验、易调试,论文复现门槛低;
- 生态正循环:大量开源模型用 PyTorch 写成,Hugging Face 等生态加持;
- 后期补性能:TorchScript → TorchDynamo/Inductor(torch.compile)把动态图捕获后交给编译器优化,兼顾易用与速度。
三、JAX:函数变换的另一条路
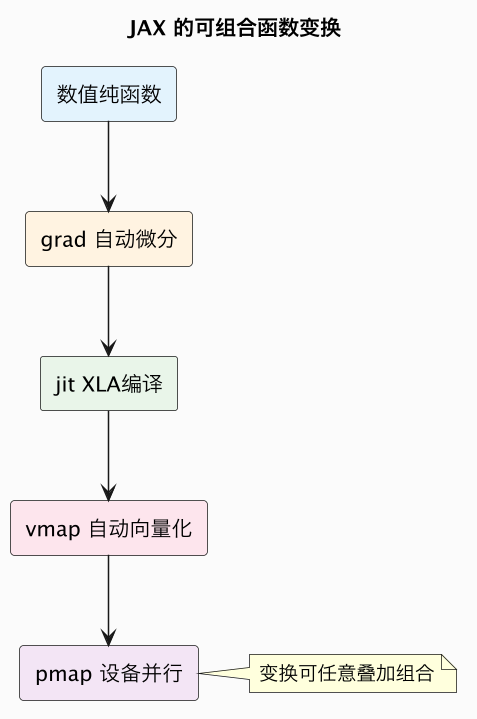
JAX 的核心是把数值程序看成可被一组函数变换处理的对象:
grad:自动微分;jit:JIT 编译(XLA);vmap:自动向量化;pmap/shard_map:自动设备并行。
这些变换可任意组合,表达力强、性能高,在前沿研究(尤其与 TPU/XLA 结合)中很受欢迎。代价是函数式约束(少副作用)、调试和工程化门槛、生态相对小众。
四、为什么“编译器”又回来了
动态图赢了易用性,但工业界仍要静态图的性能,于是方案不是回退,而是在动态图之上做捕获+编译:
- 先让用户用自然的 eager 方式写;
- 运行时/追踪时把图捕获(如 TorchDynamo 从字节码层面捕获);
- 交给编译器(XLA、Inductor、MLIR 系)做融合、布局和代码生成;
- 这与更广义的 AI 编译器栈(TVM/MLIR/Triton)连成一体。
五、框架格局对产业的含义
- 事实标准降低全行业成本:模型、算子、教程、人才围绕统一栈流动;
- 硬件厂商必须适配主流框架:新芯片想被用,先得让 PyTorch 程序跑得好;
- 开放治理受关注:框架被单一公司控制会引发治理担忧,PyTorch 转交中立基金会模式是行业一次制度探索;
- 平台风险:掌握框架的一方在标准演进上有巨大话语权。
六、深度专题:静态图与动态图的“易用性-性能”钟摆
框架之争的核心,是一场在开发者体验和执行性能之间反复摆动的钟摆。要看懂今天的格局,需要把这条钟摆的每一次摆动和背后的技术约束讲透。
1. 静态图:先“搭好电路”,再通电
在 TensorFlow1 代表的静态图范式里,用户先描述整张计算图(节点是算子、边是张量),框架拿到完整图后再统一编译、优化、执行。它的优点非常工程化:
- 全局可见:编译器能看到所有算子和依赖,做常量折叠、算子融合、内存复用、设备放置等全局优化;
- 可序列化部署:图可以导出成文件,交给独立的轻量运行时在服务器/移动端执行,训练与部署解耦;
- 天然适合分布式:完整图便于自动切分到多设备。
代价是反直觉:图的“构建期”和“运行期”分离,普通 Python 的 if、for、print 不按预期工作,报错信息指向图而非源码,调试像在操作一台还没通电的复杂机器。对需要频繁试错的研究者,这种心智负担极重。
2. 动态图:define-by-run,写一行算一行
PyTorch 把范式翻转:前向计算就是普通 Python 命令,立即执行;反向传播由自动微分系统在前向运行时记录、事后构建。好处是:
- 可立即看到中间结果,用普通断点、print 调试;
- 控制流天然动态:数据决定执行哪条分支,无需特殊“图内 if”;
- 学习曲线接近 numpy/Python,研究迭代飞快。
代价是运行前没有完整图,全局优化困难:框架难以提前融合算子或复用内存,早期部署工具也较弱。
3. 钟摆再次回摆:在动态图上“找回静态图”
业界并没有在“易用 vs 性能”里二选一,而是发展出两全方案:让用户用自然的 eager/dynamic 方式开发,再在需要性能时捕获计算图、交给编译器。
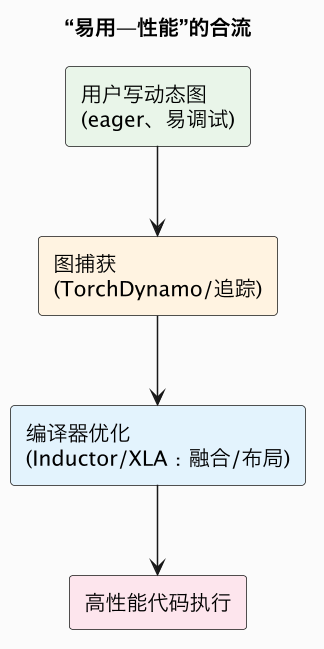
这解释了为什么“静态图已死”是误读——静态图的优化思想以 graph capture + JIT compile 的形式,叠加在动态图之上回归;用户既能用 Python 直觉开发,又能在发布时拿到接近静态图的性能。钟摆不是来回摆,而是最终收敛到“前端动态、后端静态编译”的分层结构。
七、生态飞轮:为什么框架胜负由“网络效应”决定
技术特性只能解释一部分,真正让 PyTorch 拉开差距的是一个自我强化的生态飞轮,类似操作系统或编程语言的竞争:
| 环节 | 机制 |
|---|---|
| 研究者采用 | 易用、易复现 → 更多论文用 PyTorch |
| 开源模型 | 新模型默认 PyTorch 实现 |
| 工程与教程 | 公司、课程、书籍围绕主流框架 |
| 算子与硬件 | 厂商优先适配,算子库更全 |
| 人才市场 | 会 PyTorch 的人最多,招聘风险最低 |
| 回到研究者 | 新人按生态主流学习,循环加固 |
一旦飞轮转起来,即使对手在某个技术点上追平甚至超越,也很难撼动事实标准——因为迁移的不只是代码,还有模型资产、肌肉记忆、团队招聘和供应链。框架之争因此更像“平台竞争”而非单点功能竞赛,这也是社区高度关注治理(避免单一公司控制事实标准)的原因。
八、JAX 与函数式路线:为什么“更好”不等于“更普及”
JAX 在很多资深研究者眼中是更优雅、更强的设计,但它没有取代 PyTorch,这本身就是理解技术扩散的好案例。
- 优势真实:
grad/jit/vmap/pmap等可组合变换,让自动微分、向量化、设备并行都成为可任意叠加的纯函数变换;配合 XLA 在 TPU/大批量场景性能出色,研究表达力强。 - 门槛也真实:要求函数式思维(避免副作用、外部状态)、数组/随机数显式传递,调试体验与“写普通 Python”不同;工业生态、岗位供给和现成模型库不及 PyTorch。
- 结论:技术上“更优”的工具,如果学习范式、生态位置和迁移成本不利,往往会占据一个高价值但相对小众的位置,而非成为大众标准。JAX 强在前沿研究、TPU 生态和需要极致组合变换的团队,PyTorch 强在最大公约数的工业与研究落地。
九、自动微分:框架最底层也最关键的能力
所有框架的立身之本是自动微分(autodiff)——它决定了“不用手写反向传播”,从而让深度学习可规模化。厘清它的原理,能看懂框架设计的很多取舍。
1. 三种求导方式的区别
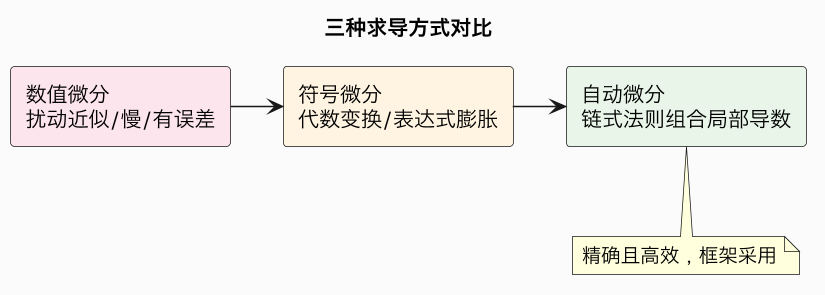
- 数值微分:用微小扰动近似导数,简单但慢、且有数值误差,只适合校验;
- 符号微分:对数学表达式做代数变换,精确但会产生表达式膨胀;
- 自动微分:把复杂计算分解成一系列基本运算(加减乘除、初等函数),利用链式法则逐段组合局部导数,既精确又高效。深度学习框架用的正是它。
2. 前向模式 vs 反向模式
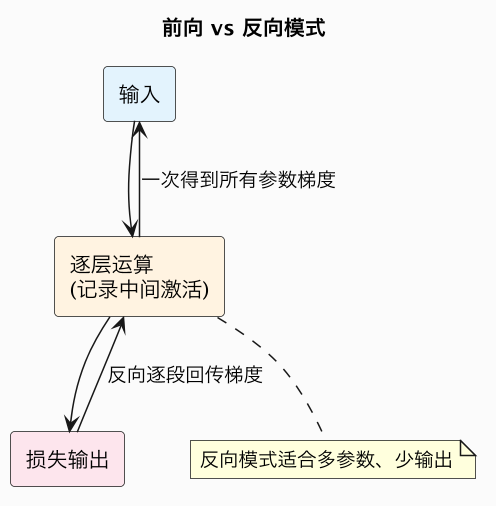
- 前向模式沿计算方向逐段传导数,适合“输入少、输出多”;
- **反向模式(backpropagation)**先前向算出结果并记录,再从输出往回传梯度,特别适合“海量参数、少数损失输出”的神经网络——一次反向传播即可算出所有参数梯度,这是深度学习能扩展到亿万参数的关键。
3. 计算图的真正由来
动态图在前向执行时记录的“磁带/图”,本质就是为反向模式自动微分服务的依赖记录。这解释了为什么 define-by-run 既带来易用性、也要求框架高效管理中间状态(为反向传播保存的激活值),并催生梯度检查点(gradient checkpointing)这类用重算换显存的技术。
十、分布式训练 API:框架如何隐藏并行复杂性
随着单卡装不下模型和数据,框架的另一大价值是提供从单机到万卡的抽象:数据并行、张量并行、流水线并行、ZeRO、以及各种并行编排。用户在框架层表达并行、由后端插入通信与切分。
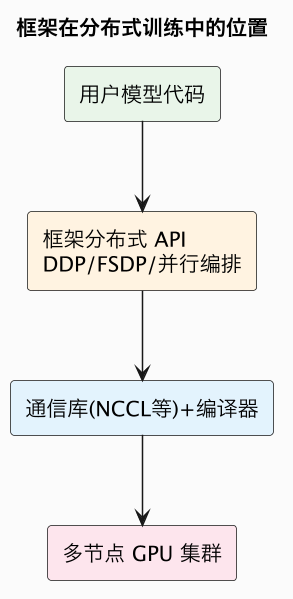
趋势是把越来越复杂的并行(3D/4D、序列并行、专家并行)做成高层、半自动甚至编译器自动的能力,让算法工程师不必手写底层通信。这也使框架与 Megatron、DeepSpeed、AI 编译器等系统层深度耦合,成为整条训练软件栈的“总入口”。框架的竞争因此不仅是写模型的体验,更是谁能把“单机原型 → 万卡生产”这条路径做得最顺、性能损失最小。
十一、给读者的判断框架
- 评价框架,分三层看:写模型的体验、跑大规模的性能、生态(模型/算子/人才)规模,三者缺一不可。
- 判断“静态还是动态”,记住终局是“前端动态、后端静态编译”的合流,而非互相取代。
- 选型时尊重生态位:PyTorch 适合最大公约数的工业落地,JAX 适合偏好函数式与 TPU/极致研究的团队。
- 关注治理:事实标准被谁控制、是否中立,会影响整个行业的成本与风险。
框架之争表面是语法与性能之争,实质是平台与生态之争;它看似只是开发者每天 import 的库,实则是 AI 软件栈上承模型、下接硬件的关键枢纽,其走向决定了整条产业链的协作成本。
常见误区
- 以为静态图已彻底过时:它的思想以图捕获+编译的形式回归。
- 只凭语法喜好判断框架成败:生态飞轮才是决定性因素。
- 把 JAX 当 PyTorch 的简单替代:范式(函数式)和生态不同。
- 忽视框架对硬件选型的反向影响:框架支持度影响芯片生死。
- 认为框架之争已经“终局”:上层 Agent/编译器与新硬件仍可能带来变量。
总结
深度学习框架沿“符号求导(Theano)→静态图工业(TF1)→动态图易用(PyTorch)→函数变换(JAX)”演进,核心矛盾是易用性与性能的钟摆;PyTorch 以 define-by-run 和生态飞轮胜出,再用图捕获与编译器(torch.compile/XLA)补回性能。框架不仅是工具,更是模型、硬件与人才汇聚的事实标准,其治理与走向深刻影响整条 AI 软件栈。