UALink:英伟达 NVLink 之外,「机柜内开放总线」联盟
最后更新:2026-09-19|数据截止 2026 年中:UALink 规范以联盟官方进展为准,本文讲联盟目标、产业逻辑与技术定位,不引用未经证实的速率与时间表。
本文是产业观察,回答:当网络层的以太网在 Scale-Out 反扑英伟达时,机柜内 GPU 直连这道最深的护城河,能不能也被一个开放联盟撬开。 万卡集群组网 区分了 Scale-Up 与 Scale-Out,InfiniBand 与以太网 讲了机柜间那层;本文专讲机柜内 Scale-Up 总线的开放化尝试——UALink(Ultra Accelerator Link)。
先说结论
- 机柜内 Scale-Up 互连是英伟达最深、最难替代的护城河。 NVLink/NVSwitch 在机柜内提供极高带宽、统一显存语义和成熟软件,让一柜 GPU 像一台超级计算机;这比 Scale-Out 网络更专有、对性能更关键。
- UALink 是「反 NVLink」的开放联盟。 由 AMD、博通、思科、英特尔、谷歌、Meta、微软、惠普等发起,目标是制定开放、高带宽的加速器 Scale-Up 互连规范,让多家芯片和系统能在机柜内高速互联,打破单一私有生态。
- 它与超以太网(UEC)分工互补,不重叠。 UALink 解决机柜内、少量加速器的紧耦合(Scale-Up),Ultra Ethernet 解决大规模机柜间互联(Scale-Out),两者合起来才构成对标英伟达「NVLink + IB」的完整开放栈。
- 技术与生态落地都很难,节奏会慢于以太网反攻。 机柜内对带宽密度、延迟、内存一致性和软件栈要求极致,开放规范还要跨多家芯片互联,标准化—产品—部署链条长,短期内难撼 NVLink。
一句话:UALink 是开放阵营对英伟达最后一道、也是最硬一道互连护城河发起的冲锋——它想把机柜内总线从私有变成多供应商标准;方向正确、阵容豪华,但机柜内互连的物理极限和软件一致性决定了这是一场以多年计的硬仗,成败取决于谁先拿出大规模真实部署。
一、Scale-Up 为什么比 Scale-Out 更难撬
在 万卡集群组网 里我们把集群网络分两层:
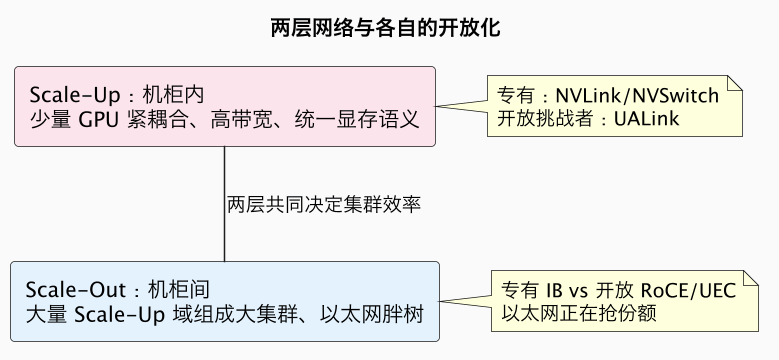
Scale-Up 的特殊性在于:
- 带宽密度极致:同柜 GPU 之间要以极高速率直传,铜缆、背板/交换芯片、封装到封装的链路都逼近物理极限(见 光模块篇 关于铜缆与光的取舍)。
- 内存与编程语义:Scale-Up 域往往需要近统一内存、低延迟一致性访问,软件栈(集合通信库、拓扑感知、显存池化)深度耦合硬件。
- 紧耦合放大短板:几十上百颗 GPU 像一台机器协同,任何链路或协议的不一致都直接拖累整体。
正因如此,英伟达把最强的系统能力放在这一层:NVLink 提供远超普通网卡的 GPU 间带宽,NVSwitch 实现柜内全互联,配合整套软件让一柜成为紧耦合单元。这比 Scale-Out 的 IB 更难替代——Scale-Out 以太网化已经在推进(见 IB 与以太网),而 Scale-Up 的开放标准此前基本缺位,UALink 正是来补这个缺口。
二、UALink 联盟要做什么
UALink(Ultra Accelerator Link,超级加速器链路)是一个开放技术联盟,目标是为加速器(GPU/ASIC 等)之间的 Scale-Up 互连制定开放、高带宽、低延迟的物理与协议规范,让来自不同厂商的加速器能在同一机柜/机架内高速、低延迟地组成 Scale-Up 域,而不必都采用某一家的私有总线。
其发起与推动力量几乎是「英伟达之外的所有重要玩家」集合:芯片侧 AMD、英特尔、博通,系统/网络侧思科、惠普(HPE)、Arista 等,需求侧谷歌、Meta、微软等超大规模客户。这个阵容本身就说明问题——这是买方(云厂)联合卖方(英伟达竞争对手)共同推动的去锁定标准。
联盟逻辑与三条历史经验一脉相承:
- 买方驱动的标准更有生命力:超大规模客户有真实的大规模采购和反锁定诉求(同 云厂自研 ASIC 的动机);
- 需要一个中立、可共同实现的规范:多家芯片公司不愿把 Scale-Up 命脉交给竞争对手的私有协议;
- 开放能做大生态:对标以太网在 Scale-Out 的成功,希望在 Scale-Up 复制「标准—多供应商—成本下降」的路径。
三、UALink 与超以太网:一张开放栈的两半
外界常把 UALink 与超以太网联盟(UEC)混为一谈,实则分工明确、互补成套:
| 维度 | UALink | Ultra Ethernet(UEC) |
|---|---|---|
| 层次 | Scale-Up(机柜/机架内) | Scale-Out(机柜间/集群级) |
| 规模 | 少量到一批加速器紧耦合 | 上万端点大尺度互联 |
| 对标对象 | NVLink/NVSwitch | InfiniBand + 传统以太网 |
| 核心诉求 | 极高带宽、内存语义、低延迟 | 开放、多供应商、拥塞控制、规模 |
两者合起来,才构成对标英伟达「NVLink(Scale-Up)+ InfiniBand(Scale-Out)」的完整开放体系:机柜内用 UALink 把多家加速器连成紧耦合域,机柜间用超以太网把这些域连成万卡集群。缺了任何一半,开放阵营都只能在英伟达护城河的一侧作战。这也是为什么芯片公司、系统商和云厂往往同时出现在两个联盟里。
需要注意它与 CXL 的关系:CXL 解决的是 CPU—设备、内存扩展式的一致性互连,规模和定位偏 CPU 生态;UALink 面向大规模加速器 Scale-Up 做更激进的带宽和拓扑设计,二者更多互补而非直接替代。
四、为什么这是一场以年计的硬仗
方向正确、阵容豪华,不等于短期能赢。Scale-Up 开放化有四道难关:
- 物理层极限:在机柜尺度做到对标 NVLink 的带宽密度和能效,涉及高速 SerDes、信号完整性、铜缆/光的选择(见 光模块与铜缆),工程门槛高。
- 跨厂商一致性:开放规范要让不同厂商、不同代际加速器在同一总线下可靠互联、共享内存语义,互操作测试和协议一致性极复杂。
- 软件栈最难:硬件标准可以写,软件体验难抄。集合通信、拓扑感知调度、显存池化、故障处理都要在多厂商硬件上做到接近 NVLink 的成熟度——这与 CUDA 护城河 是同一类生态壁垒,只是在互连层。
- 先发与迭代速度:英伟达软硬一体、每年迭代,开放联盟需要协调多方、达成共识、再各自实现,节奏天然更慢,且面临「规范定稿即落后一代」的风险。
因此理性预期是:UALink 首先在反锁定意愿最强、有自研芯片和系统工程能力的超大规模客户那里落地(谷歌、Meta、微软等本就是成员),用其内部大规模需求支撑早期生态;再随多供应商产品成熟向更广泛市场扩散。这与云厂自研 ASIC、开放以太网走的是同一条「买方先行」路径。
五、变量与置信度判断
| 变量 | 作用方向 | 时间窗 | 置信度 |
|---|---|---|---|
| 超大规模客户反锁定意愿 | 推动 UALink 落地 | 持续 | 高 |
| 规范定稿与多厂商互操作 | 决定能否商用 | 2~4 年 | 中高 |
| 配套软件栈成熟度 | 决定能否替代 NVLink | 3~5 年+ | 中 |
| 英伟达 NVLink 快速迭代 | 拉大追赶差距 | 持续 | 高 |
| 与 UEC 协同的整机方案 | 形成完整开放栈 | 3~5 年 | 中 |
- 未来 1~3 年(高置信度):NVLink/NVSwitch 仍是 Scale-Up 事实标准和最稳妥选择;UALink 完成规范、出现首批成员产品和灯塔部署,主要由联盟内超大规模客户牵引。
- 未来 3~5 年(中置信度):UALink + 超以太网的开放整机柜方案在部分大规模、成本/反锁定敏感的集群落地,成为英伟达体系之外可信但未必等价的选项。
- 长期(中置信度):开放 Scale-Up 会切走一块份额,尤其在云厂自研芯片生态内,但英伟达凭软硬一体迭代速度守住前沿与高端;格局类似 Scale-Out——走向开放多供应商,但领导者仍能在开放生态中赚钱。
六、对不同角色,这意味着什么
- 对 AMD/英特尔/博通等芯片商:UALink 提供了不依赖竞争对手私有总线、把自家加速器卖进开放机柜的入场券,是与英伟达系统竞争的必要拼图。
- 对云厂:可在自研/多供应商加速器之上构建开放 Scale-Up 域,增强议价与供应安全,但要承担早期软件与互操作成本。
- 对系统/网络设备商:开放 Scale-Up 交换机、机柜、线缆(铜/光)和配套软件是新增量市场。
- 对软件平台团队:若要从 NVLink 迁移,集合通信库、拓扑调度和显存管理是重点验证项,不能只看带宽参数。
延伸观察:Scale-Up 为什么是「整机柜时代」的胜负手
AI 基础设施的竞争单元,正在从「单张加速卡」上移到「整机柜甚至多柜紧耦合系统」。在这个尺度上,Scale-Up 总线决定了一个机柜内数十到上百颗加速器能不能像一台巨型计算机一样协同,它的重要性甚至超过单卡峰值算力。原因在于大模型训练的通信特征:张量并行和部分流水线并行要求 GPU 之间在每一个训练步都进行高频、大量、低延迟的数据交换,这类通信一旦跨出机柜、走普通 Scale-Out 网络,延迟和带宽都会成为瓶颈;只有把高频通信限制在机柜内的高带宽域里,才能让超大模型的并行切分真正高效。
这带来一个直接后果:谁定义了机柜内总线,谁就定义了 AI 系统的最小完整单元。英伟达的整机柜产品之所以有冲击力,不只是把 GPU 打包,而是用 NVLink/NVSwitch 把柜内算力、显存、供电(见电源相关篇)和网络做成一个经过整体验证、客户开箱即可部署的「产品」。对客户而言,这降低了集成风险、缩短了上线时间;对英伟达而言,这把竞争从可替换的板卡,提升到了难以拆分的系统,显著加深了锁定。这也正是 UALink 联盟要打破的东西——一旦柜内总线是开放标准,多家加速器就能在同一种机柜里互联,系统集成权就会从单一芯片商外溢到 ODM、系统厂和云厂手中。
然而开放 Scale-Up 的难度,本质上比开放 Scale-Out 高一个数量级。Scale-Out 连接的是相对独立的节点,节点内部无论什么硬件,只要遵守网络协议就能互通;Scale-Up 却试图让不同厂商的加速器共享近乎一致的高带宽内存语义和故障模型,这触及芯片最核心的微架构。不同厂商的内存层次、缓存一致性策略、算力配比和软件栈本就不同,要在一条开放总线上做到「换一家芯片,上层软件几乎无感」,协议必须在性能和通用性之间艰难取舍,还要解决多代硬件混插、故障隔离、拥塞公平性等大量工程细节。标准谈判桌上每一个技术选择,都是各家芯片架构妥协的结果。
从落地路径看,UALink 更可能先在**「云厂自研芯片 + 特定加速器伙伴」的封闭但标准化的小生态**里跑通,而不是立刻成为任意芯片随意混搭的开放集市。谷歌、Meta、微软等成员本身有大规模自研 ASIC(见 云厂自研 ASIC),它们最现实的诉求,是让自研芯片和 AMD 等第三方加速器能在统一柜内总线上组合,摆脱对英伟达 NVLink 的依赖。先在这些自有大负载里证明稳定性和成本,再逐步吸引更广泛的系统和芯片厂商,是开放标准一贯的扩散曲线。标准的成败,最终取决于第一个真正大规模生产环境的标杆部署,而不是规范文档本身。
对投资者和观察者,判断这场竞争有个实用的视角:Scale-Up 看「机柜」,Scale-Out 看「集群」。英伟达在机柜级软硬一体上领先一到两个身位,且迭代极快;开放阵营在集群级以太网上已成效显著,在机柜级则刚起步。未来三五年最可能的格局,是高端前沿训练继续采用紧耦合专有机柜,而大规模推理、成本敏感训练和云厂自研生态采用开放 Scale-Up + 开放 Scale-Out 的组合。两条路线长期共存,开放标准慢慢抬高「多供应商可组装系统」的水位线,但很难在短期内抹平整机柜系统的工程护城河。
要判断 UALink 的前景,可以参考历史上开放标准挑战事实标准的几条经验规律。其一是「买方联盟往往能成,但成得慢」:当足够多的大买家有强烈的反锁定动机,且它们自身就是技术能力极强的公司时,开放标准几乎必然出现,PCIe、CXL、以太网本身都是类似力量的产物;但从规范、多厂商互操作到规模部署,通常要经历三到五年甚至更久,期间事实标准会持续拉开身位。其二是「开放标准常在性能上先落后、在生态和成本上反超」:第一代开放方案的峰值性能往往不及同期专有旗舰,但它凭借多供应商带来的价格竞争、规模效应和不被锁定的确定性,逐步在大规模、成本敏感的部署中占优,最终把专有方案挤到高端利基。UALink 很可能重演这一曲线——先在云厂自研生态和成本敏感集群立足,而非一开始就在极限性能上对标。
其三是「分层兼容比全面替代更现实」。业界不会出现一夜之间所有机柜都换成开放总线的局面,更可能的是一个长期异构共存的世界:最前沿训练采用成熟的紧耦合专有机柜,部分训练和大规模推理采用开放 Scale-Up,边缘和小集群继续用更简单的网络。UALink 要被广泛接受,关键是能否在协议设计上与上层软件解耦、与既有集群管理和编程模型兼容,让迁移是渐进的。其四是「软件成熟度决定标准生命周期」。硬件接口规范相对容易达成,真正决定开放总线能否用起来的,是多厂商一致的集合通信库、拓扑感知调度、故障管理和性能调优工具——这些需要大量真实部署打磨,也恰恰是英伟达最深厚的资产。
从中国产业的视角,开放总线标准还带来一层特殊意义。在加速器供应链受限的背景下,一个不被单一厂商控制的 Scale-Up 标准,为国产加速器、交换芯片和系统厂商提供了参与机柜级系统的接口和机会,有利于构建多供应商、可替换的国产智算整机生态。但机会不等于自动兑现:国内厂商同样要面对高速 SerDes、交换芯片、软件一致性等硬门槛,且在标准中的技术话语权需要通过实际贡献来争取。可以预见,开放 Scale-Up 标准会成为观察「AI 系统层是否走向多极化」的一个关键风向标——如果它成功,AI 硬件的利润池会从单一系统巨头向更多芯片、网络和 ODM 玩家分散;如果它进展缓慢,则说明整机柜级软硬一体的护城河,比许多人预期的还要深。
结语:撬开最后一道护城河的联盟
英伟达的护城河有两道:Scale-Out 的 InfiniBand,和更深的 Scale-Up 的 NVLink。以太网和超以太网已经在前者持续攻城拔寨,UALink 则是开放阵营对后者发起的、姗姗来迟但阵容齐整的冲锋——AMD、博通、英特尔等芯片商,思科、惠普等系统商,谷歌、Meta、微软等最大买方齐聚,目标是把机柜内最核心的加速器总线从私有变成开放标准。它和 UEC 一内一外,共同拼出对标「NVLink + IB」的开放栈。但机柜内互连逼近物理极限、跨厂商一致性和软件栈生态比写一份规范难得多,决定了这是一场以多年计、由超大规模买方先行托底的硬仗。方向几乎必然,速度却要保持耐心——标准能定义带宽,却不能一夜之间复制英伟达软硬一体的迭代飞轮。
数据口径与延伸
- 数据口径:UALink 的定位(开放 Scale-Up 加速器互连)、发起成员构成、与 Ultra Ethernet/UEC 的分工、与 CXL 的区别及落地难点,来自联盟公开信息、标准组织资料与公开产业分析。具体速率、规范版本、产品时间表以官方为准,本文不引用未经证实的数字。数据截止 2026 年中。
- 相关产业观察:万卡集群组网、InfiniBand 与以太网、800G/1.6T 光模块、云厂自研 ASIC、CUDA 护城河。
- 同批待写延伸:网络交换芯片国产化(D5)、DCI 光网络(D6)、超节点之争(D10)。
一句话总结:Scale-Up 机柜内互连(NVLink/NVSwitch 提供的极高带宽、统一显存语义与成熟软件)是英伟达比 Scale-Out 更深的护城河,UALink 正是 AMD、博通、英特尔、思科、惠普及谷歌、Meta、微软等「英伟达之外全体重要玩家」组建的开放联盟,旨在为多厂商加速器制定高带宽低延迟的机柜内 Scale-Up 总线标准;它与主打机柜间 Scale-Out 的超以太网 UEC 一内一外互补,共同拼出对标「NVLink + InfiniBand」的完整开放栈;但机柜内互连逼近物理层极限、跨厂商互操作一致性和最难的集合通信/显存/调度软件栈都需要多年打磨,加上英伟达软硬一体快速迭代,UALink 短期难撼 NVLink,更现实的路径是由反锁定意愿最强、自身有芯片和系统能力的超大规模成员先做灯塔部署,再随多供应商成熟外溢——方向是开放化,节奏会显著慢于 Scale-Out 的以太网反攻。