博通与 Marvell:自研 AI ASIC 热潮背后的隐形巨头
数据截止 2026-09。上游承接自研 ASIC 趋势,关联交换芯片与网络、硅光与 CPO。
英伟达是 AI 芯片舞台上当之无愧的主角,但在它身后,有两家不那么张扬、却几乎“哪里有自研 AI 芯片、哪里就有它们”的公司——博通(Broadcom)和 Marvell。 谷歌、Meta、字节这些想摆脱单一 GPU 依赖、自研 AI 加速器的巨头,绝大多数并不具备从架构到物理实现、再到量产的全套芯片工程能力;而博通和 Marvell 提供的,正是“你定义需求,我替你把芯片设计出来、并保证能在台积电量产”的整套服务。它们不与客户争夺品牌,却深度嵌入了客户最核心的算力规划。
先说结论
- 云厂商自研 ASIC 的热潮,本质上是把需求外包给了具备全流程定制设计能力的博通和 Marvell——客户拥有芯片与定义权,博通/Marvell 出售稀缺的工程实现能力与 IP。
- 博通是这一模式的绝对龙头,靠**定制 AI 加速器(如深度参与谷歌 TPU 等大单)+ 以太网交换芯片(Tomahawk/Jericho)**形成“算力+网络”双卡位,是英伟达之外网络侧最强的一极。
- Marvell 是更激进的追赶者,重心放在定制 AI 芯片、光 DSP、电互联(DSP/重定时)和存储/网络定制,弹性大但客户集中度同样高。
- 这是典型的“卖铲子”生意:无论最终哪朵云、哪种架构胜出,只要自研 ASIC 的渗透率上升,它们都受益;但代价是收入高度依赖少数超大客户,订单波动与客户自研节奏会被放大。
- 关键风险是议价权与客户绑定的博弈:客户既离不开它们的工程能力,又刻意扶持第二供应商(让博通、Marvell 互相制衡),二者之间的竞争会长期存在。
节点速览:技术 / 玩家 / 成熟度 / 预期
数据截止 2026-09。标尺说明见 AI 产业链总览。
| 象限 | 要点 |
|---|---|
| 关键技术 | ① AI ASIC 全流程定制设计与量产(TRL-4)② 高带宽 SerDes/片间互联 IP(TRL-4)③ 以太网交换芯片(Tomahawk/Jericho,TRL-4~5)④ 光 DSP/电互联与 CPO(TRL-3~4) |
| 主要玩家 | 博通(定制+网络双龙头)、Marvell(定制+光 DSP 追赶);客户:谷歌、Meta、字节等超大厂商;间接竞争者:英伟达、自研团队、Alchip/世芯等设计服务 |
| 做到什么程度 | 博通已深度绑定多个超大客户的 AI ASIC 世代,网络芯片在 AI 以太网中份额领先;Marvell 拿下多个定制与互联设计订单,快速放量但体量仍小一档 |
一、什么叫“替别人造芯片”:ASIC 定制模式
先厘清一个容易混淆的概念。博通、Marvell 在这里做的,不是卖一颗自己品牌的现成芯片,而是提供 ASIC(专用集成电路)定制服务。
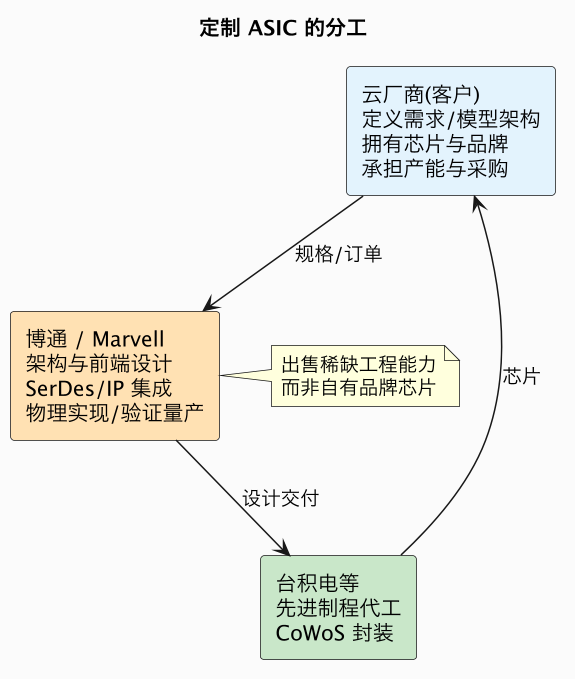
为什么谷歌、Meta 这样技术实力顶尖的公司还要找它们?因为设计一颗领先的 AI 芯片是一个极其庞大的系统工程:需要定义计算架构、数据通路、存储层级,需要高带宽的 SerDes(串行/解串)和片间互联 IP,需要完成海量的前端/后端设计、验证、物理实现、时序收敛,并最终在台积电的先进制程和 CoWoS 封装上量产。这要求一支动辄数千人、经验丰富、且有成熟 IP 库的团队。即便对超大厂商,从零自建并持续迭代这样的团队,成本和风险都极高。
博通、Marvell 正是把这种能力产品化:它们手握经过硅验证的高速 SerDes、各种基础 IP 和一整套设计实现流程,可以基于客户需求,更快、更稳妥地把芯片做出来。客户保留对芯片的定义权和所有权,而博通/Marvell 收取的是设计服务与 IP 的价值。需要注意的是,这与 Alchip、世芯(GUC)等纯设计服务(design service)公司处在相邻赛道——后两者更多承担实现服务,而博通、Marvell 还自带关键 IP 与网络/互联产品线,话语权和附加值更高。
二、博通:算力与网络的双重卡位
博通是这门生意里毫无疑问的龙头,它的厉害之处在于同时卡住了“算力芯片”和“网络芯片”两个位置。
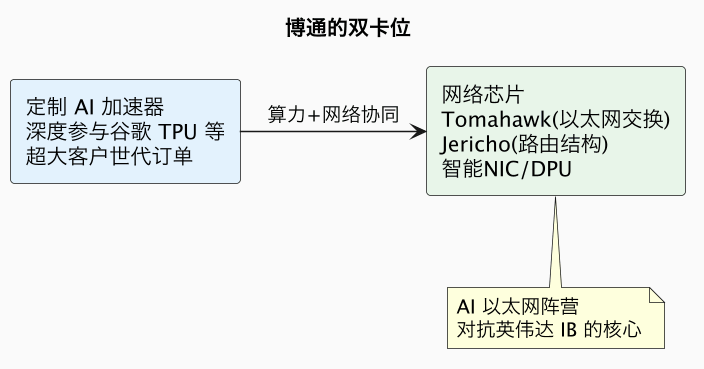
在算力侧,博通深度参与了多颗超大客户自研 AI 芯片的设计与迭代,其中最知名的就是与谷歌在 TPU 上的长期深度合作。这类项目一旦进入,就具有很强的延续性——芯片是按世代迭代的,客户很难在中途更换设计伙伴,于是形成了长达多年、金额巨大的连续订单。
在网络侧,博通的 Tomahawk 系列是以太网交换芯片的事实标准之一,Jericho 系列则面向更复杂的大规模路由与结构。当 AI 集群从英伟达主导的 InfiniBand,向更开放、成本更优的以太网(Ultra Ethernet 等)迁移时,博通正是这股趋势最大的硬件受益者之一,详见InfiniBand 与以太网之争。“定制算力芯片 + 交换/网络芯片”的组合,让博通能为客户提供接近整栈的底层硬件协同,这是除英伟达外少有人具备的身位。博通还通过 VMware 等把触角延伸到软件,但它在 AI 硬件上的核心叙事,始终是“不抢客户品牌,却成为客户离不开的底座”。
三、Marvell:弹性更大的追赶者
Marvell 走的是一条相近但更聚焦、也更“进攻”的路线。它不追求博通那种全线统治,而是把筹码压在几个高增长方向。
| 方向 | Marvell 的卡位 | 逻辑 |
|---|---|---|
| 定制 AI 芯片 | 为多家超大客户设计 AI 加速器 | 承接“去英伟达化”的自研订单 |
| 光 DSP | 800G/1.6T 光模块中的 DSP 芯片 | AI 拉动光互联,DSP 是高价值环节 |
| 电互联 | 有源电缆 DSP、重定时器、连接 | 机柜内高速互联的关键器件 |
| 定制存储/网络 | 数据中心定制芯片 | 深耕 hyperscaler 定制传统 |
Marvell 在光 DSP 上的地位尤其值得一提:高速光模块(800G、1.6T)内部需要 DSP 芯片对信号进行处理,而这是一个技术门槛高、玩家集中的环节,Marvell 正是主要供应商之一。这使得它不仅能从“定制算力芯片”受益,还能从 AI 集群对光模块、有源电缆的海量需求中受益,形成“算力+光/电互联”的组合,相关趋势见光模块 800G/1.6T。
相比博通,Marvell 的体量更小、客户集中度更高,这带来一个鲜明的财务特征:业绩弹性大、但波动也大。拿下一个超大客户的世代订单,可能带来收入的快速跃升;而一旦客户推迟项目、调整路线或转向第二供应商,冲击也会被放大。因此对 Marvell 的判断要更关注其具体客户与项目节奏,而不宜简单外推高增长。
四、卖铲子的好生意,与客户集中度的代价
把视角拉高,博通和 Marvell 代表的是 AI 浪潮里一种很特殊的“卖铲子”模型。
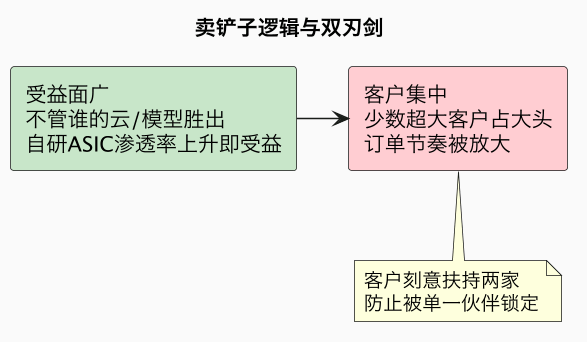
淘金热里最稳赚的是卖铲子的人。博通、Marvell 不需要赌“哪款模型最终胜出”“哪朵云份额最大”,它们赌的是一个更确定的趋势——超大规模厂商为了成本和供应安全,会持续提高自研 ASIC 的比例。只要这个渗透率上升,无论客户之间如何竞争,订单都会流向能把芯片造出来的它们。这种“中立的底层供应商”定位,让它们的 AI 收入具备相对穿越格局变化的确定性。
但这门生意有一个无法回避的代价:客户高度集中。定制 ASIC 项目的甲方只有寥寥几家超大厂商,任何一家的资本开支节奏、项目延期或供应商策略调整,都会显著影响业绩。更微妙的是,这些客户非常清楚“不能被单一设计伙伴反向锁定”,因此会有意同时扶持博通和 Marvell(乃至其他玩家),让它们彼此竞争、互相制衡。这意味着二者之间的竞争不会消失,客户也会努力把议价权握在自己手里。因此,尽管这条赛道确定性很高,博通与 Marvell 仍需不断证明自己的工程领先性、IP 价值和交付能力,才能守住份额。
常见误区
- 误区:谷歌 TPU 就是博通的芯片。 更准确地说,TPU 是谷歌定义并拥有的芯片,博通是关键的设计与实现合作伙伴,二者是定制服务关系。
- 误区:它们只是英伟达的直接竞争对手。 它们主要服务的是云厂商自研需求,和英伟达更多是在“客户自研 vs 外采 GPU”的层面间接竞争,同时博通还在网络侧与之交锋。
- 误区:Marvell 和博通差不多。 博通更全线、更统治,Marvell 更聚焦光/电互联与定制,弹性大但客户集中风险也更高。
- 误区:自研 ASIC 会迅速取代 GPU。 它们长期并存,博通/Marvell 受益于渗透率上升,但前沿训练与灵活负载仍大量依赖英伟达。
总结
博通和 Marvell 是 AI 自研芯片热潮里最确定的“卖铲人”:云厂商掌握定义权,它们掌握把芯片真正设计出来、量产出来的稀缺工程能力,并分别用“定制算力+网络芯片”和“定制+光电互联”双重卡位分享算力红利——唯一的代价,是成也少数大客户、波动也来自少数大客户。
相关与延伸
- 为什么客户要自研:超大规模厂商自研 ASIC
- 网络侧主战场:InfiniBand 与以太网
- 光互联的增量:硅光与 CPO、光模块 800G/1.6T
- 客户的钱从哪来:超大规模厂商 AI 资本开支