英伟达的另一座城墙:NVLink、NVSwitch 与卖整柜的阳谋
最后更新:2026-09-20|数据截止 2026 年中:具体端口速率、GPU 颗数与整柜规格以英伟达官方发布为准,本文用代际与量级表述;竞品(UALink/以太网联盟)进展为公开路线图,量产节奏有不确定性。
本文是产业观察,回答一个比「显卡快不快」更要命的问题:英伟达凭什么不只是卖芯片,而是能把 72 颗 GPU、网络、供电、散热打包成一台「整柜计算机」卖给你,并且让你很难不整套买。 CUDA 是软件侧的护城河(见 CUDA 护城河有多深),本文讲它在系统结构侧的另一座城墙——NVLink/NVSwitch 这套 Scale-Up 互连,以及由此展开的整柜战略。它与 万卡集群网络拓扑(Scale-Out)、UALink 开放机柜总线(挑战者)、液冷(整柜的热)直接咬合。
先说结论
- 大模型训练的瓶颈早已不只是单卡算力,而是卡与卡之间「交换中间结果」的带宽和延迟。 模型切到成百上千张卡上,每张卡都要频繁和别的卡同步梯度、传激活,卡间通信占比越高,单卡再快也会被「等数据」拖死,MFU(模型算力利用率)上不去。
- 英伟达用 NVLink+NVSwitch 在一个机柜里造出一个「超大规模共享显存域」。 72 颗 GPU 通过极高带宽、统一寻址的 NVLink 网络连在一起,对软件而言接近「一台有超大显存的巨型 GPU」,写大模型时不用太操心卡边界——这种编程便利性本身就是极强的粘性。
- Scale-Up 与 Scale-Out 是两个不同的域,别混为一谈。 柜内/紧耦合用 NVLink(极致带宽延迟、铜缆直连、专有),柜间/大规模扩展用以太网/InfiniBand(见万卡拓扑篇)。英伟达最狠的一招,是把 Scale-Up 域越做越大,并同时掌控两个域。
- 卖整柜是把护城河从「芯片」升级成「系统事实标准」的阳谋。 当网络、供电、液冷、软件、调度都按英伟达参考设计长在一起,客户买的是一个开箱即用的算力单元,竞争对手要替代的就不是一颗芯片,而是整个机柜的工程与生态——切换成本被系统性抬高。
一句话:英伟达真正的壁垒,是把一堆 GPU 用 NVLink 焊成一台「显存共享、编程简单、开箱即用」的整柜计算机,让竞争对手哪怕单芯片参数追平,也很难在系统级的工程、软件和生态上整体替代。
一、为什么大模型逼出了「卡间网络」这门硬学问
先从训练一个大模型时发生了什么讲起。没有任何一颗 GPU 的显存能装下今天最大的模型,于是要做并行:把模型按层切(流水线并行)、按权重矩阵切(张量并行)、再复制多份(数据并行)。无论哪种切法,GPU 之间都得不停地传数据——前向传激活、反向传梯度、还要做全局同步(all-reduce 之类的集合通信)。
这里的关键变量是通信/计算比。如果一次计算能摊薄的通信很少,GPU 就会频繁停下来等邻居,集群规模越大、跨的卡越多,通信开销占比越高。业界用 MFU(Model FLOPs Utilization,模型算力利用率,实际有效算力占理论峰值的比例) 衡量这件事,一个调度糟糕的万卡集群,MFU 可能只有三成上下,意味着花大价钱买的卡有大量时间在空转。
卡间通信因此分成两个层次,对应两种物理距离和两种网络:
| 维度 | Scale-Up(纵向扩展域) | Scale-Out(横向扩展域) |
|---|---|---|
| 连接对象 | 同一强耦合域内的 GPU(一柜/相邻柜) | 域与域、机柜与机柜、节点集群 |
| 典型技术 | NVLink + NVSwitch(专有、铜缆) | InfiniBand / 以太网 + 交换机/光模块 |
| 带宽/延迟 | 极高带宽、极低延迟 | 高带宽,延迟相对宽松 |
| 编程语义 | 接近统一显存/单一地址空间 | 消息传递、跨域集合通信 |
| 介质 | 大量铜缆(短距)背板/线缆 | 铜+光,长距靠光模块 |
| 规模 | 单域数十至上百 GPU | 数万卡,胖树/Rail 优化拓扑 |
万卡集群网络拓扑 讲的是右边那列——几万个域怎么用胖树和 Rail 优化连起来、800G/1.6T 光模块(光模块篇)用在哪。本文聚焦左边:为什么柜内这短短一两米的连接,反而成了最金贵、最难替代的护城河。
二、NVLink 与 NVSwitch:把一个柜子变成一颗「大 GPU」
NVLink 是英伟达自研的高带宽 GPU 间互连总线,NVSwitch 是让很多颗 GPU 全互联的交换芯片。二者配合,做的事情可以用一句话概括:让一个机柜里的几十颗 GPU 在软件看来,不像是几十台独立服务器,而更像一颗拥有超大显存的巨型 GPU。
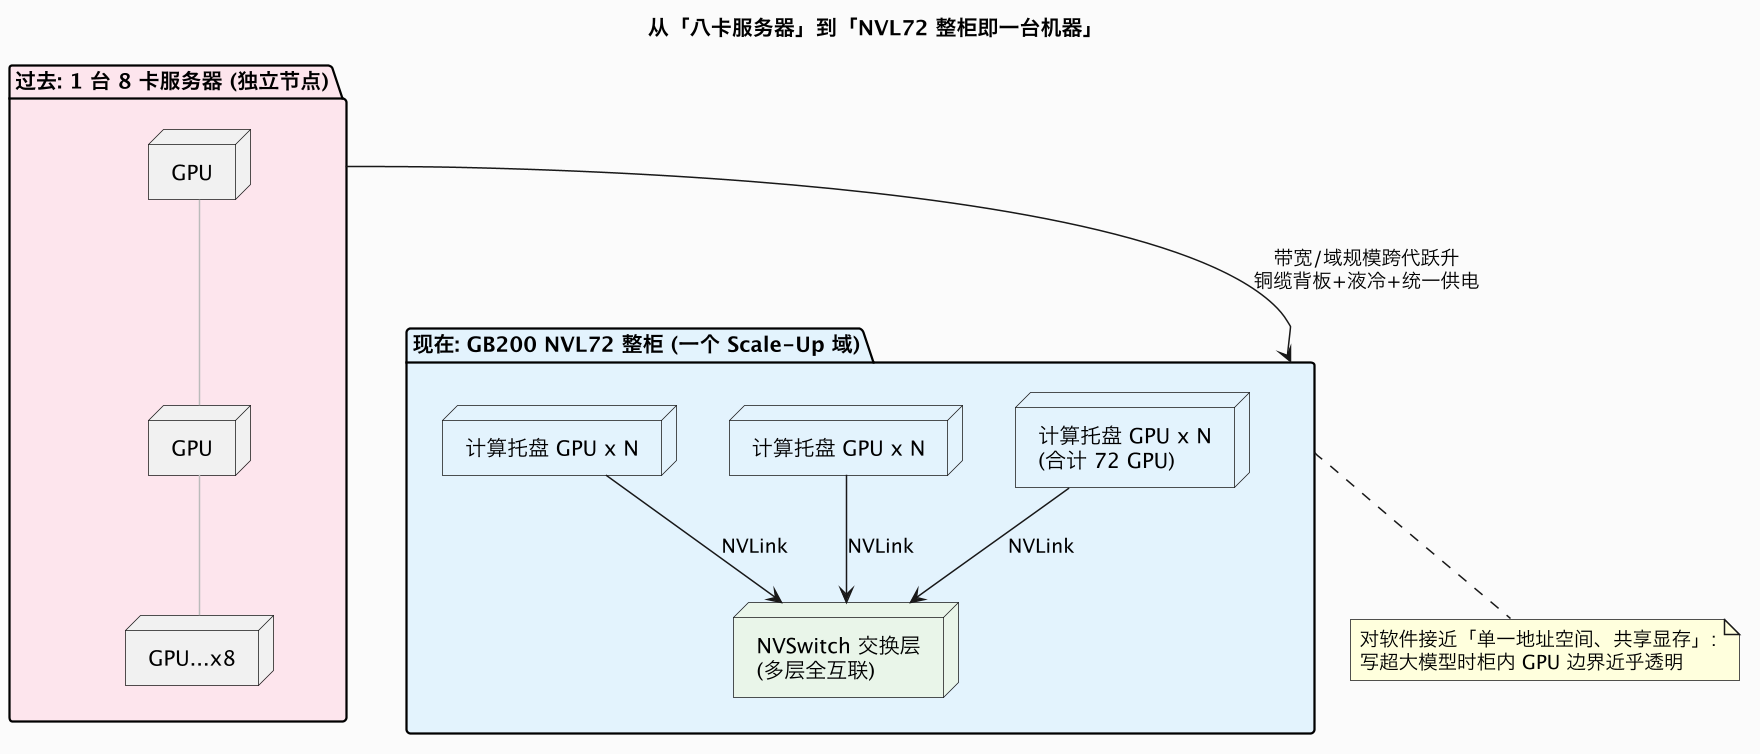
这张图里有三层产业含义,常被「多少 GB/s」的参数掩盖:
1)全互联拓扑。 只有点对点高速链路还不够,72 颗卡要任意两颗都能高速直达,得靠 NVSwitch 组成无阻塞(或接近无阻塞)的交换结构。代际演进里,单域能纳管的 GPU 数量和每颗卡的互连带宽都在跳变,从早期八卡机里的 NVSwitch,一路扩到整柜 72 卡,甚至配合外部 NVLink Switch 系统把域拉到跨柜。
2)统一地址空间带来的编程简化。 这是最值钱的软件红利。在一个 NVLink 域内,配合相关软件栈,一块卡可以像访问自己显存一样访问别的卡的显存(RDMA、内存语义),框架做张量并行时几乎感觉不到机柜里有几十颗独立芯片。换成「72 台服务器用以太网拼起来」,程序员和编译器就要显式处理跨节点通信、延迟和一致性,复杂度陡增。越好用的抽象,迁移时越痛——这和 CUDA 的锁定逻辑是同构的。
3)物理层是工程深水区。 一个柜子里塞进 72 颗顶级 GPU 和它们之间的海量高速链路,信号速率极高、传输距离极短,柜内主要靠铜缆(成本和功耗在短距优于光),这就带来密集的线缆/背板设计、信号完整性、供电和散热挑战。为什么必须液冷(液冷篇)、为什么单柜功率上百千瓦(供电篇)、为什么铜连接和高速连接器厂商受益——根子都在这张图上。
三、阳谋:从卖芯片到卖「整柜即计算机」
把视角拉到商业层面,NVL72 这类产品最值得玩味的,是它重新定义了「英伟达到底卖什么」。过去是卖一颗颗 GPU,服务器厂、云厂自己去组装、组网、配供电散热;现在英伟达直接给出机柜级参考设计乃至整机,把计算托盘、NVSwitch、铜缆背板、液冷、供电、甚至机柜管理打包成一个标准化单元。
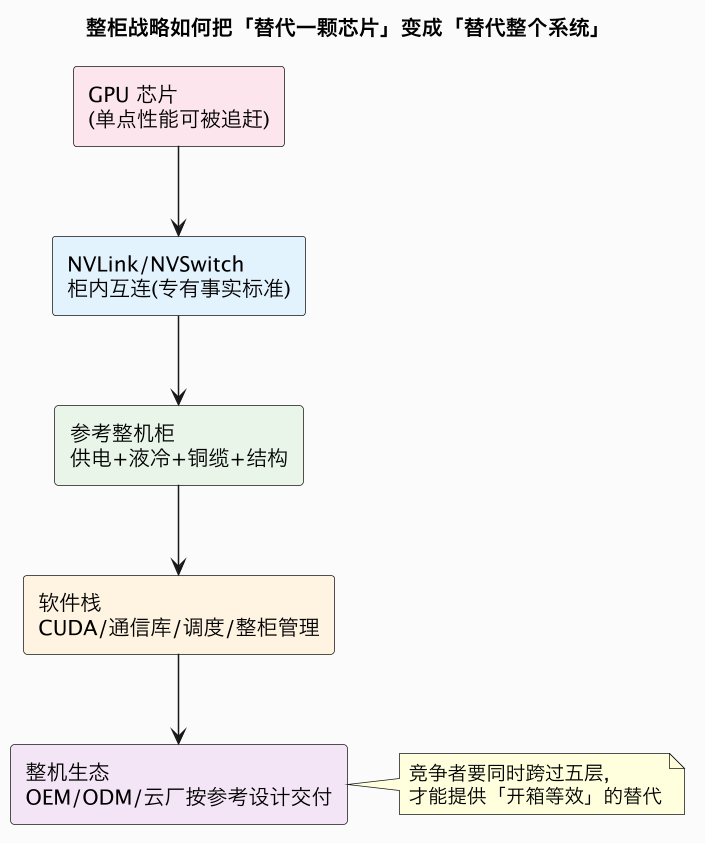
为什么说这是「阳谋」——因为它每一步在技术上都合理、对客户都有好处,但合在一起系统性地抬高了替代成本:
- 对客户:交付更快、风险更低。 买一柜子经过整体验证、散热供电网络都调好的算力,比自己买芯片集成省掉大量工程踩坑,上电到产出的时间大幅缩短。在「谁先训出模型谁占先」的竞赛里,时间价值压过了溢价。
- 对英伟达:掌握了定义权。 连接器用什么、供电怎么分、机柜怎么散热、软件怎么调度,都由参考设计定义,上下游(服务器 ODM、电源、液冷、连接器、光模块)围着它转,进入 BOM 即获绑定,和 液冷、供电 里「跟着平台走」的逻辑一致。
- 对竞争者:替代面从「点」变成「面」。 单芯片跑分追平只是入场券,真正难的是给出同等规模的 Scale-Up 域、同等好用的统一显存编程模型、同等成熟的整机和软件生态。哪怕 AMD(AMD 反攻)或自研 ASIC(云厂自研芯片)在某些场景性价比更优,要在「整柜开箱即用」这个维度全面对标,仍需时日。
当然,阳谋也会激起反弹。客户不愿被一家锁死,于是出现了开放阵营的反扑:UALink 联盟想用开放的 Scale-Up 总线替代 NVLink(见 UALink 篇),超以太网联盟想在 Scale-Out 上立标准,云厂自研 ASIC 也是为了不把命门全交出去。这正是理解未来几年系统层竞争的主线——一方把专有域越做越大、越做越省 心,另一方用开放标准和多供应商生态去撬。谁能赢,不只是带宽参数的较量,更是软件习惯和生态规模的较量。
四、一个常被忽略的趋势:Scale-Up 域为什么越做越大
值得单独讲的是竞争焦点的移动。早年系统优化的重心在 Scale-Out——怎么把成千上万台服务器用胖树、Rail 优化拓扑高效连起来(万卡拓扑篇 展开)。但这两年明显的趋势是:能塞进一个紧耦合 Scale-Up 域的 GPU 越来越多。
这背后有清醒的工程经济学考虑:
- 域内通信比跨域便宜得多。 NVLink 的带宽和延迟远优于柜间网络,把更多张量并行通信放进域内、只把不那么频繁的通信放到 Scale-Out,能显著抬高 MFU。
- 域越大,编程越简单。 一个超大共享显存域能装下更多模型,减少跨域切分的复杂度,框架和编译器的负担下降。
- 但域越大,物理和商业代价越高。 铜缆重量与信号完整性、整柜供电散热、故障域(一个交换层出问题影响范围)、以及对单一供应商的依赖都在上升。域做多大,本质是「性能/易用性」和「成本/可靠性/可替代性」之间的权衡。
不同厂商在这道权衡上选了不同的点,这也是为什么不能只用「谁带宽大」评价架构:超宽专有域简单好用但绑定深,开放/以太网方案灵活多供但要靠软件把体验补齐。未来几年,Scale-Up 域的边界划在哪、用专有还是开放、铜什么时候让位给光(光模块篇 里的光进铜退),会是系统架构最值得跟踪的几个分叉口。
五、变量与置信度判断
| 变量 | 作用方向 | 时间窗 | 置信度 |
|---|---|---|---|
| 训练瓶颈从单卡转向卡间通信 | 互连与整柜价值量上升 | 已发生 | 高 |
| Scale-Up 域继续扩大 | 单域 GPU 数与互连带宽再升 | 2~4 代 | 高 |
| 整柜成为主流交付形态 | 客户买「算力单元」而非散件 | 已发生、延续 | 高 |
| UALink/开放以太网替代 NVLink | 在非英伟达阵营形成开放域 | 3~6 年 | 中 |
| 柜内铜连接部分被光替代 | 受距离/速率提升驱动 | 3~7 年 | 中高 |
| 单芯片追赶者抹平系统差距 | 需软件+整机+生态协同 | 3~8 年 | 中 |
- 未来 1~2 年(高置信度):NVL72 这类整柜继续是旗舰训练集群的主流采购形态,NVLink 域规模和带宽再跨代,绑定的电源、液冷、连接器、铜缆供应链随之放量。
- 未来 3~5 年(中高置信度):Scale-Up 与 Scale-Out 的分工更清晰,开放联盟在 AMD/自研 ASIC 阵营和部分超大规模客户处落地,形成「专有高性能域」与「开放多供域」并存的格局。
- 未来 5 年以上(中置信度):若开放互连的软件体验追上、或光互连在柜内成熟,英伟达系统侧护城河可能被部分稀释;但只要 CUDA 生态和整机可靠性仍领先,整柜事实标准地位短期难被整体替代。
六、对不同角色,这意味着什么
- 对买算力的云厂/大模型公司:整柜能最快拿到可用算力、压低工程风险,但要为锁定付溢价;保持一定的多供应商(AMD/自研 ASIC/开放互连)比例,是对冲单厂依赖的必要动作。
- 对 AMD 与追赶者:单芯片追平只是第一步,真正要补的是「同等规模 Scale-Up 域 + 统一显存编程体验 + 整机参考设计 + 软件栈」的系统能力,单点参数赢不了整柜生态。
- 对供应链厂商:价值正从「卖芯片」外溢到柜内铜缆/连接器、高速背板、整柜供电、液冷和光互连,绑定英伟达参考设计或同时卡位开放阵营,决定订单弹性。
- 对投资者:评估英伟达的壁垒不能只看芯片性能,更要看 NVLink 域规模、整机交付与软件生态这套系统锁定;评估竞争者也同理,要给「系统级替代能力」而不是「单卡跑分」定价。
结语:护城河从芯片长到了机柜
如果说 CUDA 是英伟达在软件里修的长城,NVLink 和整柜战略就是它在硬件机房里筑的另一座。它把「一堆需要工程师费力拼接的 GPU」变成「一台显存共享、编程简单、上电即用的巨型机器」,用的每一项技术都光明正大、对客户都确有好处——这正是阳谋难破之处:你很难拒绝一个让你更快训出模型的东西,哪怕代价是更深的绑定。挑战者因此被迫从「做一颗更快的芯片」升级为「重做一整套机柜与生态」,这远比跑分残酷。读懂 Scale-Up 域和整柜,才算真正看懂了这场 AI 算力战争的主战场——它早已不在芯片之内,而在芯片之间那一柜柜密布铜缆、流淌冷却液、跑着统一软件的系统里。
数据口径与延伸
- 数据口径:训练对卡间通信的依赖、MFU 损失、Scale-Up/Scale-Out 两域分工、NVLink+NVSwitch 构造柜内共享显存域、NVL72 整柜形态、铜缆背板与液冷供电耦合、开放联盟(UALink/超以太网)挑战,来自英伟达官方规格、系统厂商材料与行业研究的常见公开口径。具体端口速率、GPU 颗数与单域规模以正式发布为准,竞品量产节奏存在不确定性,本文用代际与量级表述。数据截止 2026 年中。
- 相关产业观察:万卡集群网络拓扑(Scale-Out)、UALink 开放机柜总线(挑战者)、CUDA 护城河有多深(软件侧城墙)、英伟达 AI 产品矩阵(产品定位)、800G/1.6T 光模块、液冷产业图谱。
- 同批待写延伸:AI 编译器(E5)、InfiniBand 与以太网之争(D2)、云厂自研 ASIC(C4)。
一句话总结:大模型训练的瓶颈从单卡算力转到卡间通信,英伟达用 NVLink+NVSwitch 把一柜 72 颗 GPU 连成「显存共享、统一寻址、编程近乎无卡界」的 Scale-Up 域,再用整柜战略把网络、铜缆、供电、液冷和软件打包成开箱即用的算力单元;这使竞争对手即便单芯片参数追平,也必须整体替代一座包含互连、整机和生态的系统——护城河就此从芯片长到了机柜,而 UALink、开放以太网和云厂自研 ASIC 正是对这场「专有整柜阳谋」的长期反扑。