大模型量化:INT8/FP8/FP4
数据截止 2026-09。承接 KV Cache 经济学 与 AI 编译器。
一句话回答
量化把权重和激活从 16/32 位降到 8 位甚至 4 位,直接砍显存占用和访存、提升吞吐,是降低推理成本最有效的手段之一;但位宽越低越容易掉精度,关键障碍是激活离群值,需要 GPTQ/AWQ/SmoothQuant 等技巧。FP8 已成为训练与推理的新甜点,FP4(如 Blackwell)配合块级缩放追求更高压缩,代价是更复杂的校准和硬件要求。
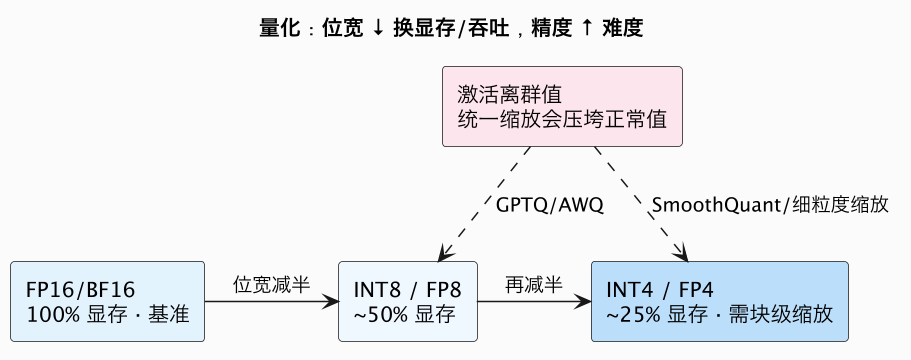
下面这张图先把量化最核心的权衡摆出来:位宽一路往下压,显存与访存省下来,代价是精度越来越难守,而激活离群值正是守住精度的最大障碍。
一、省在哪
推理常是访存受限:权重要从显存搬进芯片。位宽减半 → 权重占用和带宽需求近似减半,在受限于权重读取的场景吞吐显著提升。
要理解量化为什么收益这么大,需要先看清大模型推理的瓶颈分布。模型推理的每一步,都要把全部参数从显存读进来参与矩阵运算;当模型很大、批量较小时,芯片的算力其实很充裕,时间主要花在「等待权重从显存搬运到计算单元」上,这就是访存受限(memory-bound)。此时决定速度和成本的不是每秒能做多少运算,而是每秒能搬多少数据。量化把每个权重从 16 位压到 8 位甚至 4 位,等于在同样的显存带宽下,一次能搬进来的参数数量翻倍或翻两番,因此在访存受限区间能近乎线性地提升吞吐;同时显存占用下降,意味着同样的卡能装下更大的模型或服务更多并发。量化还间接降低了多卡部署、机房和电力等围绕显存与卡数的一系列成本,这也是它成为推理降本首选手段的原因。
不过收益大小取决于瓶颈类型:在访存受限(小批量、解码阶段)收益最明显;在算力受限(大批量、计算密集)阶段,如果只是把权重存成低精度、实际计算仍用高精度,速度提升就有限——必须让计算也走对应的低精度张量核才能吃到红利。
| 位宽 | 相对 FP16 权重占用 | 典型用途 |
|---|---|---|
| FP16/BF16 | 100% | 基准 |
| INT8/FP8 | ~50% | 推理为主,FP8 也用于训练 |
| INT4/FP4 | ~25% | 高压缩推理 |
二、两种量化对象
- 只量化权重(W8A16 等):权重压缩、激活仍高精度,实现简单、较稳;
- 权重+激活(W8A8):才能让计算也走低精度张量核、速度更快,但激活难量化。
这两种方案的取舍,本质是「实现难度/精度风险」与「性能收益」的平衡。只量化权重的好处是权重在推理前就固定了,可以离线用一小批校准数据精心优化,而且激活仍保持 16 位高精度,模型的表达能力几乎不受影响,精度损失通常很小、落地最稳。它特别适合「权重读取是主要瓶颈」的小批量、单并发场景,这类场景下只压权重就能拿到大部分吞吐收益。但因为矩阵乘法的实际数值计算仍是高精度,在大批量、计算吃重的场景无法充分利用低精度张量核。
**权重和激活都量化(W8A8)**才能让整条计算路径都在 8 位张量核上执行,把算力也翻倍利用,在高吞吐、大批量服务端场景收益最大。问题在于激活是随输入实时变化的,无法像权重那样提前离线优化,而且激活中存在难以处理的离群值,因此 W8A8 的精度保持要困难得多,往往需要专门的算法(见下节)和运行时校准。实践中常按场景选择:对精度敏感或单并发负载用仅权重量化,对极致性价比、高并发的服务端推理想办法上 W8A8 甚至更低位宽。
三、为什么激活难
少数通道出现极大的离群值,简单按统一比例缩放会把大量正常值压到不可分辨。对策:
- GPTQ / AWQ:面向权重的训练后量化,最小化误差;
- SmoothQuant:把激活的难度“转移”一部分到权重;
- 每通道/块级缩放:FP4 需细粒度缩放因子弥补动态范围。
这里再展开讲清离群值为什么是「拦路虎」。量化的基本操作是用一个缩放因子把一段数值映射到低位整数能表示的范围。问题在于大模型激活的分布极不均匀:绝大多数数值集中在很小的范围,但极少数通道会出现比正常值大几十甚至上百倍的离群值,而且这些离群通道对模型表达又至关重要、不能简单截断。若为了容纳离群值而放大整体缩放比例,海量正常值就会被挤进少数几个量化级、彼此无法区分,等效精度崩塌;若削掉离群值,模型效果又明显下降。这就是统一缩放方案的两难。
各类方法从不同角度破局:GPTQ 在权重被量化引入误差后,依据二阶信息把误差补偿到尚未量化的其他权重上,使整体输出误差最小;AWQ 观察到并非所有权重同等重要,一小部分「显著权重」对性能影响大,于是通过缩放因子保护这些权重而非对所有值一视同仁;SmoothQuant 则巧妙地做难度迁移——在数学等价的前提下,把激活上的难度通过缩放因子部分转移到更容易量化的权重上,让 W8A8 变得可行;而到了 FP4 这类极低比特,单一缩放因子已无法覆盖动态范围,必须用更细的分组/块级缩放(每一小段数值配一个缩放因子),代价是额外的元数据、校准复杂度和对应的硬件支持。理解这一点就能明白:位宽每往下压一档,工程焦点就从「存储压缩」更多地转向「如何在分布不均的数值上守住有效信息」。
四点五、FP8 与 FP4:为什么要硬件原生支持
INT 与 FP 两种低比特路线的兴衰,很大程度由硬件决定。早期低比特量化多用 INT8/INT4 这类整数格式,因为整数运算简单、张量核支持早。但整数格式表达动态范围需要靠缩放因子小心管理,在训练(梯度动态范围极大)和大模型激活场景下尤其麻烦。FP8(含 E4M3、E5M2 两种编码)的崛起在于它保留了浮点的指数位,天然能覆盖更宽的动态范围、对缩放更宽容,从而第一次让「同一种低精度格式既能训练又能推理」成为可能。Hopper 及之后的架构原生提供 FP8 张量核,配套框架和缩放策略成熟后,FP8 迅速成为兼顾精度、性能与易用性的新甜点:训练用 FP8 可在几乎不损收敛的前提下大幅提速省显存,推理也普遍采用。
FP4 则随 Blackwell 一代走向台前,把单参数压到 4 位以追求更高的算力密度和更低的能耗。但位宽减半后,动态范围和表示能力更紧张,单纯靠全局缩放根本不够,必须配合块级缩放(microscaling)——每一小组元素共享一个高精度缩放因子,在压缩和可表示范围之间折中。这要求张量核、数据格式和软件栈做整套协同设计,老一代硬件无法靠软件升级获得同等收益。由此引出量化落地的一个铁律:压缩比再高,若没有硬件对该格式的原生张量核支持、没有推理框架和内核的匹配,也无法转化为实际速度,甚至可能因为模拟低精度反而更慢。因此选型时必须先确认目标部署硬件支持哪些格式(INT8 / FP8 / INT4 / FP4),再据此选择量化方案,而不是反过来。
常见误区
- 认为量化无损:低比特普遍有精度损失,要在任务集上评测。
- 只压权重就期望大幅提速:若瓶颈在计算,需激活也量化并用对张量核。
- 忽视硬件格式支持:不是所有卡都原生支持 FP8/FP4,软件栈要匹配。
- 拿单一基准当结论:不同模型/任务对量化敏感度不同。
- 混淆训练后量化与量化感知训练:后者成本高但通常更稳。
- 只看压缩比、不看端到端 TCO:细粒度缩放带来的额外元数据、校准开销、兼容老硬件时的回退成本,都应计入,真正要优化的是单位成本而非纸面压缩率。
- 忽视量化与其他手段的配合:量化常与投机解码、KV Cache 量化、蒸馏和路由(小模型处理简单请求)组合使用,单独依赖某一项往往拿不到最优性价比。
- 校准数据随便选:训练后量化的效果高度依赖校准集是否代表真实分布,用偏门或太少的数据校准会导致线上掉点。
五点五、落地时怎么权衡精度与成本
量化不是「压得越低越好」,而是一道要结合业务、硬件和模型的多目标权衡。比较稳妥的推进方式是按「精度损失—成本收益—覆盖范围」逐层压测,而不是一上来就冲 FP4:
- 先建立业务侧的精度标尺。 不要只看通用基准分,而要在与真实业务高度相关的评估集上定义可接受的效果下限(比如回答正确率、检索召回、业务关键指标的掉点不超过某个阈值)。量化是否可用,应由这把标尺决定。
- 从最稳的档位开始。 通常先试只量化权重的 INT8/W8A16,多数情况下几乎无损、落地快,能拿到小批量场景的大部分收益;若精度达标且已满足成本目标,就没有必要追求更低位宽。
- 按瓶颈决定是否上激活量化。 只有在大批量、高并发的算力受限场景,且 W8A8/FP8 经评估能守住精度时,才升级到全张量低精度以换取吞吐。
- 把 4 位留给收益确实覆盖风险的场景。 FP4/INT4 在硬件支持、块级缩放和校准成熟时性价比极高,但要更严格地验证长尾输入和难例上的表现,并准备回退到 8 位的方案。
- 按真实单位成本做最终裁决。 用「每千请求 / 每 token 成本」结合 SLA(P95/P99 延迟)和效果指标综合比较,而不是孤立看压缩比或峰值算力。
一个常被忽视的事实是:不同层、不同模型对量化的敏感度差别很大。实践中可以做混合精度——对敏感的部分(如某些注意力层、embedding、输出头)保留高精度,其余部分压到低位,从而在整体压缩率和精度之间取得更细的平衡;结合蒸馏、小模型路由等手段,往往比全模型统一压到某一位宽效果更好。最终判断一次量化方案是否成功,标准应是「在业务效果不跌破红线、延迟不恶化的前提下,单位推理成本下降了多少」,而不是位宽数字本身有多激进。
总结
量化通过降低权重/激活位宽压缩显存与访存、提升推理吞吐,INT8/FP8 成熟、FP4 靠块级缩放进一步压缩;核心难点是激活离群值,需 GPTQ/AWQ/SmoothQuant 等方法并在真实任务上验证精度,务必结合硬件原生支持与 TCO,而非只看压缩比。可以记住一条朴素原则:量化是手段不是目的,最终要交付的是「在业务可接受的效果与延迟之内、显著更低的单位推理成本」,位宽的选择应服从这一目标并保留按场景回退的弹性。还应看到,量化技术本身仍在快速演进,新的格式、缩放策略和校准方法层出不穷,今天的最优配置可能很快被更优方案取代,因此团队更应建立持续基准评测与复测的机制,而不是锁定某个一次性结论。与此同时,要警惕为追求极致压缩比而引入超出团队驾驭能力的复杂度——细粒度缩放、混合精度都意味着更多的调参和维护成本。真正成熟的做法始终是:围绕真实业务瓶颈选择位宽、用贴近生产的数据验证精度与收益、并保留随时回退到更稳档位的余地。能长期稳定兑现的成本下降,才是量化最终的价值所在;而把这种精细权衡与系统协同长期坚持下去,才是把大模型用得既省又好的关键。