AI 进入华尔街:量化、风控、信贷与投研的智能化,以及它的边界
数据截止 2026-09。承接AI 按结果付费、垂直 SaaS 的 AI 化、合成数据产业。
金融业可能是最早、也最彻底“被数据和算法改造”的行业:早在这一波生成式 AI 之前,量化基金就用机器学习挖因子,银行用统计模型做信用评分和反欺诈。生成式 AI 带来的增量,主要在研报与海量文档的理解、另类数据处理、以及合规/客服的自动化。但金融也是对“可解释、可控、可审计”要求最苛刻的行业之一——一个准确率很高却说不清理由的模型,在这里可能根本不能上线。 理解 AI 在“预测—决策—执行”链条上的真实位置与边界,比“AI 能不能预测股市”的噱头更重要。
先说结论
- AI 在金融的价值分布在量化信号、信用/风险模型、反欺诈、智能投研、合规与客服,前几类是成熟的判别式 ML,生成式主要补文档与信息处理。
- 量化的核心是“预测—决策—执行”全链条:AI 擅长从海量数据挖信号,但策略收益取决于数据、执行、容量与风控的综合优势,而非单一模型。
- 金融的硬约束是可解释性、模型风险与监管:信贷、风控要能向客户和监管解释“为什么拒贷”,黑箱模型再好也受限。
- 另类数据(卫星图像、舆情、供应链、招聘等)+ LLM 解析是近年信息优势的新来源,但拥挤后 alpha 会迅速衰减。
- LLM 适合投研提效、文档/合规处理,却不宜在无人复核下直接做高杠杆交易或重大授信决策。
节点速览:技术 / 玩家 / 成熟度 / 预期
数据截止 2026-09。标尺说明见 AI 产业链总览。
| 象限 | 要点 |
|---|---|
| 关键技术 | ① 量化因子挖掘/ML 信号(TRL-4~5)② 信用评分与非线性风险模型(TRL-5)③ 反欺诈/实时异常检测(TRL-5)④ 另类数据+NLP/多模态解析(TRL-3~4)⑤ LLM 投研/合规文档(TRL-3~4)⑥ 可解释性与模型风险管理(TRL-4) |
| 主要玩家 | 量化巨头与对冲基金、银行/券商/保险、Fintech(信贷/支付/风控)、金融数据商与评级机构、提供模型治理的合规科技;监管:央行与金融监管机构 |
| 做到什么程度 | 判别式 ML 在风控/反 fraud/量化已规模商用;LLM 在投研与合规中试到落地、需人复核;全自动 AI 交易决策仍受模型风险与监管约束 |
| 后续预期 | 6 个月:金融机构扩大 LLM 文档/客服部署(置信度高);18 个月:模型治理与可解释工具成标配(置信度中);36 个月:生成式与量化工作流深度整合、监管框架成熟(置信度中) |
一、AI 在金融价值链上的位置
金融机构的核心动作可概括为“处理信息 → 形成预测 → 做出决策 → 执行并管理风险”。AI 在不同环节的成熟度并不相同。
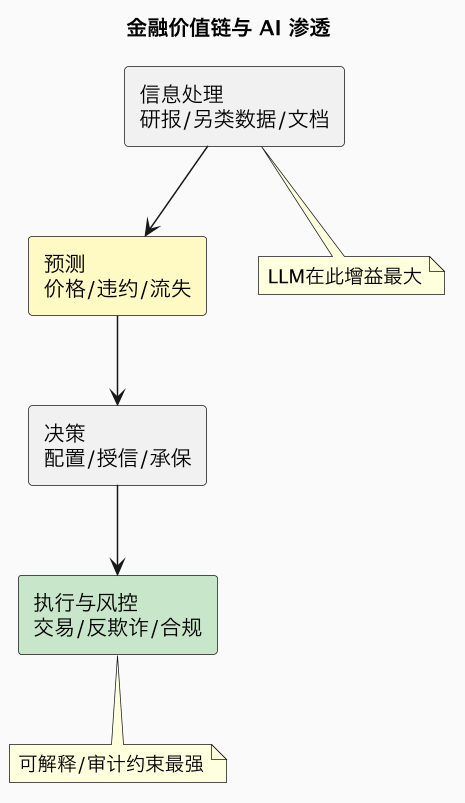
- 信息处理:从研报、财报、电话会、新闻到另类数据,NLP 与多模态模型负责抽取、摘要、结构化,生成式 AI 在此增益最直接。
- 预测:量化收益、违约概率、客户流失、市场风险,判别式 ML 已深耕多年。
- 决策:资产配置、授信额度、保险定价,越靠近“拍板”越要人负责与合规背书。
- 执行与风控:交易执行、实时反欺诈、监控与合规报告,要求低延迟、可审计。
二、量化交易:模型只是一环
量化是大众对“AI 金融”最直接的想象,但专业机构清楚,一个会预测的模型远不等于一套能赚钱的策略。完整链条包括数据获取与清洗、因子/信号挖掘、组合构建、风险控制、交易执行与容量管理。
| 环节 | AI 的作用 | 单靠模型的盲区 |
|---|---|---|
| 信号 | 从海量数据挖非线性规律 | 过拟合、样本外失效 |
| 组合 | 优化权重、控制暴露 | 极端行情相关性突变 |
| 执行 | 算法交易降低冲击成本 | 流动性枯竭时滑点暴增 |
| 风控 | 实时监测与压力测试 | 尾部事件难从历史学习 |
这里有个根本悖论:市场是对抗性的,一旦某个规律被很多人发现并交易,它的超额收益就会迅速衰减。 因此量化的护城河是数据独特性、执行质量、风控纪律和持续迭代能力的组合,而非“某个更聪明的神经网络”。AI 提升了挖掘效率,却没有取消“策略会拥挤、会失效”的规律;历史上也不乏复杂模型在极端行情中集体失灵的教训。
三、风控与信贷:准确之外,还要“说得清”
银行的信用评分、保险承保、反欺诈是 ML 最成熟的用武之地,模型能从多维数据中识别非线性风险、在毫秒级发现异常交易。但金融决策直接影响个人权益与金融稳定,因此可解释性和模型风险管理(MRM)是硬约束。
- 可解释:被拒贷的客户有权知道原因,监管要求机构能解释决策依据;纯黑箱的高精度模型可能因无法解释而不能用于这类场景,于是 SHAP 等可解释方法、可建模约束被广泛使用。
- 模型风险:数据漂移、概念漂移(经济环境变了,旧规律失效)、偏差与歧视,都要求机构对模型做持续验证、监控和回溯,并有模型清单与问责机制。
- 稳健优先:在金融里,一个略不精准但稳定、可解释、可控的模型,常优于难以审计的“黑箱高分模型”。
这与一般互联网“先上线再迭代”的文化截然不同,也是 AI 在核心授信环节推进相对审慎的原因。
四、另类数据与生成式 AI 的新增量
近年信息优势的新前沿是另类数据:卫星图像(看停车场车流、油罐液位)、舆情与社交媒体、信用卡/供应链、招聘信息、专利等,配合 NLP/多模态模型解析成可用信号。生成式 AI 进一步降低了把非结构化信息转成结构化洞察的成本。
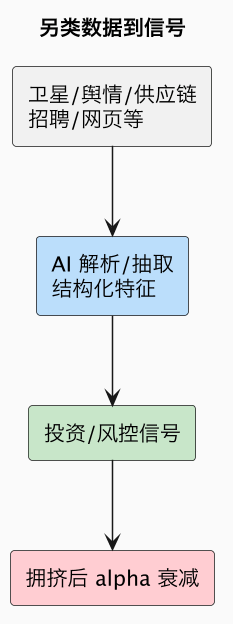
需要清醒:另类数据的价值同样遵循“先使用者得 alpha,普及后被定价”的规律,且要警惕数据合规(是否侵犯隐私、是否违反信息使用规则)与数据质量。生成式模型最务实的落点,则是投研提效(速读大量研报财报、跨语言信息汇总、生成初稿)、合规与监管报告(长文档抽取、条款比对、可疑事项标注)和客服/财富管理助手,这些场景容错相对可控、价值清晰,但在受监管的业务里仍普遍保留“人工复核”这道闸。
五、格局与边界:为什么不能“全交给 AI”
竞争格局大致分四类:量化巨头与对冲基金(数据与人才密度最高、模型自研)、银行/券商/保险(场景全、但受强监管与遗留系统约束)、Fintech(在支付、信贷、风控上更敏捷、擅长实时数据)、金融数据商与评级机构(掌握权威数据集、把 AI 做成增值服务)。生成式基础模型厂商则更多通过云与合作进入,而非直接持牌经营。
边界同样明确:其一,LLM 会幻觉、会受提示操纵,不能在无人复核下直接驱动高杠杆交易或重大授信;其二,历史数据不包含所有尾部风险,极端行情中模型可能集体失效;其三,监管与问责要求“始终有人能负责”。因此金融 AI 的现实形态不是“AI 取代交易员/信贷员”,而是“AI 处理信息与提出建议、人做决策与承担责任、模型被严格治理与审计”。这与AI 按结果付费、垂直 SaaS在专业服务领域的普遍规律一致:越靠近高责任决策,AI 越以“增强”而非“替代”落地。
常见误区
- 误区:有了 AI 就能预测股市、稳赚。 市场对抗性决定信号会拥挤衰减,收益靠全链条优势。
- 误区:模型越准就越该上。 信贷风控里可解释、可审计常比极致准确更重要。
- 误区:LLM 可以直接当交易员。 幻觉与操纵风险使其更适合投研提效、需人复核。
- 误区:历史数据足够覆盖风险。 尾部事件恰恰是历史里少见、模型难学的部分。
- 误区:另类数据是永久金矿。 普及后 alpha 快速衰减,且有合规与质量门槛。
总结
AI 在金融的落地沿‘信息处理—预测—决策—执行风控’分布:判别式机器学习在量化信号、信用风控和反欺诈中早已规模商用,生成式 AI 主要在另类数据解析、投研与合规文档上做增量;但金融的对抗性让量化信号必然拥挤衰减、可解释性与模型风险监管让黑箱高分模型受限,LLM 也因幻觉风险不宜在无人复核下直接交易或授信——最终形态是 AI 高效处理信息与建议、人做高责任决策并被严格审计,而非把华尔街整个交给算法。
相关与延伸
- 专业服务的变现与责任:AI 按结果付费
- 行业软件改造:垂直 SaaS 的 AI 化
- 数据增强手段:合成数据产业
- 另一高责任应用:AI 药物发现