异步FIFO设计全景:从格雷码到综合时序的完整路径
本文是异步FIFO专题的支柱页。配套工程包:
async-fifo-mini(rtl/tb/scripts/docs,make sim一键仿真)。 前置要求:FIFO 与握手基础 与 两级同步器原理。 学习路径(按此顺序读,而非按发布时间):①本页全景 → ②满空语义与保守延迟(撰写中)→ ③格雷码原理深挖(撰写中)→ ④工程包实战 → ⑤综合资源实测 → ⑥常见坑点排查 → ⑦面试高频问答。 子页导航:常见坑点排查 | 面试高频问答 | 综合资源实测
一、为什么需要异步FIFO
跨时钟域传递单个控制信号,两级打拍就够了(见两级同步器模板);但跨时钟域传递连续数据流时,打拍解决不了三个问题:生产与消费速率不一致、多位数据不能逐位同步、流量需要缓冲削峰。异步FIFO就是为此而生的标准件:写侧与读侧各用自己的时钟,内部一块存储体加两套指针,把「数据流 + 反压」封装成干净接口。
它高频出现在真实工程里:UART 接收缓冲、DMA 与总线桥接、视频行缓存、CPU 与外设速率解耦。面试里它也是跨时钟域题目的标准答案,所以把它吃透的回报远高于一般模块。
二、核心难点:指针不能直接同步
同步FIFO里满空判定只需比较读写指针;异步FIFO里指针要跨时钟域,而二进制指针一次递增可能翻转多位(如 0111→1000 四位同翻)。直接打拍同步,采样到的可能是多个位的混合中间态,满空判断随之出错。
解法是格雷码指针:相邻计数值只差一位,跨域采样最多错一位,而错一位在语义上是「读到旧值」——对满空判定是安全的(只会偏保守,不会误判溢出)。这是异步FIFO全部设计技巧的源头:
- 读写指针用格雷码保存与传递;
- 写指针经两级打拍进入读时钟域,读指针经两级打拍进入写时钟域;
- 空 = 读指针 == 同步后的写指针;满 = 写指针 == 同步后的读指针的高两位取反(格雷码满判定的标准形式);
- 指针本身比地址多一位,用最高位区分「绕回」。
把这条主线画出来,整个异步FIFO只有五个部件:两侧各自的指针与满空逻辑、一块双口存储、两条方向相反的格雷码同步链。
读这张图抓住两条主线:数据只走存储体(写口进、读口出,不跨域打拍);跨域的只有指针,且一律格雷码加两级打拍。满空判定永远在本侧时钟域内完成,比较的是本地指针与同步过来的对方指针——这就是全部复杂度所在。
三、满空判定的正确语义
满空不是简单的指针相等。指针扩展一位后,「写指针绕回一圈追上读指针」才是满。用格雷码表达时,满的条件是写指针与同步后读指针相比:高三位中最高位不同、次高位也不同、其余位相同(即高两位取反)。判空则是完全相等。
两个容易忽略的性质:
- 满空都有保守延迟。指针同步要两拍,所以「空」在读侧看到的写指针是旧的,可能虚报空;「满」在写侧看到的读指针是旧的,可能虚报满。虚报只是牺牲一点吞吐,不会破坏数据,这是设计的安全方向。
- 复位要分侧处理。写侧复位清空写指针、读侧复位清空读指针,两侧各自与自己的时钟同步;跨域的指针同步链在复位期输出零,保证上电初态为空。异步复位同步释放是常见选择。
四、存储体与参数取舍
存储可以寄到 BRAM 或分布式 RAM(LUTRAM)。深度小(几十拍以内)用寄存器/分布式 RAM 灵活且省 BRAM;深度大交给 BRAM 面积效率更高,但要注意 BRAM 的读出延迟会改变读数据通路的时序假设。深度通常取 2 的幂,因为指针自然回卷不需要取模逻辑;非 2 幂深度要额外比较器,面积和时序都不划算。
位宽、深度、是否输出打拍,这三个参数直接决定面积与时序。本专题的综合资源实测子页给出深度 4/16/64、位宽 8/32/128 的档位实测矩阵。
实测速览:面积跟着存储位数走
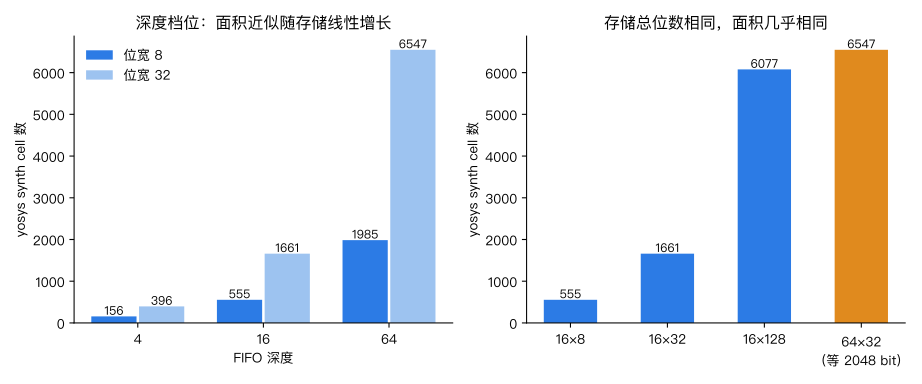
同一套 RTL 在 yosys 0.33 synth 下逐档综合(每档独立实跑,完整矩阵与解读见综合资源实测):
| 深度 | 位宽 | cell 数 | 关键路径级数 |
|---|---|---|---|
| 4 | 8 | 156 | 37 |
| 4 | 32 | 396 | 34 |
| 16 | 8 | 555 | 54 |
| 16 | 32 | 1661 | 54 |
| 64 | 8 | 1985 | 72 |
| 64 | 32 | 6547 | 72 |
口径说明:generic 综合不带工艺库时延模型,yosys sta 报不出纳秒级延迟,这里用 ltp 报出的最长拓扑路径级数衡量时序压力,级数越多、寄存器间逻辑越深。两组数值得记住:深度每翻 4 倍,cell 数大约翻 3.5 倍;而 16×128 与 64×32 存储位数相同(都是 2048 bit),cell 数也几乎相同(6077 对 6547)——面积的第一决定变量是存储总位数,不是深度或位宽本身。
矩阵汇总日志原文(每档的完整 yosys 输出在工程包 make matrix 里可复现):
depth width cells longest_path_ns slack_ns critical_path_ltp_levels
4 8 156 NA NA 37
4 32 396 NA NA 34
16 8 555 NA NA 54
16 32 1661 NA NA 54
64 8 1985 NA NA 72
64 32 6547 NA NA 72
16 128 6077 NA NA 45
五、工程包导览
配套工程包 async-fifo-mini 把上面所有结论落成可运行代码:
rtl/async_fifo.v:参数化异步FIFO(格雷码指针、两级同步、分侧复位),编码转换函数内联在同一文件;tb/tb_async_fifo.v:异步双时钟激励,覆盖写满、读空、随机速率差三类场景,自检输出 PASS/FAIL;tb/tb_overflow.v、tb/tb_reset_skew.v:两个坑点的最小复现用例(详见坑点排查);Makefile:make sim一键仿真、make syn单档综合、make matrix跑 6 档深度×位宽矩阵;scripts/syn.ys、scripts/run_matrix.sh:综合与矩阵脚本,日志带命令/日期/工具链三行头。
代码获取:完整工程包在独立仓库 derekzhuo/async-fifo-mini,克隆后 make sim 即可复现下面的输出(本机需 iverilog,或用 Docker 跑)。
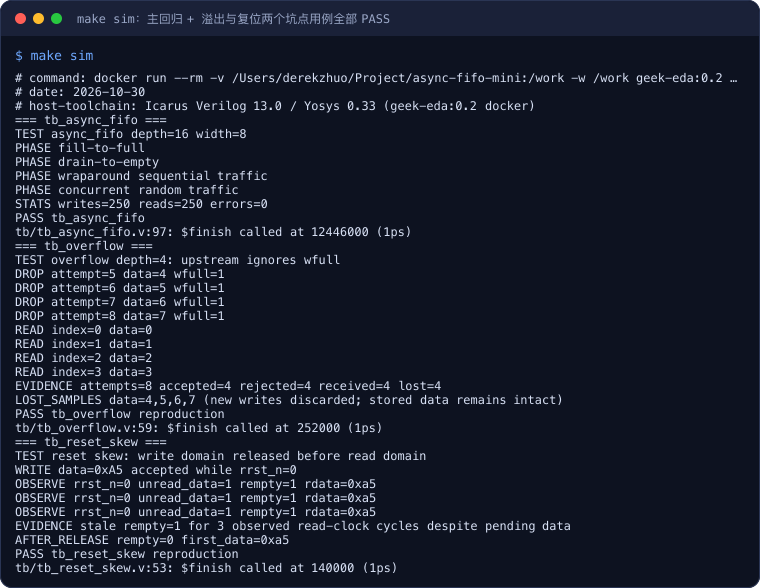
下面是一次完整的 make sim 实录:主用例 250 写 250 读零错误,两个坑点用例各自复现成功——仿真不只是一句 PASS,每个用例都打印了可核对的证据行。
六、什么时候不要用异步FIFO
数据量极小且只是偶尔跨域传一个字:握手寄存器更省;两侧时钟其实同源:直接用同步FIFO省掉同步链;需要随机访问:那是双口 RAM 不是 FIFO。选型错误的代价往往比写错代码更大。
实验环境
- 机器/系统:Mac(Intel)/ macOS,全部实验在 geek-eda:0.2 Docker 容器内执行
- 工具版本:Icarus Verilog 13.0 / Yosys 0.33 / Verilator 5.020(容器内置)
- 日期:2026-10-30
- 完整命令:
make sim(主回归 + 两个坑点用例)、make matrix(深度 4/16/64 × 位宽 8/32/128 共 7 档综合) - 原始记录:工程包 async-fifo-mini 可一键复现,本文实录以终端卡与日志摘录内嵌
总结
异步FIFO的设计主线只有一条:指针用格雷码跨域,满空用扩展位判定,存储与深度按资源实测取舍。把这条主线写成代码只是半小时的事,真正拉开差距的是理解每一步为什么只能这么做——这也是本专题后续子页逐一展开的内容。
下一篇:满空语义与保守延迟(撰写中);也可以直接跳到综合资源实测。