验证计划 testplan 怎么写:从特性条目到功能覆盖率的可追溯映射
更新时间:2026-09-25。本文是「集成电路大类 · 芯片设计 · 数字验证」实操序列的入门专题,接在 SystemVerilog Testbench 实战 与 受约束随机验证 CRV 之后。前两篇解决「平台怎么搭、激励怎么随」,这一篇解决更上游的问题:在写第一行 sequence 之前,先把「要验证什么、怎么算验证完」写清楚——也就是验证计划 testplan,以及它如何与 代码功能覆盖率 建立逐条可追溯的映射。
本文要回答的问题
- 验证计划 testplan 到底写哪些章节,凭什么说它是验证收敛的源头?
- 一条抽象的 feature(比如「FIFO 满了不能再写」)怎么拆成可以真正被观测到的 feature point?
- feature point 又凭什么一一对应到 covergroup、coverpoint、covercross 和 SVA 断言?
- 怎样保证 vPlan(验证计划)双向可追溯:既不漏测,也不堆一堆和需求无关的冗余覆盖?
- 回归跑出覆盖率之后,holes(空洞)分析具体怎么做,怎么反馈回 testplan?
一、为什么 testplan 是验证的源头,而不是附属文档
很多新手把验证计划理解成「项目开头写一次、之后没人看的 Word」。这是对 testplan 最大的误解。在受约束随机验证(CRV,Constrained Random Verification)的流程里,激励是随机生成的,你无法再像定向测试那样指着一条用例说「这个场景我测过了」。随机测了什么,只能靠覆盖率回答;而覆盖率模型里该放哪些 coverpoint,不是拍脑袋决定的,必须来自一份预先定义的清单。这份清单就是 testplan。
换句话说:spec(设计规格)回答「芯片该做什么」,testplan 回答「我打算怎么证明它做到了」,覆盖率回答「证明过程实际发生了没有」。三者之间任何一环断掉,签核(sign-off)就站不住脚。
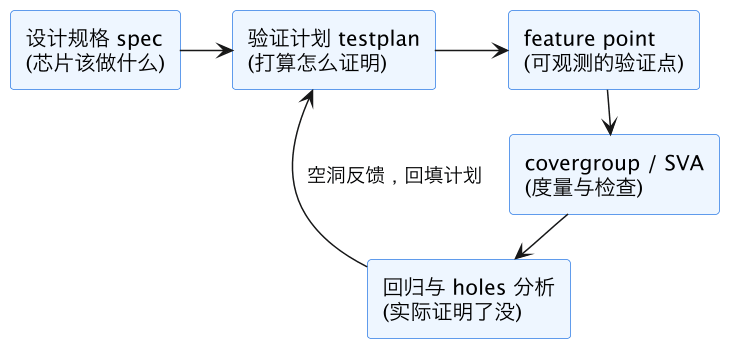
这张图表达的是验证闭环:信息从 spec 单向流到覆盖率模型,而回归发现的空洞要反向回填到 testplan——要么补约束、要么补定向序列、要么承认该场景不可达并记录 waiver(豁免)。覆盖率收敛与签核 讲的就是图右半段的收敛动作,本文聚焦左半段:testplan 本身怎么写,以及它与覆盖率的映射关系。
二、testplan 的标准章节结构
一份能用于工业签核的 testplan,章节骨架基本固定。差别只在文档载体:中小项目用 Markdown/Excel,大项目用 vManager、Verisec 等可追溯性平台,条目会带唯一编号(如 FP_FIFO_012),但内容结构一致。
| 章节 | 写什么 | 不落好会怎样 |
|---|---|---|
| DUT 概述 | 被测模块的功能边界、接口列表、时钟复位、配置方式、不包含什么 | 范围蔓延或漏测整块逻辑 |
| 特性列表 | 从 spec 提炼的 feature 清单,每条带编号与来源章节 | 凭印象验证,无法回答「需求覆盖了没」 |
| 验证场景 | 每个 feature 的正常场景、边界场景、异常场景、场景间组合 | 只测 happy path,边角全靠流片后发现 |
| 检查策略 | 数据完整性检查(scoreboard)、协议检查(SVA)、状态检查分别放哪 | 激励跑到了却没人判对错 |
| 通过标准 | 功能覆盖率/代码覆盖率阈值、断言要求、残余项处理方式 | 项目「永远差一点」,无法客观宣布完成 |
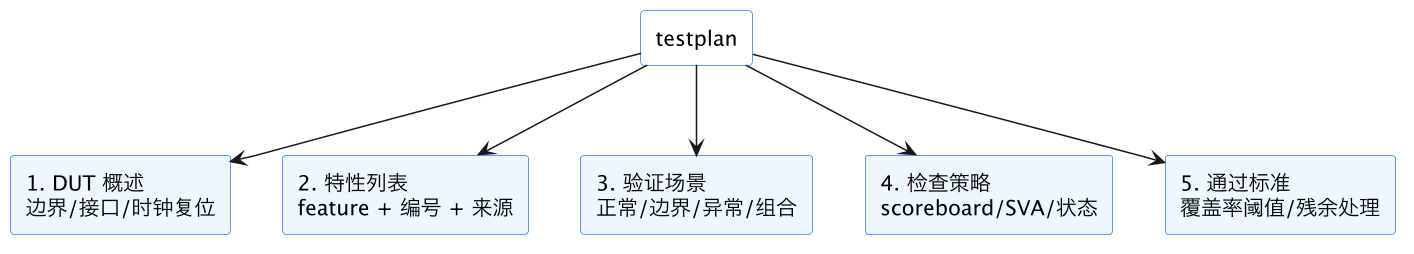
图中五个章节不是平行的摆设:特性列表是主干,场景是对每条特性的展开,检查策略回答「场景跑起来后看什么」,通过标准则把「看什么」量化成可判决的数字。DUT 概述看似模板,却有一个常被忽略的必填项——明确写出不验证什么(out of scope),比如某 FIFO 的可测性逻辑交给 DFT 阶段,这行字能避免后期无休止的责任争议。
通过标准要在项目开头就定死,典型口径如:功能覆盖率 100%(ignore_bins 除外)、行覆盖 99%、翻转覆盖 95%、所有断言 0 失败、每个未命中 bin 都有书面解释。收尾时再定标准,等于边考试边改及格线。
特性列表本身还有两个格式要求值得专门说。一是每条 feature 必须标注来源:对应 spec 的章节号或表号,评审时有人质疑「这条需求哪来的」,一翻即得;设计后期 spec 变更时,也能顺着章节号反查受影响的 feature,评估回归影响面。二是每条 feature 要有优先级,通常分 P0/P1/P2:数据正确性、协议合法性这类 P0 特性必须 100% 收敛才允许签核;边角统计、调试可见性这类 P2 特性允许在资源紧张时带着 waiver 延期。优先级不是装饰,它决定回归机器时分给哪条序列、以及签核会上哪些残余项可以谈。
三、把 feature 拆成可验证的 feature point
特性列表里的原始 feature 通常还是一句话,粒度太粗,没法直接写 coverpoint。比如「FIFO 满标志行为正确」这句话,随机环境里根本无法度量。拆解的动作是:沿着「输入空间 × 内部状态 × 输出行为」三个维度,把它切成一组取值有限、可以被采样、命中与否没有歧义的小点,即 feature point。
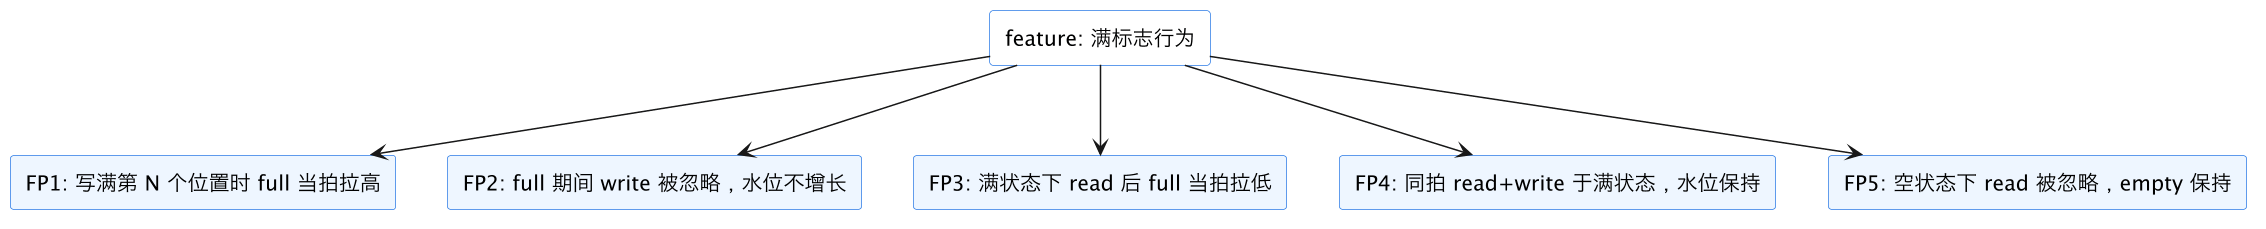
图里五个 feature point 体现了拆解的几个常用判据:FP1 是正常路径上的边界值,FP2/FP5 是异常输入被拒绝,FP3 是退出边界的动作,FP4 是两个合法操作撞在同一拍的组合场景。判断一个点拆得好不好,用三句话测试:它能否被采样到?取值空间是否有限?命中与否是否没有争议? 三个问题有一个答不上来,就说明这个 feature point 还太模糊,需要继续拆或改写。
新手常犯的错是把实现细节当成 feature point,比如「内部 wr_ptr 格雷码翻转」——那是设计怎么实现的问题,验证关心的是可观测行为(读出来的数据对不对、标志对不对),实现细节由代码覆盖和结构检查兜底。反过来,也别把 feature 直接抄成点,「验证 FIFO」拆成「FIFO 正常工作」等于没拆。
四、feature point 到 covergroup/coverpoint/covercross 与 SVA 的映射
拆完点之后,每个点要被两类机制接管:功能覆盖率回答「这个场景发生过没有」,SVA 断言回答「发生时行为对不对」。这两者不可互替——一个 bin 被命中只说明场景出现了,不说明 DUT 的反应正确;一条断言通过也只说明被检查的窗口内没违规,不代表这个窗口真的在回归里出现过。
映射到 SystemVerilog 覆盖率结构时,分工如下:
| 覆盖率构件 | 承接哪类 feature point | 例子 |
|---|---|---|
| coverpoint | 单一维度上的取值/区间/边界 | 水位取到 0、1、N-1、N |
| bins | 具体要命中的值或转换 | 水位 15 → 15(满下再写被忽略) |
| covercross | 两个以上维度的组合场景 | 水位 × 同拍读写使能 |
| illegal_bins | 协议禁止、命中即报错 | 非空状态下 empty 拉高 |
| ignore_bins | 物理不可达、需说明理由 | 配置深度之外的水位值 |
| SVA assertion | 时序关系与逐周期义务 | full 拉高当拍,写使必被忽略 |
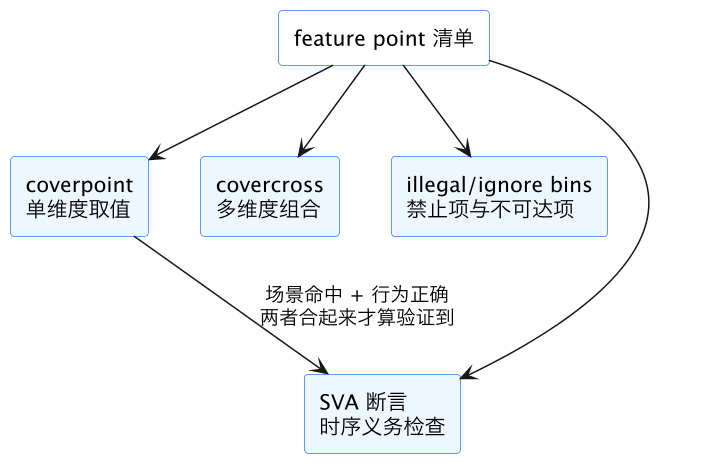
图中底部那条横向关系是这一节的核心:覆盖与断言成对出现才算闭环。coverpoint 标记场景出现,SVA 保证场景下行为正确,scoreboard 则在更上层保证端到端数据正确。映射时给每个 feature point 标注它由哪个 coverpoint/cross(带名字)和哪条断言(带 label)承接,这些名字就是后面追溯矩阵里的锚点。
断言的写法与 bind 挂载方式见 SVA 断言实战,covergroup 的语法细节见 代码功能覆盖率。
五、完整例子:一条 FIFO 特性从 testplan 到 covergroup
把前面的步骤串起来。testplan 里的条目是:
FP_FIFO_04:深度 16、位宽 8 的同步 FIFO,写满后 full 拉高;满状态下 write 必须被忽略;满状态下同时 read 与 write 时水位保持且不丢数据。来源:spec 3.2 节。优先级 P1。
这个条目在验证环境里落成一个 covergroup 加一组断言。采样事件绑在时钟沿,水位 level 由 monitor 从接口信号推算(不直接读 RTL 内部信号,保持黑盒视角):
covergroup cg_fifo_full @(posedge clk);
  cp_level: coverpoint mon_level {
    bins empty = {0};
    bins one   = {1};
    bins mid   = {[2:14]};
    bins full  = {15, 16};      // 水位到达深度上界
  }
  cp_rw: coverpoint ({wr_en, rd_en}) {
    bins w_only = {2'b10};
    bins r_only = {2'b01};
    bins both   = {2'b11};      // 同读同写
    bins neither= {2'b00};
  }
  cx_full_rw: cross cp_level, cp_rw {
    ignore_bins no_full = binsof(cp_level) intersect {[0:14]};
    // 交叉后只保留 full × 三种使能组合
  }
endgroup

// 配套 SVA:full 期间写使能必须无效(或数据不被接收)
a_no_write_when_full: assert property (
  @(posedge clk) disable iff (!rst_n)
  full |-> ##1 ($stable(mon_level))
) else $error("FP_FIFO_04: level changed while FULL");
这段代码与 testplan 条目的对应关系可以逐条核对:full bin 覆盖 FP_FIFO_04 的前半句(满标志状态被到达);cross 里的 full × w_only 与 full × both 覆盖后半句两个场景;断言保证这些场景发生时水位不增长;数据不丢则由 scoreboard 比对出入队数据承接。追溯关系如下。
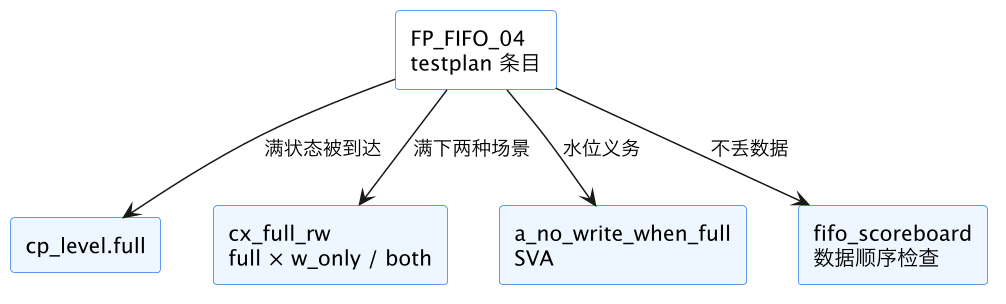
图里一个 testplan 条目扇出到四个承接点,这正是映射的常态:一条特性通常需要「取值覆盖 + 组合覆盖 + 断言 + 端到端检查」合力才能证明。反过来也要保证每个承接点指得回某个条目——图里如果出现一个找不到来源的 coverpoint,它就是冗余候选。
如果是 APB 从设备,拆法完全同构:feature「不支持的地址返回错误」会拆成 PSEL 有效且 PADDR 落在空区、PENABLE 周期内 PSLVERR 拉高、与正常读交叉等 feature point,分别落到地址 coverpoint、地址 × 传输阶段 cross、以及检查 PSLVERR 时序的 SVA 上。方法不变,换的只是信号名。
六、双向可追溯:不漏测与不冗余的机制
映射做完,靠一张追溯表(traceability matrix)把关系固化下来。行是 feature point,列是承接机制,格子里填具体名字:
| feature point | coverpoint/cross | SVA | scoreboard | 状态 |
|---|---|---|---|---|
| FP_FIFO_04 满下写忽略 | cp_level.full, cx_full_rw | a_no_write_when_full | fifo_sb | 已实现 |
| FP_FIFO_05 空下读忽略 | cp_level.empty, cx_empty_rw | a_no_read_empty | fifo_sb | 已实现 |
| FP_FIFO_06 复位清空 | cp_rst_cold | a_reset_state | — | 待实现 |
双向检查的含义是两个方向各扫一遍:正向从 feature point 出发,任何一行存在空格子就是漏测——要么没有覆盖,要么没有检查;反向从 coverpoint/断言出发,任何一个构件在表里找不到对应条目就是冗余——它可能是从别处复制来的无效覆盖,也可能是 testplan 漏写了条目,需要判断后删除或补登。

这张图刻意画成双向箭头:正向链路保证不漏测,反向链路保证不冗余。实践中反向链路更容易断——验证工程师随手加 coverpoint 很常见,回归合并后覆盖率报表里堆着几十个和 spec 毫无关系的 bin,既稀释注意力又拖慢仿真。规则很简单:没有 feature point 编号的覆盖构件,不允许合入环境。 工具层面,vManager 之类的平台能自动做这种一致性检查;用 Markdown 管理时,评审会上逐行对表即可。
七、覆盖率规划与 holes 分析
testplan 不是写完即冻结,它在回归阶段还要被覆盖率数据反复回访。holes 分析的对象是「命中不了或命中次数过低的 bin」,处理时先分类再动手,不同原因对应完全不同的动作:
| holes 表现 | 根因 | 处理动作 |
|---|---|---|
| bin 合法但 0 命中 | 约束把取值空间限死了 | 放松/修改约束,换 seed 多跑 |
| bin 需要特定序列才出现 | 纯随机构造不出前置状态 | 写定向 sequence 注入 |
| bin 物理上不可达 | 配置或协议使其永不为真 | 转 ignore_bins 并书面说明 |
| bin 偶尔命中、回归不稳定 | 场景依赖长状态链 | 加强分层序列,保证可复现 |
| 总覆盖率高但某 cross 常年 0% | 维度组合爆炸、注意力被平均数稀释 | 拆分 cross,只保留需求相关组合 |
关键纪律是:不许靠无限增加回归次数掩盖 holes。一个需要 200 万周期才偶然出现一次的场景,流片后也只会以同样低的概率被系统级测试碰到,正确做法是分析它为什么难出现,用定向序列把它变成稳定命中,或者明确承认不可达。判断「命中次数够不够」也有经验口径:一个 bin 在单次种子里命中一次,可能只是巧合;通常要求它在多个不同种子下重复命中(比如至少 5 个独立 seed),才能说明该场景不是被某条特定随机序列偶然擦到,而是环境确实能稳定构造它。
holes 分析还要注意覆盖率的合并口径:几十个 seed 分布在不同机器上跑,只看单个 seed 的报表会把大量「合计已命中、单看都没命中」的 bin 误判成空洞。先全量合并,再逐 bin 下钻,顺序不能反。合并工具和排除规则的细节,覆盖率收敛与签核 里有完整做法。每处理一个 hole,testplan 对应条目都要留下结论——已收敛、由哪个 seed/sequence 命中、还是转入 waiver 并给出理由。这使得最终签核时,任意一条需求都能现场演示完整证据链:spec 章节 → feature point → 覆盖构件 → 命中它的回归记录。
这一篇在知识体系里的位置
本文处在验证流程的最上游:testplan 决定了「验证什么」,下游各篇分别回答「用什么验证」。平台搭建见 SystemVerilog Testbench 实战,随机激励与约束见 受约束随机验证 CRV,断言承接见 SVA 断言实战,覆盖率语法见 代码功能覆盖率,testplan 右半段的回归收敛与签核口径见 覆盖率收敛与签核。读完这组文章,就具备了从 spec 到 coverage sign-off 跑通一条完整链路的基础。
总结
验证计划 testplan 是验证收敛的源头:用 DUT 概述、特性列表、场景、检查策略、通过标准五段结构把「怎么证明芯片做对了」预先定死,把每条 feature 沿状态、输入、行为拆成可采样、无歧义的 feature point,再让每个点由 coverpoint/covercross 度量「场景发生过没」、由 SVA 与 scoreboard 保证「发生时行为对不对」,借助追溯矩阵做正向不漏测、反向不冗余的双向检查,回归后对 holes 按约束、序列、不可达分类处理并回填计划——最终每条需求都能拿出从 spec 到命中记录的完整证据链,这才是可签核的功能验证。