KV cache 卸载:GPU/CPU/SSD 三级分层、预取流水线与长上下文命中率设计
更新时间:2026-10-01。在 KV cache 显存管理 里我们把容量账算清楚了:显存是第一约束,量化、GQA、分页能把账做小,但总有装不下的那一天——上下文拉到 128K、并发开到几十路,KV cache 的总量会毫无悬念地越过 HBM 的物理上限。KV cache 卸载就是这一刻登场的:把暂时用不到的 KV 从 GPU 搬到 CPU 内存、必要时再沉到 SSD,用「更大的慢存储」换「更多并发和更长上下文」。它不是免费的,三级存储的延迟差着两三个数量级,工程上全部的功夫都花在「怎么把搬运的代价藏进计算的空隙里」。GPU 侧的块式管理见 PagedAttention 与 vLLM 推理服务,搬运通道本身的学问见 CUDA pinned memory 与显存传输。
本文要回答的问题
- GPU HBM、CPU DDR、NVMe SSD 三级的延迟和带宽差多少?差出来的部分由谁买单?
- KV cache 卸载的换出/换入动作发生在调度的哪个时机?谁决定换谁?
- 逐层预取和异步传输流水线怎么把换入延迟藏到计算后面?
- 长上下文和多轮对话场景下,换出候选怎么选、命中率怎么设计?
- 卸载与量化、重算(recompute)之间怎么搭配,各自的盈亏线在哪里?
一、三级存储的账本:延迟差着数量级
KV cache 卸载的全部设计约束来自一张物理账:GPU HBM、CPU 内存、SSD 三级的容量、带宽、延迟完全不在一个量级上。HBM 是 decode 的主战场——KV cache 显存管理 里说过,decode 是 memory-bound,吞吐几乎完全由 HBM 带宽决定。CPU 内存(DDR5)带宽是 HBM 的几十分之一,但容量便宜一个数量级;NVMe SSD 再降一到两个数量级,容量却近乎无限。
| 层级 | 典型容量 | 读带宽 | 随机访问延迟 | 每 GB 成本 |
|---|---|---|---|---|
| GPU HBM3 | 80~141 GB/卡 | 2~3.4 TB/s | ~百 ns 级 | 基准(最贵) |
| CPU DDR5 | 512 GB~2 TB/机 | 300~500 GB/s(整机多通道) | ~100 ns | HBM 的 1/10 左右 |
| NVMe SSD | 数 TB | 5~7 GB/s(单盘) | 50~100 μs | HBM 的 1/100 量级 |
注意两个容易被误读的点。第一,GPU 到 CPU 之间隔着 PCIe/NVLink,HBM 的 3 TB/s 到主机内存只剩 PCIe 4.0 x16 的 ~25 GB/s 单向实测——也就是说「CPU 内存带宽 400 GB/s」这个数字,卸载场景下根本用不到,瓶颈在互连。第二,SSD 的 μs 级延迟相对 decode 单步十几 ms 的预算看似可接受,但那是单盘顺序读;几百路并发同时换入时,SSD 的 IOPS 先崩,排队延迟会飙到几十 ms,直接击穿 TTFT(首 token 时延)的服务等级目标。三级账本一句话:HBM 装活跃集,DDR 当缓冲区,SSD 只做冷归档,且每一级都要当「缓存」来管命中率,而不是当「内存」来随便用。
上图画出了卸载的数据通路:KV 从 HBM 出发,必经互连这道窄门才能到 DDR,再到 SSD。任何卸载方案的第一性计算都是「搬多少字节 × 互连带宽 = 多少毫秒」,然后问这笔毫秒数能不能被藏掉——这正是后面预取流水线要回答的问题。
二、卸载的调度时机:换出发生在哪、换谁
KV cache 卸载在调度器眼里是「块粒度的上下迁移」。延续 PagedAttention 与 vLLM 推理服务 的块表机制,每个物理块多了一个位置标记:在 HBM、在 DDR、还是已被驱逐。换出(swap-out)发生在三个典型时机:一是新请求进来而 HBM 满,挑候选块腾出位置;二是某请求处于等待状态(比如等检索结果、等工具调用返回),整个序列的 KV 可以暂时离卡;三是 decode 批次排不进时,把低优先级请求整个挂起换出,等高优请求跑完再换回来——vLLM 早期版本的 preempt + swap 就是这个思路。
换入(swap-in)的时机更讲究。请求被重新调度上前,它的 KV 必须在 HBM 里。朴素做法是先换入再开算,换入多少毫秒,TTFT 就平白多多少毫秒——几十路的量加起来,用户会明显感到卡顿。所以工程上换入必须走异步通道并尽量与计算重叠,这是下一节的主题。
候选选择直接决定卸载的代价。一个好的换出策略要同时看三个信号:最近被注意力读到的概率(LRU 类)、序列当前所处的阶段(prefill 中的请求马上要用全量 KV,不该换;decode 中的请求每步都要全表读,更不该换)、以及换出的字节成本(越长的序列换出越贵,但它往往也是最不常被抢占的高价值请求)。实践中「换出整个挂起请求的全部 KV」比「换出活跃请求的部分前缀」安全得多——后者的部分换出会引入「这步要用、上一步刚换走」的抖动。
这张图是卸载决策的主循环。关键点在于「选候选」这一步的判断标准写在出边上:调度器只在 HBM 水位不足时才动手,且优先牺牲已经挂起的请求。把候选选择做成显式策略而不是随机驱逐,是命中率设计的起点。
三、预取与异步流水线:把换入延迟藏进计算
卸载能不能用,核心看换入延迟能不能被重叠。直接同步换入是最差方案:25 GB/s 的互连上搬 10 GB 就是 400 ms,全部加在 TTFT 上,不可接受。工程上有三层手段把它藏掉。
第一层是异步传输。拷贝引擎走独立的 CUDA stream,与计算 stream 并行——Host-to-Device 的 DMA 不占用 SM,计算可以同时进行。前提是 CPU 侧缓冲区必须是 pinned memory(页锁定内存),否则驱动要先拷到内部的 staging 区,带宽直接腰斩;pinned 缓冲区怎么分配、为什么要环形复用,CUDA pinned memory 与显存传输 里讲得完整,这里只引用结论:传输流水线的地基是 pinned buffer 池。
第二层是逐层流水(layer-wise pipelining)。这是卸载方案里最关键的一招:Transformer 的注意力是逐层算的,第 0 层的 attention 只需要第 0 层的 KV。于是换入不必「全量搬完再开算」,而是「边算第 i 层、边搬第 i+1 层」。只要单层换入时间 ≤ 单层计算时间,整条链路就几乎没有额外延迟。一笔账:70B 模型单层 KV(GQA + INT8)大约 20~40 MB 每千 token,一条 8K 历史的请求单层 200 MB 上下,25 GB/s 互连上搬一层约 8 ms;而 70B 模型一层 decode 的计算加权重读取时间也在 5~10 ms 量级——两者基本打平,流水恰好成立。这也解释了为什么「逐层」是卸载的黄金粒度:再细(逐 token)传输次数爆炸,再粗(整个请求)藏不住。
第三层是预取(prefetch),比流水更进一步:在请求还没被调度上前,就根据队列顺序提前开始换入。调度器只要维护「下一个大概率被恢复的请求」的预测,预取就能把换入延迟从「部分重叠」推进到「接近全隐藏」。预取错了的代价只是白搬一趟,没有正确性风险,所以可以做得比较激进。
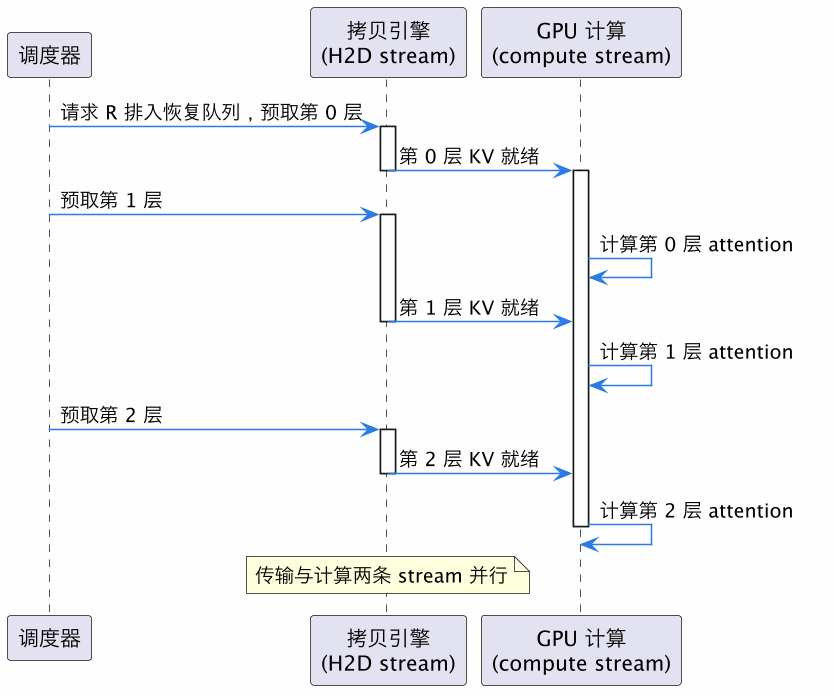
这张时序图把三层手段的前两层画在了一起:拷贝引擎在 GPU 算第 i 层的同时搬第 i+1 层,时间轴上交叠,端到端只多出「第 0 层」那一次启动延迟。第三层预取则把这一次启动延迟也挪到了请求排队期间。三层叠加后,KV cache 卸载对 TTFT 的影响从几百 ms 压到十几 ms 以内——这就是「卸载可用」和「卸载不可用」的分界线。
四、长上下文与多轮对话:命中率设计
前两节解决「怎么搬」,这一节解决「搬谁留下」——即命中率问题。卸载本质上是把 HBM 当缓存、把 DDR/SSD 当主存,缓存系统的生死指标是命中率,而命中率完全由工作负载的访问模式决定。
长上下文场景(文档问答、代码仓库分析)的访问模式是「一次灌入、多次查询」。128K 的文档 prefill 一次产生 128K token 的 KV,之后每一轮提问都要读全表。这里的设计要点有三:其一,前缀共享——同一文档的多个会话复用同一份 KV 物理块(PagedAttention 的块共享机制天然支持),卸载时整份只留一个副本,DDR 占用按文档数而非会话数计;其二,文档级热度分层——被频繁提问的文档常驻 HBM 或 DDR 热区,冷文档可以沉 SSD,命中率的分布曲线服从典型幂律,头部 20% 文档吃 80% 流量;其三,回填策略保守——从 SSD 拉回一个 128K 文档要几秒,绝不能因为一次偶然命中就整体拉回,常见做法是要求连续命中两次以上才升级层级。
多轮对话场景是另一种模式:每轮对话在上一轮 KV 后面追加,会话的活跃度天然服从「最近活跃的最可能继续活跃」。这里的卸载设计围绕「会话生命周期」展开:用户打字期间(秒到几十秒)KV 完全可以离卡放 DDR;会话沉默超过阈值(几分钟)沉 SSD 或直接丢弃——丢弃的代价是用户回来时重算 prefill,对短会话重算比换入还便宜。于是出现一个反直觉的结论:多轮对话场景里,SSD 层常常不如「重算」划算;SSD 卸载真正的主场是超长、重算代价高的文档前缀。
上图是完整的层级状态机。两条关键的出边标签体现了策略保守性:冷区回填要求「连续命中两次」,短会话走「丢弃重算」而非下沉。这两个设计把 SSD 的慢尾巴隔离在了主路径之外。
五、卸载、量化与重算的搭配:盈亏线在哪
最后一节把卸载放回工具箱里看位置。KV cache 装不下时有三个方向:压缩(量化、GQA 已在 KV cache 显存管理 展开)、迁移(本篇的卸载)、消除(重算,vLLM 的 recompute 抢占)。三者不互斥,但各有盈亏线。
| 手段 | 省什么 | 花什么 | 盈亏线 |
|---|---|---|---|
| INT8/INT4 量化 | 容量 ÷2 / ÷4 | 精度、反量化开销 | 几乎总是该先做,是卸载的前置 |
| 卸载到 DDR | HBM 容量 | 互连带宽、TTFT 尾巴 | 换入时间能被逐层流水藏住才划算 |
| 卸载到 SSD | DDR 容量 | 秒级回填延迟 | 只对超长、高复用的冷前缀成立 |
| 重算 recompute | 全部 KV 容量 | 一次 prefill 算力 | 短序列便宜,长序列昂贵 |
经验上的搭配顺序是:先把量化打满(INT8 起步),把活跃集塞进 HBM;溢出的挂起会话和温文档卸载到 DDR,配逐层流水;SSD 只收「重算一次要几十秒」的超长冷文档;短会话直接重算。
还有两个容易踩的坑值得单独点出。一是 DDR 侧本身也要分页管理:卸载过去的块如果按请求整段连续摆放,几十路会话反复换入换出之后同样会出现外部碎片,最终「总量够但找不到连续段」——DDR 层照搬 PagedAttention 的块池思路,用同样大小的块管理,就能和 HBM 层共用一套块表代码,只是物理地址指向主机内存。二是别忘了把传输带宽计入容量规划:PCIe 4.0 x16 的 25 GB/s 是所有卸载流量共享的总水管,若业务峰值要同时恢复几十路挂起会话,水管先被打满,排队延迟会让 TTFT 集体恶化——这也是为什么高端推理节点偏爱 NVLink/PCIe 5.0 平台,互连带宽翻倍直接等于卸载容量翻倍。这个顺序背后的统一判据只有一句话:比较「搬/重算的成本」与「占着 HBM 的机会成本」,谁小选谁。HBM 的机会成本就是被挤掉的那路并发本来能贡献的吞吐——在满载集群上这个成本很高,所以卸载几乎总是值得做;在负载稀疏的机器上 HBM 空着也是空着,反而没必要折腾复杂的换出策略。
这一篇在知识体系里的位置
本篇是 KV cache 三部曲中「容量溢出之后怎么办」的一集:显存内的账与压缩手段在 KV cache 显存管理,块式管理与调度衔接在 PagedAttention 与 vLLM 推理服务,本篇则向外延伸一层,讲 HBM 之外的三级存储怎么接力。往下游,传输通道的 pinned buffer、DMA 细节在 CUDA pinned memory 与显存传输;往上游,decode 为什么是 memory-bound 的根因在同目录的显存层级篇。再往外,把卸载放到整机集群维度——请求在不同 GPU、不同节点间怎么摆放——就进入了分离式推理(prefill/decode 分离、KV 池化)的地界,那是下一层的故事。
总结
KV cache 卸载是把 HBM 当缓存、把 DDR/SSD 当主存的分层系统:三级存储延迟差两三个数量级,能不能用全看换入延迟能否被 pinned buffer 异步传输、逐层流水和预取藏进计算空隙;而命中率设计则按工作负载分流——长文档靠前缀共享与保守回填,多轮短会话常常直接重算更划算,选卸载还是重算的统一判据是搬运成本与 HBM 机会成本之比。