DMA 通道优先级仲裁:固定优先级、轮询与加权混合模式的公平性验证
更新时间:2026-10-07。一颗 8 通道 DMA 控制器,常见事故现场是这样的:音频通道挂着最高优先级持续搬运样点,低速的 UART 通道挂着最低优先级,跑着跑着串口丢字节——一查,低优先级通道的请求被压了 3 毫秒没得到响应,FIFO 溢出。这类问题功能仿真里「单通道传输全对」完全测不出来,必须多通道同时发压、用专门的公平性 checker 盯仲裁器输出。DMA 通道优先级仲裁的验证,核心是把「谁先服务、谁等多久、会不会饿死」三件事用断言和覆盖率钉死。本篇是 chip-design/verification 目录的 S 层标准篇,单通道传输语义见 DMA 描述符预取验证,仲裁器形式化证明思路见 仲裁器属性的形式化证明。
本文要回答的问题
- DMA 通道仲裁常见的几种模式(固定优先级、轮询、加权混合)各是什么语义,验证侧重点有何不同?
- 「严格抢占」和「传输粒度内不可抢占」边界怎么定义,checker 怎么写?
- 同优先级轮询的公平性如何用断言量化,而不是靠肉眼扫波形?
- 饿死(starvation)检测的超时阈值怎么定,长随机回归怎么构造激励?
- 覆盖率要收哪些 cross 才能证明仲裁逻辑被充分遍历?
一、三种仲裁模式的语义与验证侧重点
DMA 控制器的通道仲裁器(channel arbiter)解决一个问题:同一拍有多个通道的 request 有效,这一拍的总线/数据通路给谁。常见实现分三类:
| 模式 | 语义 | 优点 | 典型风险 | 验证侧重点 |
|---|---|---|---|---|
| 固定优先级(fixed priority) | 通道号或配置位决定静态优先级,高优先级永远先服务 | 逻辑最简单、延迟可预期 | 低优先级可能饿死 | 严格优先级次序、饿死上界 |
| 轮询(round robin) | 服务过的通道排到队尾,请求者循环获得授权 | 天然公平 | 实时通道延迟不可控 | 轮转次序正确性、授权间隔有界 |
| 加权混合(weighted / hybrid) | 每组通道配权重,高权重占比高,常在高优先级组内再轮询 | 兼顾实时与公平 | 权重配置组合爆炸 | 长期带宽配比、组内公平、配置合法性 |
很多商用 DMA(如典型的两优先级组 + 组内轮询结构)是第三类的特例:通道配成 high/low 两组,high 组整体先于 low 组,组内轮询。验证计划必须先画出这个结构再写 checker,否则把「组间严格优先级」和「组内轮询」混为一谈,checker 必然误报。
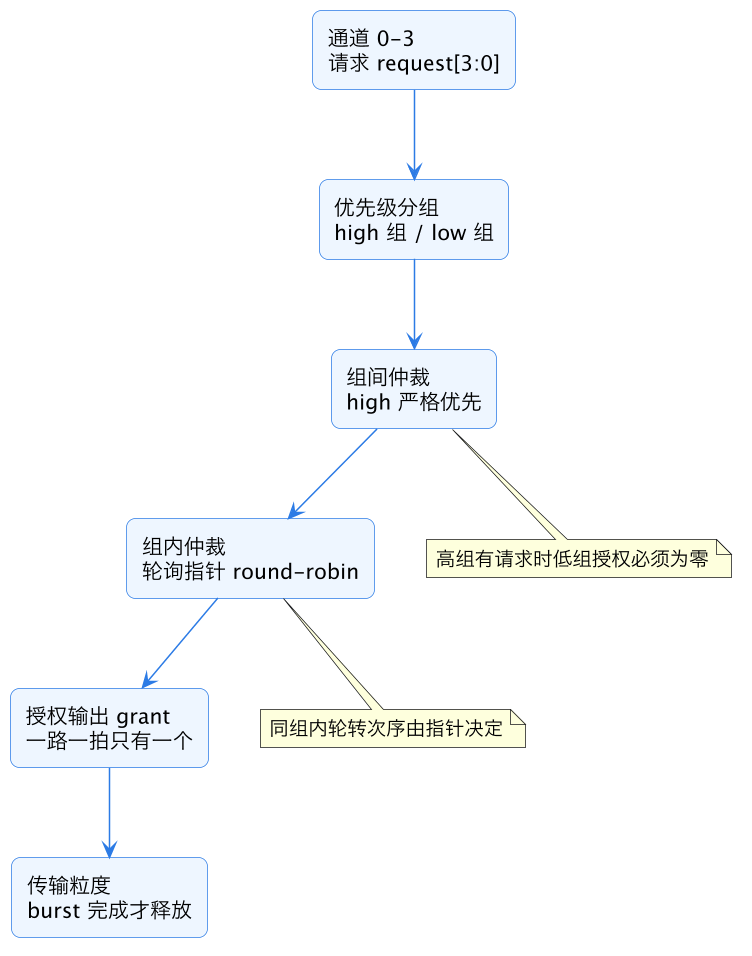
上图是混合模式仲裁器的两级结构:先组间、后组内。组间那一级用「高组有请求时低组 grant 恒为零」一条断言就能钉死;组内那一级要追踪轮询指针(round-robin pointer)的更新时机——关键点是指针应该在「一次完整传输结束(burst 完成或描述符收尾)」时更新,而不是每拍更新,否则同一个通道可能被连续授权打断别人的公平轮转。checker 必须区分这两个粒度。
二、抢占边界:先定义「最小不可打断单元」
仲裁验证最容易翻车的地方,是 spec 里「高优先级抢占低优先级」这句话没说清抢占粒度。真实设计几乎都是「burst 粒度不可抢占」:当前通道已经开始一个 AXI burst(比如 16 beat),高优先级请求来了也要等这个 burst 发完才切权,否则总线协议本身不允许中途换主。所以 checker 里的抢占规则要写成:
「高优先级请求有效的第一个可以切权的边界(当前 burst 最后一拍握手完成)之后,下一个 grant 必须给高优先级组。」
而不是「高优先级请求一有效,低优先级 grant 立即撤销」——后者必然误报。验证侧要和设计确认三件事:切权边界是 burst 级、描述符级还是 block 级;正在进行的 burst 期间 grant 信号是否允许变化(绝大多数实现是锁存的);通道 FIFO 预取的数据在切权后是否作废(作废就要查数据一致性,不作废要查恢复逻辑)。
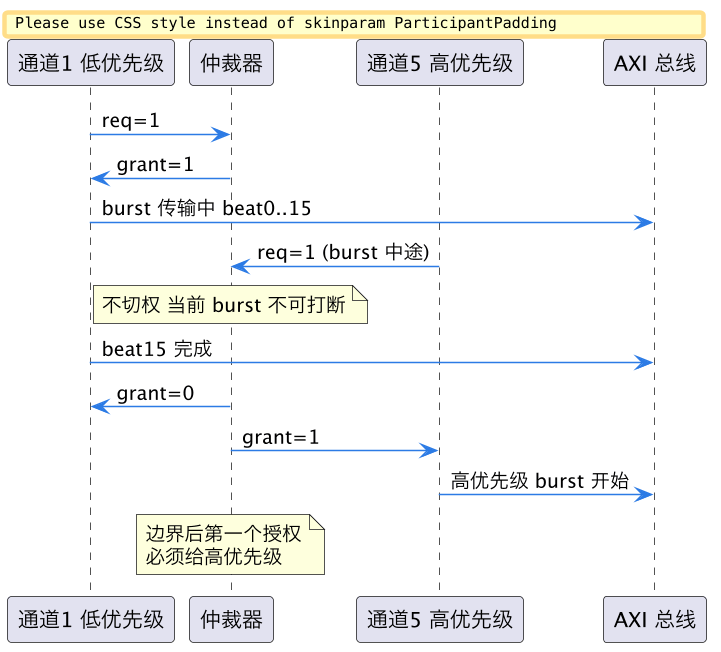
这个时序就是抢占 checker 的语义基准:高优先级请求在 burst 中途到达,仲裁器保持低优先级 grant 直到 burst 边界,然后边界后的第一个 grant 给高优先级。写断言时用「高组请求有效且不在 burst 中段」作为前提条件,用 s_eventually 或固定拍数上限约束授权切换。如果设计声称支持「拍级抢占」(少数 SRAM 侧内部仲裁允许),那粒度断言整个反过来写——这就是为什么要先和设计对齐粒度,再动笔。
三、同优先级公平性:把「轮询」写成可判定的东西
组内轮询(round robin)的公平性验证,不能停在「波形上看着大家轮着来」。要写成可判定的性质,常用三条:
- 次序正确:一次完整轮转内,每个持续请求的通道恰好被服务一次。比如 4 个通道都挂着请求,授权序列应该是 0→1→2→3→0 的循环(起点由指针初值决定),不允许 0→1→0→1 把 2、3 晾在一边。
- 授权间隔有界:通道 i 持续请求时,两次获得 grant 之间的拍数有确定上界,通常是「同组持续请求通道数 × 单次传输拍数」的量级。
- 空请求跳过:轮转指针扫到没有请求的通道时必须跳过,不能空转一拍浪费带宽。
第三条经常出 bug:指针每拍加一但对应通道无请求时,有的实现会「等一等看看」,白白损失一拍吞吐。写一条断言「当前指针位置无请求时,当拍 grant 必须给下一个有请求的通道」,性能问题也顺手查了。
// 组内轮询公平性:持续请求者的最大等待拍数
property p_fairness_bound;
  int unsigned wait_cnt;
  @(posedge clk) disable iff (!rst_n)
    (req[2] && !grant[2], wait_cnt = 0)
      |=> (req[2] && !grant[2], wait_cnt++)[*0:$]
          ##1 (grant[2] || wait_cnt > MAX_WAIT);
endproperty
a_fair_2: assert property (p_fairness_bound)
  else $error("CH2 starved beyond MAX_WAIT");
上面这段是思路示意:对每个通道例化一份,MAX_WAIT 由「组内最大通道数 × 最大 burst 拍数」算出来写死成常量,比如组内 4 通道、最大 16 beat burst,MAX_WAIT 取 4×16+若干握手余量 ≈ 80 拍。这个数字不要拍脑袋——阈值太松漏检真实饿死,太紧全是误报,从结构参数推导是唯一靠谱的来源。轮询仲裁器的独立验证方法还可以参考 轮询仲裁器验证,加权公平性的量化判据见 加权仲裁公平性验证。
四、激励构造:让仲裁器真正「难做抉择」
随机激励随便跑,仲裁器大部分拍数里只有一个通道有请求,仲裁逻辑根本没被压到。要让仲裁器为难,激励要刻意构造以下场景:
- 满压场景:所有通道同时挂请求,跑足够长的随机长度传输,检验满负载下的轮转次序和带宽分布。
- 插入式高压:低优先级传输进行中,随机时刻插入高优先级请求,扫遍「在 burst 第 1 拍、中间拍、最后一拍、边界拍到达」各种相位。
- 请求撤消:请求挂上后还没轮到就撤掉(外设 FIFO 被软件读走了),仲裁器不能把 grant 给已撤请求的通道,更不能卡死。
- 背靠背描述符链:单通道连续多条描述符,检验通道在链内是否一直占权(多数实现是)还是每条描述符重新参与仲裁——两种语义都对,但 checker 要按 spec 选一种钉死。
- 运行时改优先级:传输进行中改写通道优先级配置寄存器,检查新配置在哪个边界生效、生效瞬间 grant 是否干净切换。
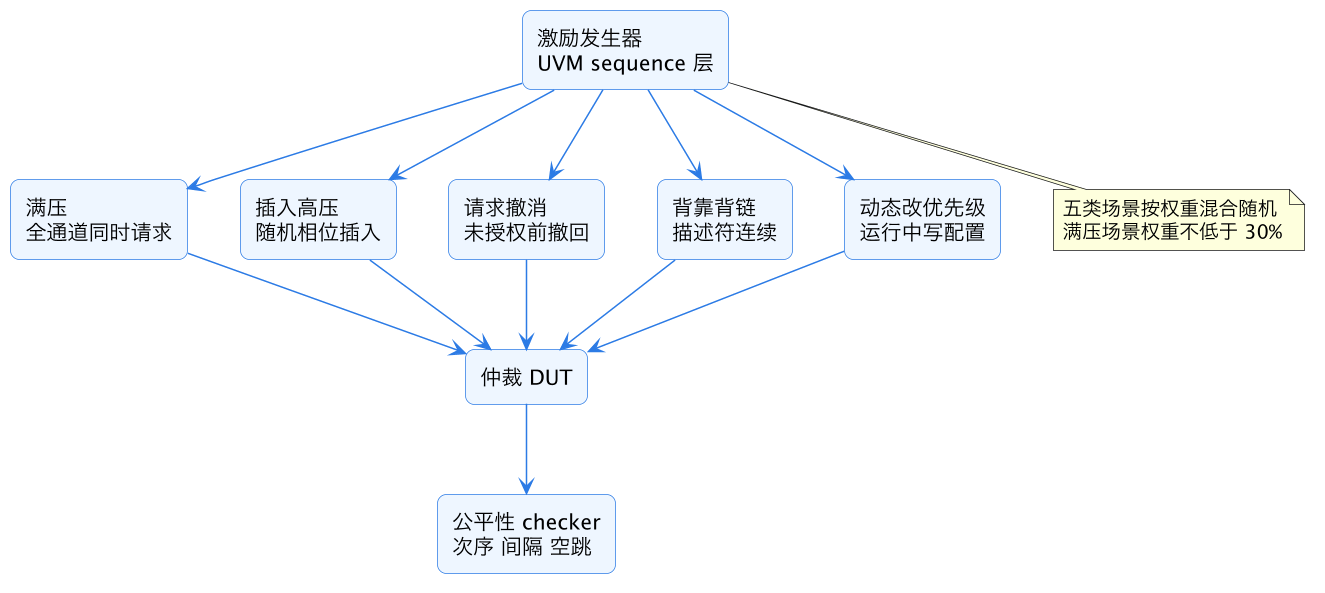
上图里五类场景建议按权重混合进同一个随机回归:满压给 30% 以上权重(它是公平性逻辑的主战场),插入高压和动态改配置各 20% 左右,撤消和背靠背补足其余。UVM 侧用 virtual sequence 统一调度各通道的 agent sequence,约束里把「同时请求通道数」做成可约束随机变量并配 distribution,确保回归里重压力区间(5+ 通道并发)有足够的命中次数。环境搭建套路见 UVM sequence、driver 与 scoreboard。
五、覆盖率:怎么证明仲裁逻辑被遍历了
功能覆盖是仲裁验证的收口证据,至少收四组:
| 覆盖组 | coverpoint / cross | 目标 |
|---|---|---|
| 授权分布 | 每个通道的 grant 次数 bin | 满压下各通道授权次数比例符合模式预期 |
| 并发形态 | 同时请求的通道数(0 到 N)× 授权通道号 | 每个并发档位都命中,重点是 N-1 与 N |
| 优先级切换 | 授权通道的优先级组 transition(low→high、high→low、组内轮转) | 所有合法转移命中,非法转移进 illegal bin |
| 抢占相位 | 高优先级请求到达时当前 burst 的进度分档(前 25%、中 50%、末 25%、边界拍) | 各分档命中,边界拍单独成 bin |
第四组「抢占相位」是经验的精华:大量仲裁 bug 只出现在请求恰好落在 burst 最后一拍或边界那一拍——grant 更新逻辑和指针更新逻辑在两个 always 块里时序错一拍,平时全对,只有这个相位下出现一个通道连拿两次 grant。不给它单独成 bin,随机回归跑一万次也可能只擦边命中几次而没触发 bug。transition bin 的写法见 covergroup transition bins,illegal bin 的取舍见 cross 覆盖率 illegal bins。
断言覆盖率也要同步看:公平性断言的触发次数(cover property 或断言的 attempt 统计)如果满压回归里只有个位数,说明激励根本没把仲裁器压到临界,checker 写得再对也是空转。性能维度的带宽、延迟量化方法可延伸阅读 性能验证。
六、常见 bug 画像与回归组织
仲裁逻辑的面积通常很小——一个 8 通道混合仲裁器综合下来不过几千门——但历史 bug 密度远高于数据通路,因为它的正确性依赖「多请求并发 + 跨拍状态」的组合,定向测试很难靠人手列全。把常见 bug 归成四类画像,测试计划每类至少配一条定向用例。
第一类是「指针更新时机错」。轮询指针在该更新的边界没更新、或不该更新的中途更新了,表现是某通道连续两轮被跳过或连续两次拿权。这类 bug 满压随机激励下命中率很高,但前提是你的公平性 checker 是逐拍检查次序的,只在传输结束时比对总量的 scoreboard 抓不到它。第二类是「grant 毛刺与双授权」。grant 用组合逻辑直接从请求算出、没有寄存,请求撤消的同一拍 grant 也跟着跳,下游状态机采到半个授权;更凶险的是两个通道的 grant 同拍有效,两个引擎同时驱动内部数据总线,仿真里表现为 X 传播。一条「任意拍 grant 至多一个 bit 有效」的断言是所有 DMA 验证环境的标配,成本一行代码,收益是抓最高危的那类。第三类是「配置改写的中间态」。运行中改优先级分组,改写的几拍内仲裁器用了「一半新配置一半旧配置」,授权给了一个按新配置不该排最前的通道;修法令设计在边界锁存配置,验证法令 checker 明确「配置写入到生效之间的窗口内放宽检查、窗口外严格检查」。第四类是「边界拍相位竞争」,即上一节说的请求恰好落在 burst 最后一拍——这类 bug 概率最低、定位最痛,只有相位分档覆盖率逼着重跑才能稳定复现。
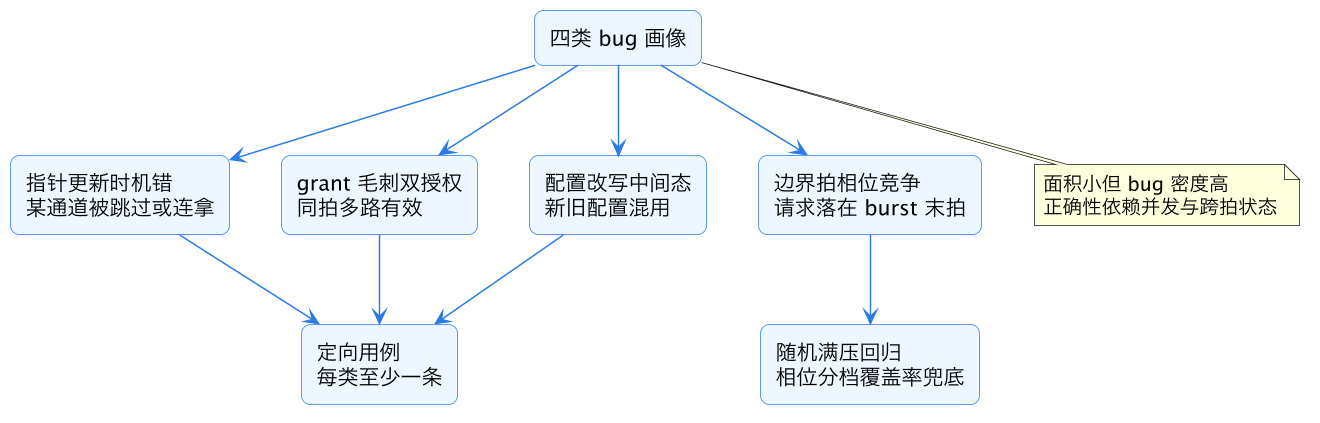
上图把四类画像和对应的验证手段归拢到一起:前三类靠定向用例加逐拍 checker 就能覆盖,第四类相位竞争只能交给带相位分档覆盖率的随机满压回归长期磨。其中双授权一条值得单独强调——「任意拍 grant 独热(one-hot)」的断言要写进每个 DMA 环境的基础断言包,它抓的是可能烧数据通路的硬件级错误。
回归组织上,仲裁测试建议单独成一个 test suite 与数据通路回归并列:数据通路回归跑「通道一个个传、数据对不对」,仲裁回归跑「通道全压上、授权公不公」。每晚的仲裁回归规模不需要大——每个场景类几十个种子、总共两小时以内——但覆盖率模型必须挂在回归里做合并,连续一周的覆盖率趋势比单晚的绝对值更能说明问题:授权分布 bin 如果某天突然不再增长,多半是激励约束被上游改动悄悄破坏了(比如某次重构把并发通道数约束上限写小),趋势图一掉平就该去查激励而不是查 DUT。硅后阶段如果真出现现场丢数据,这套环境里的满压场景通常改几个约束就能复现,这也是前期把场景库建全的回报——复现手段在 Bring-up 阶段比任何调试技巧都值钱,参见 硅后 Bring-up 调试。
这一篇在知识体系里的位置
本篇主关键词是 DMA 通道优先级仲裁,属于 chip-design/verification 目录的 S 层标准篇。向上,它复用 UVM sequence、driver 与 scoreboard 的多 agent 环境骨架和 SVA 断言实践 的断言写法;横向,它与 轮询仲裁器验证、加权仲裁公平性验证、I2C 多主机仲裁验证 同属「仲裁与公平性」验证族,与 DMA 描述符预取验证、DMA scatter-gather 验证 同属 DMA 验证族;需要数学级无饿死保证时,上行路径是 仲裁器属性的形式化证明。
总结
DMA 通道优先级仲裁验证的核心是把三句话变成可判定性质:高优先级「在最小不可打断单元(通常是 burst)边界后必须先拿到授权」、同优先级「轮转次序正确且等待拍数有从结构参数推出的硬上界」、任何通道「持续请求不许饿死」。激励要刻意构造满压、插入高压、请求撤消、背靠背链和动态改配置五类场景,覆盖率用并发形态 × 授权通道、优先级组 transition、抢占相位分档三组 cross 收口——仲裁器这类「平时谁都对、压力下才露馅」的逻辑,只有重压 + 量化公平性 checker + 相位级覆盖率三件套齐备,才算验完。