UVM 寄存器验证方法学:从 RAL 建模、frontdoor/backdoor 激励、adapter/predictor 比对到覆盖率闭环的完整版图
更新时间:2026-10-03。一颗中等规模的 SoC 里寄存器动辄几万个字段:控制状态寄存器(CSR)、中断使能与状态、时钟门控、电源域配置、DDR 时序参数……它们是软件和硬件之间唯一的契约界面,也是流片后最改不起的地方——RTL 逻辑错了还能靠固件绕,寄存器地址表错了、复位值错了、写 1 清零语义反了,软件连绕都没法绕。UVM 的寄存器抽象层(RAL,Register Abstraction Layer)就是为这场仗准备的建制化武器,但现实中很多团队对它的使用停留在「用
uvm_reg_bit_bash_seq跑一遍」的水平,后面一长串方法学资产——双通道互验、predictor 镜像、特殊访问语义、覆盖率模型——全都荒着。本站的 RAL frontdoor 与 backdoor、reg adapter 与 predictor 接线、寄存器 bit-bash 序列 等单篇各自钻了一个点,这一篇是寄存器验证线的枢纽深文:把视角拉高到方法学层面,回答「一个项目的寄存器验证从建模到签核应该长什么样、各环节怎么串、缺口会出在哪」。寄存器验证做塌了通常不是某一步做错,而是版图缺角——比如只有前门没有镜像比对,只跑内建序列没有覆盖率闭环,本文先把整版图一次画全。
本文要回答的问题
- 寄存器验证为什么要以 RAL 模型为中心组织,而不是散落在各个 testcase 里手写地址和掩码?
- frontdoor 和 backdoor 两条访问通道各自验什么、怎么互验,只靠一条会漏掉哪类 bug?
- adapter、predictor、mirror 这三个组件组成的比对链是怎么闭环的,auto predict 和 explicit predict 怎么选?
- 内建序列库(bit-bash、reset、access)能签掉什么,特殊访问语义(W1C、RO 写影响、volatile 字段)为什么要自己补?
- 寄存器覆盖率怎么建模和采样,间接寄存器(indirect/indexed)为什么要在方法学上单独对待?
- 从建模到签核,各环节的标准串接顺序和常见缺口是什么?
一、以 RAL 模型为中心:一份模型喂饱所有环节
寄存器验证的第一个方法学决策是「单一事实源」。没有 RAL 的原始做法是:每个 testcase 里直接 write(32'h4000_0010, 32'h1),地址、掩码、字段含义散落在几百个测试里。规格书一改地址,全局搜索替换,漏一处就是一个潜伏的环境 bug——测试过了,但写的是错的寄存器。RAL 把这个局面翻过来:寄存器规格(地址映射、字段划分、访问属性、复位值)集中在一个 uvm_reg_block 模型里,测试只写字段名 ral.ctrl.enable.write(status, 1),地址、移位、掩码全部由模型在运行期生成,测试代码里一个魔法数字都不留。
模型的来源通常是自动生成的:从 IP-XACT、SystemRDL 或厂商自家 CSV 用工具(ralgen、PeakRDL 等)转出 UVM RAL 类。这里有一条硬纪律——RAL 模型绝不手写、绝不手改,改就改源规格再重新生成,否则模型和规格书的一致性本身就成了无人验证的盲区。寄存器 reg block 与 map 结构 讲了 block/map/reg/field 四层结构怎么组织,寄存器多 map 地址 覆盖了一个寄存器挂多个地址视图(比如不同总线口看到不同偏移)的建模法。
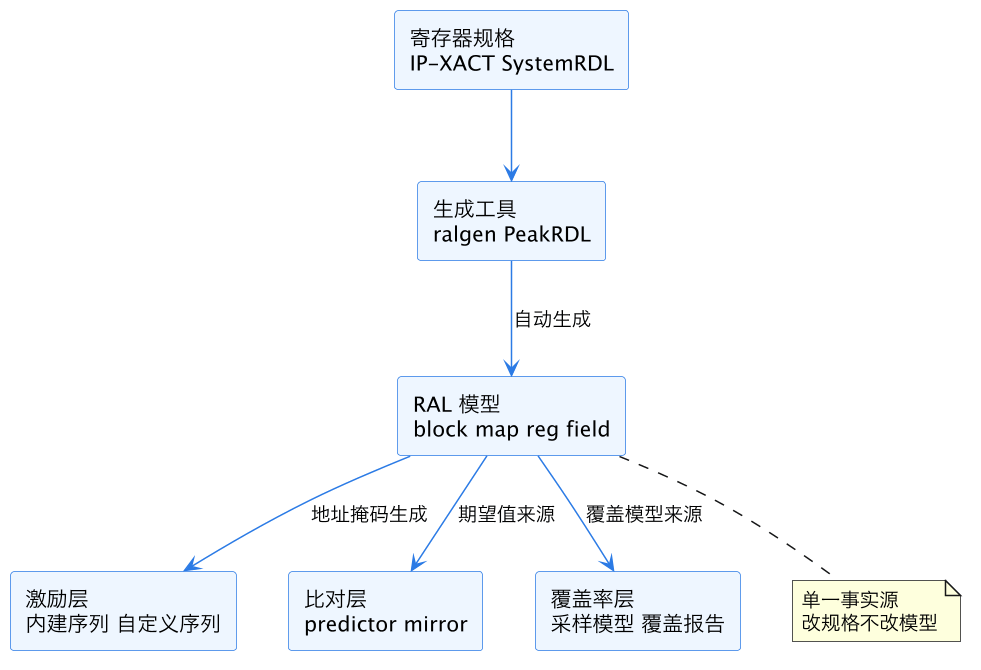
上图是全篇的骨架:RAL 模型位于版图中心,激励、比对、覆盖率三条线都从它取数据。这个结构的方法学含义是——模型质量就是验证质量的上限。访问属性标错(把 W1C 建成 RW)、复位值抄错、字段位宽切错,后面所有环节会忠实地把错误放大成「全绿」。所以 RAL 模型生成后要做的第一件事不是跑测试,而是对模型本身做一轮校验:用内建 reset 序列验证复位值、抽样对照规格书、跑一次模型到 RTL 的双向对拍。这一步在版图里常被跳过,是第一大缺口。
模型自校验还有一层更隐蔽的收益:它逼团队把规格书本身的问题提前暴露。真实项目里寄存器规格文档的错漏率惊人——字段位宽加起来对不上寄存器宽度、同一寄存器在两章里复位值不一致、访问属性写着 RW 但下文描述明明是 W1C 行为。这些问题在生成 RAL 时被工具原样继承,跑自校验序列时才会以「模型和 RTL 不一致」的形式冒出来。此时修规格的成本是一行文档,留到硅后软件按错的规格写驱动,代价就是一次客诉。把「RAL 生成即规格评审触发器」写进流程,是方法学上几乎零成本的一个动作。
二、frontdoor 与 backdoor:两条通道各验一半
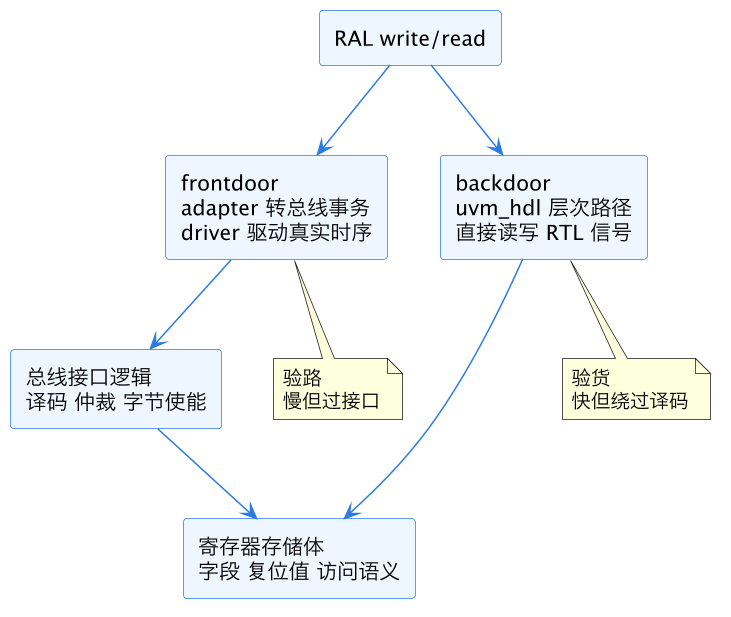
RAL 提供两条物理上完全不同的访问通道。frontdoor(前门)走真实总线:sequence 发起 reg.write(),经 adapter 转成总线 transaction,driver 驱动 AXI/AHB/APB 时序,穿过真实的地址译码、总线仲裁、寄存器接口逻辑到达 DUT。backdoor(后门)走 HDL 层次路径:uvm_hdl_force/deposit 或 DPI 直接戳进 RTL 内部信号,零拍数、零总线活动。
两条通道验证的东西互补得近乎正交。frontdoor 验的是「路」——地址译码对不对、总线接口时序合不合规、写掩码字节使能灵不灵;但它慢,几万个寄存器全跑前门,仿真时间按小时计。backdoor 验的是「货」——字段复位值、读写语义、写后读回一致性;它快,一个字段的检查一拍以内完成,但它完全绕过了接口逻辑,地址译码错了它一概看不见。只用前门,回归时间爆炸;只用后门,寄存器 backdoor HDL 路径 配的层次路径指错信号都能测「过」——路径错配是 backdoor 特有的环境假绿。
backdoor 还有第三个用途常被忽略:调试加速。功能测试失败时,用 backdoor 快照(peek)整片寄存器空间导出当前状态,和期望值 diff,能把「DUT 在哪个字段上偏了」的定位时间从翻波形的几小时压到几秒钟。很多团队把它当成正式手段写进 scoreboard——每个关键检查点做一次全量 backdoor 快照比对。这个用法不伤验证强度,因为前门比对链照常运转,backdoor 只承担观测职责。观测不干预(用 uvm_hdl_read 而非 deposit),就不会引入「后门写污染现场」的争议。
方法学上的标准打法是「互验交叉」:前门写、后门读回,和后门写、前门读回,两个方向各跑一遍。前门写后门读能同时验译码(写到了该去的地方)和存储(后门读到的是刚写的值);反过来能验读出路径。完整策略见 RAL frontdoor 与 backdoor。资源分配上有个经验比例:全量字段的穷举读写走 backdoor(分钟级),frontdoor 只挑代表性样本——每个 block 每种访问类型抽几个,再加地址边界的特意测试(首地址、末地址、跨边界、未映射地址的报错行为)。这样既保住接口逻辑的覆盖,又把回归时长压回可接受区间。
三、adapter 与 predictor:比对链的两个关节
RAL 模型是协议无关的,reg.write() 产出的 uvm_reg_item 必须翻译成具体总线的事务才能上 driver——这个翻译官就是 adapter(继承 uvm_reg_adapter,实现 reg2bus/bus2reg)。adapter 是 frontdoor 链路上唯一的协议感知组件,它的 bug 极具隐蔽性:比如 reg2bus 里地址对齐处理错(寄存器地址是字节地址而总线是字地址,少除个 4),测试全挂还好,最怕的是它和 driver 错成一对「配套错误」,两边一起错反而全绿——你以为验的是 DUT,其实验的是自己环境内部自洽的幻觉。adapter 的单元级自测(不挂 DUT,直接对 adapter 做 reg→bus→reg 往返)应该成为环境 bring-up 的固定动作。
比对侧的关键组件是 predictor(uvm_reg_predictor):它订阅总线 monitor 的 analysis port,看到总线上真实发生了一次写,就用 adapter 反解出寄存器地址,据此更新 RAL 模型里的镜像值(mirrored value)。这样 scoreboard 不用自己追踪总线活动,直接比对「DUT 行为应该让镜像变成什么样」和「模型镜像现在是什么样」。镜像机制的两个语义值——desired(想写的值)和 mirrored(认为硬件现在的值)——在 desired 与 mirror 语义 里有细拆,mirror() 任务带 check 选项时正是靠 mirrored 值做读回比对。
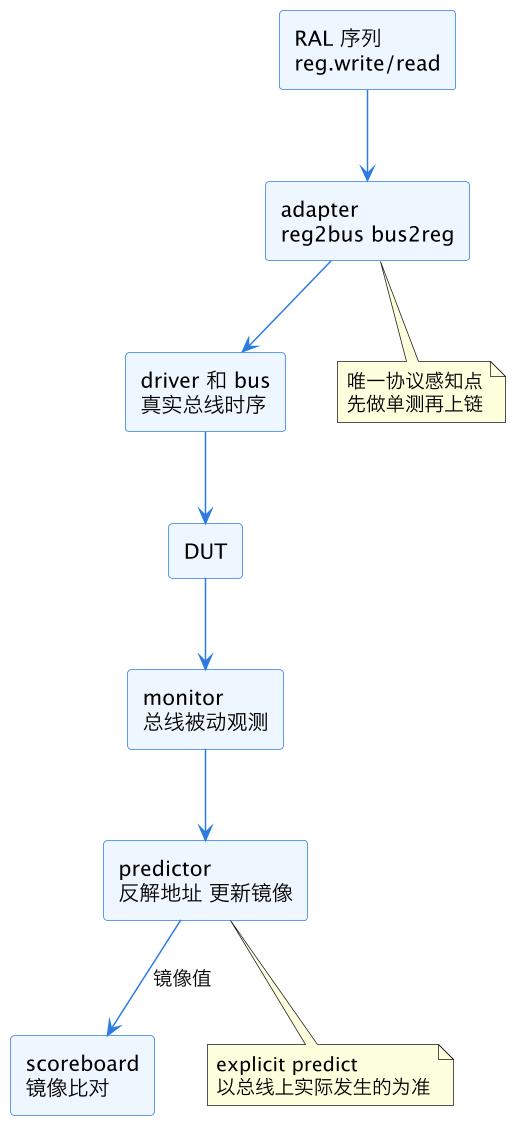
上图就是比对链的全环:写从左上出去,观测从 monitor 回来经 predictor 更新镜像,scoreboard 在环外拿镜像做裁判。环上任何一个组件静默失效,整条链就退化成「写了就当对」——predictor 的 analysis port 忘连、adapter 的 bus2reg 返回空句柄、monitor 采样相位错一拍,表象全是「比对链从不报错」,而不是显式失败。所以环境 bring-up 时要反向验证比对链自己会叫:故意让 DUT 行为和期望不一致(比如临时改一个复位值),确认镜像失配能如期报出来,再改回去。这个「裁判先验哨子」的动作和 adapter 单测一样,属于一次投入终身受益。这里有一个方法学分叉——预测用 auto 还是 explicit。auto predict 是「sequence 说写了就当写成了」,模型在发起访问时直接更新镜像,不等总线确认;explicit predict 是「monitor 看到才算数」。前者省一个 predictor 但会把没真正完成的访问(被仲裁丢弃、出错响应)也算成成功,后者以事实为准。auto predict 与 explicit predict 的结论可以一句话带走:有 monitor 的环境一律 explicit,auto 只配在没 monitor 的临时环境里过渡。接线的完整细节在 reg adapter 与 predictor 接线,那是这条链落地时的必读单篇。
四、激励体系:内建序列打底,特殊语义自己补
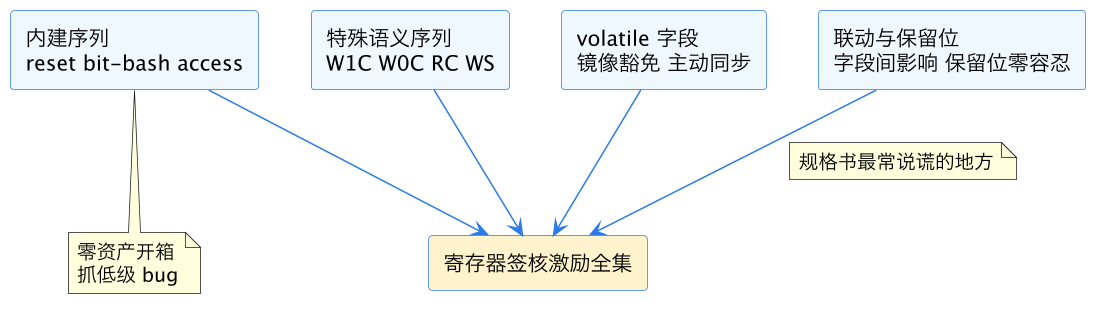
激励分三层。最底层是 UVM 内建序列库:uvm_reg_hw_reset_seq(验复位值)、uvm_reg_bit_bash_seq(逐字段写 0/1 翻转验单比特可控)、uvm_reg_access_seq(验访问属性和读写路径)、uvm_mem_walk_seq(存储走步)。这批序列的价值在「零资产开箱」——RAL 模型建好就能跑,第一天就能抓复位值抄错、字段黏连(写 bit3 bit5 跟着动)、地址错位这类高发低级 bug。内建寄存器序列库 有逐序列的行为清单,bit-bash 的算法和局限在 寄存器 bit-bash 序列。
内建序列签不掉的是特殊访问语义。工业界寄存器远不是 RW/RO 两种那么简单:W1C(写 1 清零)的中断状态、W0C、WS(写 1 置位)、RC(读清零)、WO(只写读回非法)、带 hardware-set 而 software-clear 的状态位、写 A 字段会影响 B 字段的联动位。这些语义内建序列一概不知道——bit-bash 往 W1C 字段写 1 期待读回 1,硬件却把它清了,直接误报。正确做法是让 RAL 模型的访问属性标对(工具从规格生成时就要保证),然后为每类特殊语义写专门序列:W1C 就写 1 再读期望清、写 0 再读期望保持;RC 就读两次确认第二次读到清后值。寄存器 volatile 字段访问 处理了更棘手的一类——硬件自己会动的字段(计数器、状态位),镜像比对对它们必须豁免或用 predict 主动同步,否则环境噪声会淹没真 bug。寄存器读写属性 是属性语义的总表。
第三层是功能场景激励:寄存器 rarely 孤立地被验,更多时候它嵌在功能测试里——配置 DMA 描述符寄存器再启动传输,配时钟分频再测输出频率。这一层由功能 sequence 顺带完成,RAL 提供的作用是「配置即字段名」,功能测试不再关心地址。方法学上这一层的回报是隐性的:当地址表改版时,功能测试零改动,只有 RAL 重新生成——这就是第一节「单一事实源」投资在项目上兑现利息的地方。
还有一类激励值得点名:错误注入。寄存器接口是错误响应(AXI 的 SLVERR、APB 的 PSLVERR)的产生地——访问未映射地址、对只读寄存器写、访问掉电域的寄存器,硬件应该报错而不是挂死或静默吞掉。这类负向序列内建库里没有,要按总线协议定向构造;它和 UVM 错误注入策略 讲的方法一脉相承,只是注入点固定在地址译码层。负向寄存器测试的覆盖目标可以量化:未映射区间的抽样地址数、每种违规类型的至少一次命中,把这些写进覆盖模型,负向验证才不是随手跑过就算。
五、覆盖率与间接寄存器:闭环的最后两块拼图
激励跑完不等于验完,要知道「验到哪了」需要寄存器级覆盖率。RAL 内建了 covergroup 支持(uvm_reg 可按字段自动生成覆盖点:值域分桶、读写事件、字段间 cross),但采样不是自动发生的——必须在正确时机调 sample_values() 或在 predictor 更新镜像的钩子里触发采样,否则覆盖模型建好却永远是空的。寄存器覆盖率采样 专门讲采样时机这个坑;采样基础设施本身和 covergroup 采样时机 的通用结论一致——采样点错一拍,覆盖数据和激励就永远对不上。
覆盖模型设计的取舍是:全字段全值域会爆炸(一个 32 位字段不可能全值覆盖,真建出来回归跑到天荒地老也收敛不了,纯粹制造噪声),务实的模型按访问属性定制——RW 字段覆盖 0/1/翻转和边界值,配置枚举字段覆盖全部合法枚举加非法值注入,保留位覆盖「写任意值读回恒定」这一条即可。寄存器覆盖率最终要和功能覆盖率并表进签核,汇流机制见 覆盖率合并与排除流程。
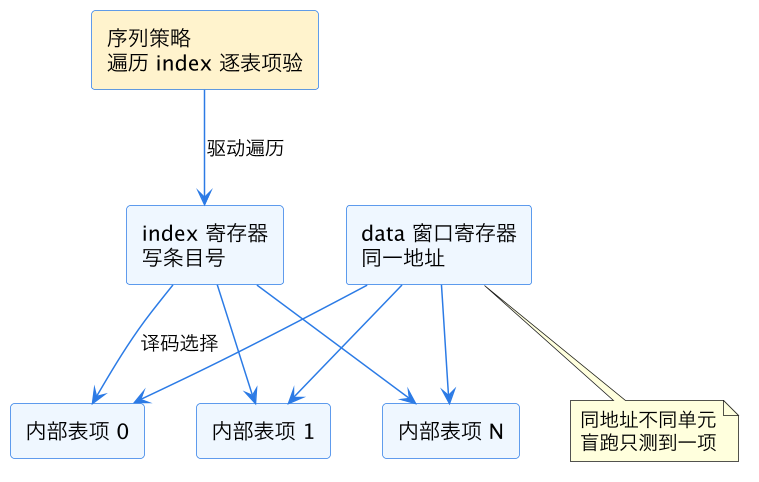
间接寄存器(indirect register)是版图里必须单独对待的一块:大量硬件用「索引寄存器 + 数据窗口」的方式暴露内部表项(PHY 配置、统计计数器表、微码 RAM 窗口)——先往 index 寄存器写条目号,再读写 data 寄存器,实际访问的是 index 选中的那项。这对 RAL 的平地地址模型是个维度打击:同一个 data 地址背后是上万个不同存储单元,bit-bash 直接跑只会戳到 index 当前指向的那一项。寄存器间接索引访问 给了标准解法——用 uvm_reg_indirect_data 或在自定义序列里显式遍历 index,把「index 译码错误」(写条目 3 实际写到条目 5)这类该结构特有的高危 bug 纳入覆盖。
六、串接顺序与缺口清单:方法学的落地节奏
七大板块摆齐,最后回答按什么顺序串、哪里最常缺角。标准节奏六步走,每步的出门判据也一并给出。
| 步骤 | 动作 | 出门判据 |
|---|---|---|
| 1. 建模 | 从规格自动生成 RAL,禁手改 | reset 序列全绿,抽样对照规格无差 |
| 2. 链路 | adapter 单测,predictor 接线,双通道打通 | 前后门交叉互验通过 |
| 3. 内建 | 跑 reset、bit-bash、access 序列 | 全绿且误报清零(访问属性标对) |
| 4. 语义 | 补特殊访问、volatile、联动位序列 | 每类语义至少一条定向序列 |
| 5. 覆盖 | 建覆盖模型、挂采样、补间接寄存器遍历 | 寄存器覆盖率进签核表且真实非空 |
| 6. 回归 | 并入 nightly,镜像比对进 scoreboard | 回归稳定零镜像失配 |
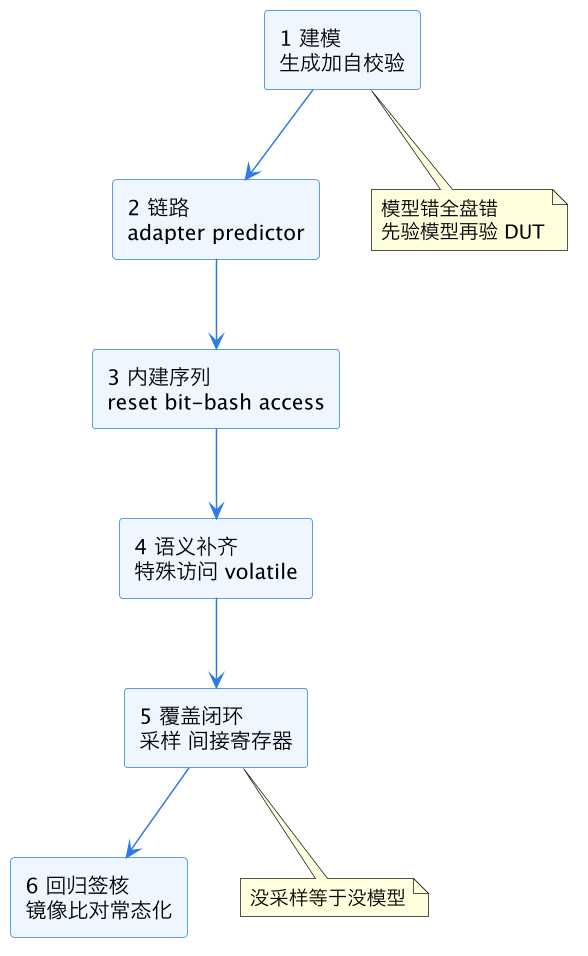
节奏上还有两个执行细节值得钉死。一是第 2 步和第 3 步不要并行:链路没验通就跑内建序列,失败时分不清是链路 bug 还是 DUT bug,triage 成本翻倍——先把前门写一个已知复位值字段再前后门读回这种最小冒烟做绿,再放量。二是镜像比对从第 2 步就该常驻 scoreboard,不要等第 6 步才接入:越早接入,镜像失配报得越频繁,越能尽早暴露模型语义错(很多 W1C 属性错就是 scoreboard 早期镜像失配顺藤摸出来的,而不是定向序列抓的)。方法学里这叫「比对先行,激励随后」,次序反了,等于先用错误的期望值签了一批假绿。
按事故频率排的缺口清单有四条。第一缺模型自校验:跳过第 1 步直接跑 bit-bash,把模型的访问属性错当 DUT bug 查三天。第二缺 explicit predict:图省事用 auto predict,总线错误响应下镜像照样更新,从此镜像比对形同虚设。第三缺特殊语义:只跑内建序列,W1C 写 0 是否保持、RC 读两次的行为从未被验过,而这些恰是软件依赖最重的语义。第四缺采样:覆盖率模型建了,回归报告里寄存器覆盖率常年 0%,无人察觉——因为没有任何流程检查它非空。四个缺口都不需要高深技术去补,只需要在方法学 checklist 里各占一行,逐条签字。寄存器验证这种「量大、模式固定、错的代价极高」的领域,胜负从来不在单点技巧,而在版图完整。把上面六步判据和四条缺口合成一页 checklist 挂在验证计划首页,每个项目 kickoff 时逐条过一遍——哪一步被裁掉了、裁掉的理由是什么、剩余风险谁签字——寄存器验证就从「看运气」变成「按图施工」。
这一篇在知识体系里的位置
本篇是 chip-design/verification 目录下寄存器验证线的枢纽深文,把已有的 RAL 长尾串成完整体系。建模层见 寄存器 reg block 与 map 结构 与 寄存器多 map 地址;通道层见 RAL frontdoor 与 backdoor 与 寄存器 backdoor HDL 路径;比对层见 reg adapter 与 predictor 接线、auto predict 与 explicit predict、desired 与 mirror 语义;激励层见 内建寄存器序列库、寄存器 bit-bash 序列、寄存器 volatile 字段访问 与 寄存器读写属性;覆盖与特殊结构见 寄存器覆盖率采样 与 寄存器间接索引访问。模型与环境集成落地见 UVM 寄存器模型集成,回调扩展见 寄存器回调 pre/post。横向,寄存器验证寄生于 UVM 环境骨架(UVM 组件与 phase、sequence driver scoreboard),其覆盖率最终汇入 覆盖率合并与排除流程 统一签核。
总结
UVM 寄存器验证方法学的核心是以 RAL 模型为单一事实源,串起一条完整闭环:模型从规格自动生成并先自校验,frontdoor 验接口、backdoor 验语义且两向交叉互验,adapter 单测后接上 explicit predictor 维持镜像比对,内建序列(reset/bit-bash/access)打底抓低级 bug,特殊访问语义、volatile 字段、联动位与间接寄存器必须定向补齐,最后寄存器覆盖率真实采样并进签核表——这条链上最常见的四个缺口(模型不自校验、auto predict 偷懒、特殊语义不补、采样空挂)全是版图缺角而非技术难题,逐条签字即可避开。