层次化 STA 上下文生成:block 级签核所需的顶层上下文提取、封装与接口违例归因
更新时间:2026-10-06。大设计没人敢做全扁平化 STA——几亿门的网表跑一次签核机时以天计、内存以百 GB 计。工程上的出路是层次化:block 各自签核,顶层只跑接口与集成就绪检查。但 block 级签核有个致命前提——它分析时用的「外部环境」必须真实代表顶层集成后的环境,否则 block 内部干干净净、集成之后接口全线翻红。这个外部环境就是本篇的主角:上下文(context)。层次化流程的模型选择总览见 层次化流程之 ILM 与 ETM,block 接口时序的约束写法见 层次化 STA 之 block 接口。本篇讲流程:上下文有哪三类、各自怎么从顶层提取封装、ETM 模型的精度损失在哪、接口违例出现时怎么归因。
本文要回答的问题
- block 级 STA 需要顶层提供哪三类上下文,各自管什么?
- IO 时序预算、寄生接口模型、timing window 的提取和封装各有什么坑?
- ETM(提取时序模型)相对真实网表损失了什么精度,怎么控制?
- 接口违例出现时,怎么判断是 block 内部问题、上下文过期问题还是顶层集成问题?
一、三类上下文:block 需要知道的外部世界
先把「block 看见的世界」画出来。block 内部的时序它能自己算准——它有自己的网表、寄生、库。它算不准的是边界上的一切:输入端口的数据什么时候到、驱动能力多大;输出端口的负载多重、外部留给它多少时间;穿顶层走过的时钟延迟与偏移是多少。这些信息全部要由顶层以下下文形式喂给 block,分三类。
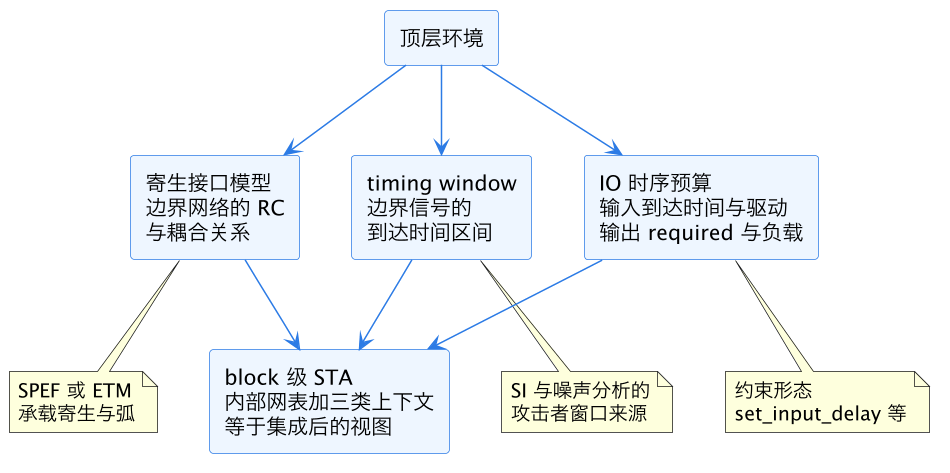
三类上下文各管一摊,缺任何一类都会以特定形态翻车。IO 时序预算管「时间账」:输入路径在 block 外消耗多少时间、输出路径给 block 内留多少时间,预算的制定方法见 IO 时序预算约束。缺了它,block 的接口路径时序等于无的放矢。寄生接口模型管「电气账」:边界网络的 RC 寄生与耦合电容,block 内部驱动 cell 要推着顶层的走线负载跑,负载不对延迟全错。timing window 管「串扰账」:顶层邻居网络的翻转窗口,block 级 SI 分析的攻击者窗口来源(窗口分析的机理见 SI 串扰增量延迟)。三类上下文还必须来自同一份顶层数据快照——预算是 v3 版 floorplan 定的、寄生是 v5 版布线提的,这种混搭上下文比没有上下文更危险,因为报告的违例根本无法复现和归因。
二、IO 时序预算:先分账,再对账
IO 时序预算的本质是顶层与 block 之间的一纸时间合同:一条从 block A 出发经顶层走线到 block B 的路径,周期时间三方分账——A 内部一段、顶层走线一段、B 内部一段。预算制定在 floorplan 阶段完成,按接口的物理距离和走线通道估算顶层段开销,剩下的按约定比例切给两端 block。
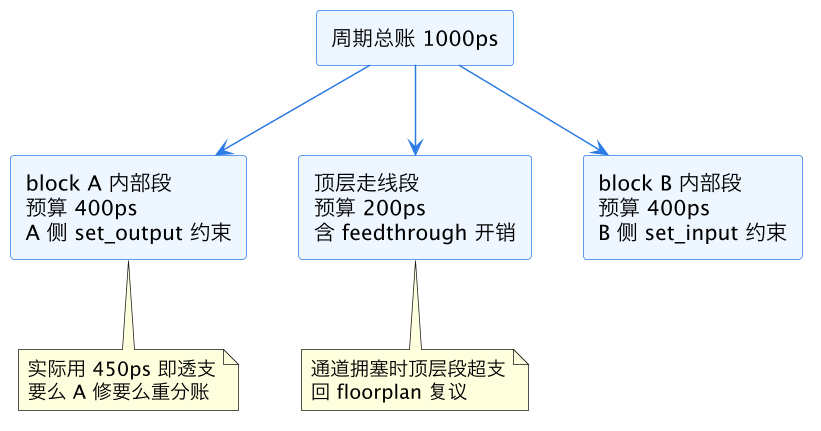
预算执行期的核心动作是对账:每轮 block STA 之后,把接口路径的「实际消耗」与「预算份额」对比。实际小于预算是存款,可以支援紧张的对端;实际大于预算是透支,触发三方会商——本端修(时序 ECO)、对端让(重分账)、顶层补(改走线通道或加 feedthrough,见 feedthrough buffer 插入)三选一。对账的纪律有两条:一,预算版本化,每次重分账全员同步生效,禁止单边改预算——A 偷偷放宽自己的 output 预算,等于把 B 的 input 预算无声压缩,这类事故在多人多团队项目里每个项目都会发生至少一次,只能靠预算文件的单一数据源加变更评审根治;二,hold 预算单独记,setup 分账宽松不代表 hold 安全,hold 的接口违例往往在集成 STA 才暴露,因为它的窗口比 setup 小得多。接口的物理形态(通道式还是对接式 floorplan)直接影响顶层段开销的估算方式,见 通道式与对接式层次 floorplan。
三、寄生接口模型与 ETM:精度损失在哪
block 签核时,顶层环境不可能拿全网表陪着跑,要用模型代替。两种模型路线:ILM(Interface Logic Model,接口逻辑模型)保留接口锥区的真实网表与寄生,精度高但体积大;ETM(Extracted Timing Model,提取时序模型)把 block 整个压成「端口到端口的时序弧加边界寄生」的黑盒模型,体积小一个量级以上,是顶层集成 STA 的主流选择。两条路线的取舍细节在 层次化流程之 ILM 与 ETM,本篇聚焦 ETM 的精度损失。
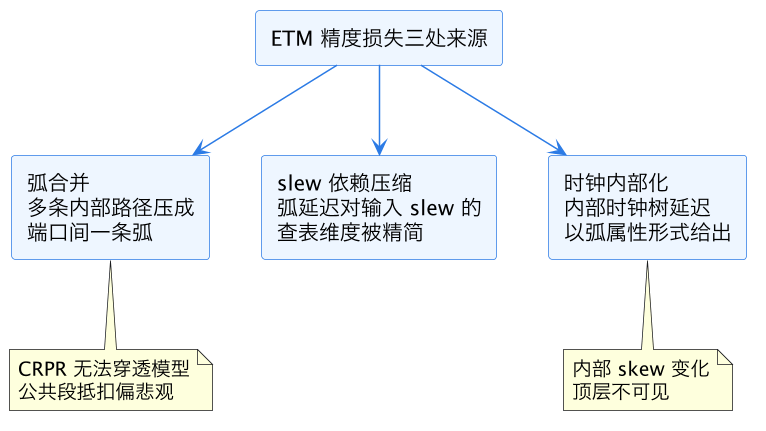
三处损失各有对策。弧合并的损失是「一条弧代表多条路径的最差值」——相对 GBA 还多一层悲观,对策是关键接口路径保留明细弧(现代 ETM 流程支持对指定路径保留 path-specific 弧),或者在评审时接受这层悲观作为接口裕量的一部分。slew 依赖压缩的代价是模型对输入 slew 变化的响应变钝,对策是 ETM 提取时的 slew 格点覆盖 block 实际工作的 slew 范围,范围外的外推值不可信。时钟内部化最微妙:ETM 把内部时钟树延迟折算成弧的属性后,顶层做 CRPR 时无法穿透模型抵扣内部公共段,接口路径的悲观度天然比扁平化分析高一截——这是层次化流程的结构性成本,预算制定时就要给它留座位,而不是签核时才发现接口系统性偏紧。
寄生接口模型的另一条纪律是「与谁对齐」:block 用的边界寄生必须来自顶层布线的同一版数据,顶层重布线之后所有相邻 block 的上下文全部过期——这就是层次化流程里著名的「上下文雪崩」,一次顶层改动触发一圈 block 重签。控制手段是上下文版本戳:每份上下文文件带数据版本号,block STA 报告里记录所用版本,对账时先对版本再对时序。黑盒阶段的简化形态(还没有真实网表时用 stub 约束)见 blackbox 与 stub 时序流程。
四、timing window 上下文:SI 分析的外部攻击者
第三类上下文最容易被漏掉。block 级 SI 分析需要知道边界网络的外部攻击者什么时候翻转——这些攻击者在顶层、在相邻 block 里,block 自己看不见。timing window 上下文就是顶层把「每个边界端口附近的外部网络翻转窗口」提取出来交给 block。漏掉它的后果很具体:block 内部 SI 签核干净,集成后边界长线被顶层总线咬出一片 setup 或 hold 违例,且这类违例在 block 级完全无法复现,排查时极易误判成「集成数据错了」。
提取 timing window 的坑在两个方向。一是模式对齐:窗口是按工作模式算的,顶层给 block 的窗口必须覆盖 block 要签核的全部模式,模式集合不一致时窗口缺失(多模式的 SI 窗口合并见 时序窗口之 SI 噪声合并)。二是迭代收敛:block 的输出翻转窗口本身是它自己内部时序的产物,而顶层邻居的窗口又依赖 block 的输出——循环依赖。这个循环依赖还藏着一个调度含义:集成 STA 与 block 签核不是严格先后关系,而是要多轮收敛,项目计划里至少要给这个循环留两轮迭代的窗口,只排一轮的计划第一次集成就崩。工程解法是按「初值加迭代」处理:第一轮用约束估算的窗口,集成 STA 后用实测窗口回灌,差异超阈值时相关 block 重签一轮。
五、接口违例归因:三选一怎么判
接口违例出现了,归因有标准流程:先对版本,再对预算,最后对结构。
| 归因类别 | 判据 | 责任方 | 处置 |
|---|---|---|---|
| block 内部超支 | 版本一致且内部段超预算 | block 负责人 | block 内 ECO 修复 |
| 上下文过期 | 报告版本戳落后于顶层数据 | 流程管理 | 重生成上下文重签 |
| 预算本身不合理 | 双侧都紧且顶层段超估 | 顶层规划 | 三方会商重分账 |
| 顶层集成问题 | feedthrough 或通道走线超支 | 顶层负责人 | 改通道或加缓冲 |
归因流程的第一条铁律是「先对版本再对时序」——上下文版本戳不一致时,一切时序讨论都是浪费时间。第二条是「双侧报告一起看」:接口路径的 A 侧报告和 B 侧报告同时摆上桌,单边收紧双边看,能直接区分「内部超支」与「预算不合理」。第三条是「结构性问题不上修表」:判为预算不合理或顶层通道问题的,禁止在 block 内硬修——硬修出来的接口时序会把功耗和 hold 拖垮,出路在 层次化 ECO 之 block top 同步 的协调机制里重分账或改通道。
| 上下文类型 | 提取来源 | 过期触发 | 封装格式 |
|---|---|---|---|
| IO 时序预算 | floorplan 加接口协议 | 重分账或通道改动 | SDC 约束段 |
| 寄生接口模型 | 顶层布线提取 | 顶层重布线 | SPEF 或 ETM |
| timing window | 顶层集成 STA | 相邻 block 时序变化 | 窗口表 |
六、上下文生成的流水线化:谁来产、什么时候产
最后把组织形态钉一下。上下文生成不是「block 要的时候顶层临时导一份」的手工活,它必须是流水线化的定时产物,否则项目后期每天都在追版本。
推荐的流水线形态是三级触发。定时触发:每夜顶层数据库固化后自动跑上下文提取——预算段从约束库导出、ETM 从各 block 最新网表提取、寄生接口从顶层布线重提、timing window 从最新集成 STA 结果回灌——产出带统一版本戳的上下文包,推送到各 block 的签核环境。事件触发:顶层重布线、接口重分账、相邻 block 的 ECO 落库这三类事件直接触发相关方向的上下文重生成,不等夜间窗口。请求触发:block 在重大修复后申请刷新自己的上下文,由顶层评审放行——防止单个 block 的高频请求把整个流水线的算力拖垮。
流水线还有两个工程细节值得明说。其一,上下文包要做差量分发:每次只推变化的部分(哪个 block 的哪类上下文变了),全量重推既慢又让 block 无法快速判断「这次我该不该重签」;差量说明文件里要附变化原因(哪次顶层改动触发),归因时这份说明是第一手线索。其二,接口的引脚分配本身也是上下文的上游——引脚位置决定顶层走线长度,引脚调整会连锁改变预算与寄生,引脚规划方法见 层次化引脚分配规划;项目中期以后引脚必须冻结,否则上下文流水线永远追不上变化。
上下文流水线的成熟度,其实就是一个团队层次化方法学的成熟度:上下文能按夜自动产出、版本戳能对上、归因流程有人走,层次化的红利(并行签核、机时可控)才拿得到;反之,层次化就退化成「每个 block 各自干净、集成时集体翻修」的灾难形态。
这一篇在知识体系里的位置
本篇是层次化设计专题的流程篇:模型路线选择在 层次化流程之 ILM 与 ETM,接口约束写法在 层次化 STA 之 block 接口,预算制定在 IO 时序预算约束,黑盒期简化在 blackbox 与 stub 时序流程;横向关联 层次化 ECO 之 block top 同步(归因后的修复通道)、通道式与对接式层次 floorplan(顶层段开销的物理形态)、SI 串扰增量延迟(timing window 的消费方);上游挂 数据流 S5 之签核收敛 与 时序收敛迭代方法学。
总结
层次化 STA 上下文生成的本质是把「顶层真实环境」压成 block 能消费的三类合同:IO 时序预算管时间账(分账、对账、版本化),寄生接口模型管电气账(ETM 的弧合并、slew 压缩、时钟内部化三处精度损失要预算预留),timing window 管串扰账(外部攻击者窗口按模式对齐、初值加迭代收敛);三类上下文必须同源快照、带版本戳交付,接口违例归因走「先对版本、再对预算、最后对结构」的流程——上下文管理做到位,block 级签核的「干净」才真正等于集成后的「干净」。