UVM analysis port 多订阅:一个端口扇出给多个 subscriber 的正确姿势
更新时间:2026-09-29。UVM monitor 与 analysis imp:观测数据怎么送出组件 讲了 monitor 到 scoreboard 的一对一连法,SV TLM port/export/imp:三级端口各自的角色 讲了 TLM 端口的角色分层。真实环境里几乎不存在「只发一家」的 monitor——同一份事务往往要同时喂给 scoreboard、覆盖率和断言检查器。这一篇只回答一个问题:一个 analysis_port 怎么安全地扇出给多个订阅者。
本文要回答的问题
- analysis_port 一对多连接和普通 port/export 连接的本质区别是什么?
- 一个组件想订阅两种事务流(或同一事务的两种处理),多 imp 怎么声明才不撞名?
- 多个 subscriber 的
write调用顺序有保证吗?能不能依赖它做先后顺序假设? - 端口没连任何 subscriber 会报错吗?广播的「零连接」语义是什么?
一、为什么 analysis_port 天生支持一对多
先回顾 TLM 三级端口的连接纪律:普通 uvm_blocking_put_port 必须连到一个 export,export 最终必须落到一个 imp——一条链一个消费者,连接少了 elaboration 阶段就报错。这是「点对点管道」的语义:生产者推一个数据,有且只有一个接收方处理它。
analysis_port 的语义完全不同,它是广播(broadcast):ap.write(tr) 这行代码执行时,UVM 内部遍历所有注册到这个端口的 imp,依次调用每个 imp 所在组件的 write(tr)。连接数可以是 0、1、N,都合法。这正好匹配观测数据的消费特征:
- scoreboard 拿事务做结果比对;
- coverage collector 拿同一份事务做功能覆盖采样;
- 协议 checker 拿同一份事务做在线断言或日志落盘。
三家用的是同一份只读数据,互不干扰,谁多谁少都不影响 monitor 本体。所以 analysis_port 不检查连接数——零连接不是错误,只意味着这条观测流暂时没人听。
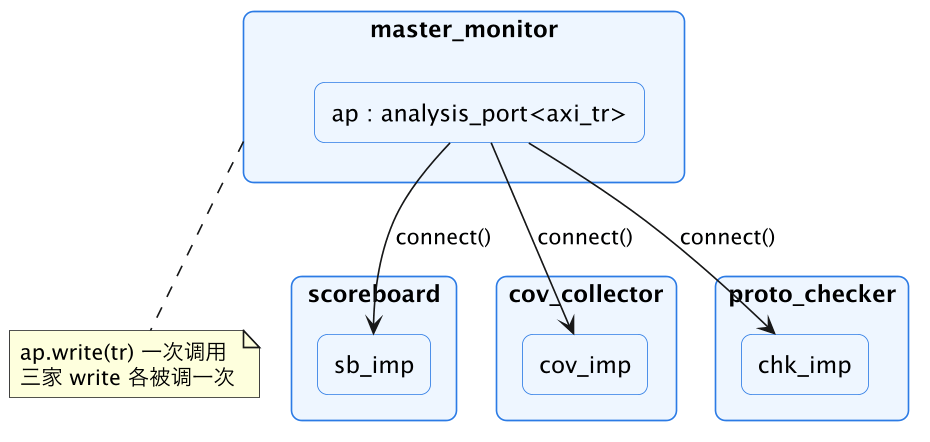
这张图是整个多订阅机制的核心:monitor 侧只有一个 ap,三条 connect() 把它扇出到三个组件各自的 imp。ap.write(tr) 在 monitor 的 run 阶段每执行一次,UVM 就把 tr 广播给 sb、cov、chk 三家的 write 各调一遍。monitor 完全不知道、也不需要知道下游有几家——新增一个订阅者只是在 env 的 connect_phase 里多写一行,monitor 代码零改动。这就是观测面与被测设计解耦的价值。
二、connect 的写法与零连接语义
扇出连接的代码平淡无奇,全部写在 env 的 connect_phase:
function void env::connect_phase(uvm_phase phase);
  // 同一个端口连三次,扇出到三个 subscriber
  mon.ap.connect(sb.sb_imp);
  mon.ap.connect(cov.cov_imp);
  mon.ap.connect(chk.chk_imp);
endfunction
每条 connect 的参数方向固定是「port 调 connect,imp 当实参」,连三家就是三行,没有谁先谁后的讲究。订阅者侧每家都按常规套路声明 imp 并实现 write:
class scoreboard extends uvm_component;
  `uvm_component_utils(scoreboard)
  uvm_analysis_imp #(axi_tr, scoreboard) sb_imp;

  function void build_phase(uvm_phase phase);
    sb_imp = new("sb_imp", this);
  endfunction

  function void write(axi_tr tr);
    // 比对逻辑
  endfunction
endclass这里有一个常被追问的点:零连接真的不会报错吗? 答案是肯定的。uvm_analysis_port 在 elaboration 检查(check_phase 的端口连接检查)里被明确豁免——它内部维护的是一个 imp 列表,列表为空时 write 就是个空循环,一拍就返回。这个特性在工程上很有用:你可以在覆盖率开关关闭时把 cov_collector 整个不例化,monitor 侧代码一行不用动;回归配置裁剪观测组件时也不会触发连接错误。反过来,普通 blocking port 漏连会在 check_phase 直接报 UVM_ERROR,两种端口的检查强度差异正是「管道」与「广播」语义差异的体现。
| 维度 | blocking put port | analysis_port |
|---|---|---|
| 连接语义 | 点对点管道 | 一对多广播 |
| 允许连接数 | 恰好 1 条链 | 0 / 1 / N 均合法 |
| 零连接后果 | check_phase 报错 | 静默合法,write 为空循环 |
| 消费者处理 | 唯一接收方 | 每家 subscriber 各收一份 |
| 数据流向假设 | 消费者可能反压 | 只读观测,无反压 |
三、多 imp 声明:一个组件订阅多路流
扇出的镜像问题是汇聚:一个组件想订阅两种不同的事务流怎么办?比如 scoreboard 既要看请求事务(req)做延迟统计,又要看响应事务(rsp)做数据比对。如果两条流事务类型不同,声明两个不同参数的 imp 即可,没有障碍。真正的坑在两条流类型相同的场景:两个 monitor 都广播 axi_tr,scoreboard 想分别统计主端口和从端口的流量。裸写两个 uvm_analysis_imp #(axi_tr, scoreboard) 会要求 scoreboard 提供两个同名 write 函数——编译直接冲突。
UVM 的解法是 uvm_analysis_imp_decl 宏:为每路流声明一个带后缀的 imp 类型,对应的处理函数名也变成 write_后缀:
`uvm_analysis_imp_decl(_master)
`uvm_analysis_imp_decl(_slave)

class dual_scoreboard extends uvm_component;
  `uvm_component_utils(dual_scoreboard)

  uvm_analysis_imp_master #(axi_tr, dual_scoreboard) m_imp;
  uvm_analysis_imp_slave  #(axi_tr, dual_scoreboard) s_imp;

  function void build_phase(uvm_phase phase);
    m_imp = new("m_imp", this);
    s_imp = new("s_imp", this);
  endfunction

  function void write_master(axi_tr tr);  // 主端口流量
    m_cnt++;
  endfunction

  function void write_slave(axi_tr tr);   // 从端口流量
    s_cnt++;
  endfunction
endclass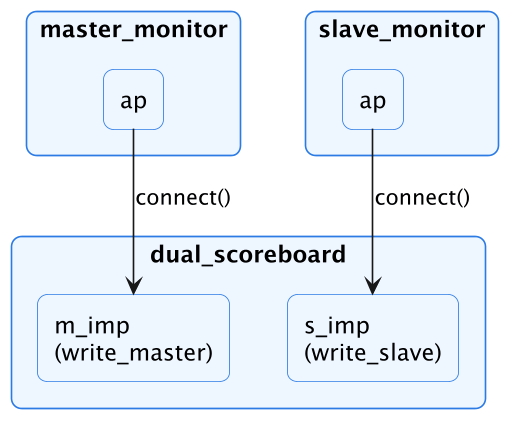
注意这张图和前一张的拓扑对偶:前面是一个 port 扇出给多家,这里是两个 port 各自汇聚进同一个组件的不同 imp。宏 _master / _slave 后缀把两条同类型流在函数名层面区分开,连接时 mmon.ap.connect(dsb.m_imp)、smon.ap.connect(dsb.s_imp) 各走各的通道。工程纪律是后缀起名要带语义(_master/_slave、_req/_rsp),别用 _1/_2 这种三个月后没人看得懂的编号。另外宏必须写在类外(包作用域或编译单元顶层),写在类里会展开出非法语法。
四、write 调用顺序:可以依赖吗
回到 ap.write(tr) 的广播内部:UVM 按 imp 注册(即 connect)的顺序遍历列表,逐个调用各 subscriber 的 write。于是有人写出这样的「聪明」代码:让 cov_collector 先 connect,scoreboard 后 connect,然后在 scoreboard 的 write 里直接读覆盖率组件更新后的统计值。这是脆弱设计,不要依赖它。
原因有三层。第一,调用顺序虽然在当前主流实现里等于 connect 顺序,但 UVM 标准并未把「遍历顺序」列为可依赖语义,换实现版本或仿真器没有合同保障。第二,connect 调用散落在 env 各层,后续维护者加一行 connect、调整一下顺序,隐含的先后假设就静默破裂,且不会报任何错——这类回归事故极难定位。第三,所有 subscriber 的 write 是在同一个仿真时间步内同步调用的(analysis 通信零延迟、无调度让步),它们之间本质上是并发的观测者,正确的心智模型就是「同时收到」,任何串行假设都违背这个模型。
还有一个和顺序相关的细节值得记牢:广播过程中所有 subscriber 拿到的是同一个事务句柄,不是各自的拷贝。如果某家 subscriber 在 write 里就地修改了 tr 的字段,排它后面的订阅者看到的就是被改过的脏数据——这正是「顺序不可依赖」假设破裂后最隐蔽的事故形态。工程纪律是 subscriber 一律把事务当只读,确需修改先 clone()。UVM 不替你防这一手,因为深拷贝每一条广播事务对高频 monitor 是不可接受的开销,标准把这个权衡留给了验证工程师。
正确的跨 subscriber 协作方式只有两条路:要么在 env 层显式协调(比如 scoreboard 需要覆盖数据时,通过句柄主动查询而非依赖调用先后),要么干脆合并成一个 subscriber 内部顺序处理。顺带提醒广播的性能特征:write 是函数调用不是任务,N 个订阅者就是 N 次函数调用,零时间开销;但如果某家 subscriber 在 write 里做了深拷贝或大对象操作,这份开销会乘在每一条广播事务上,高频 monitor 下值得给 subscriber 的 write 做一次性能体检。
这一篇在知识体系里的位置
- 上游基础:SV TLM port/export/imp:三级端口各自的角色 定义了 port/export/imp 的连接纪律,本篇的 analysis_port 广播是其中的特例分支。
- 直连场景:UVM monitor 与 analysis imp:观测数据怎么送出组件 讲一对一连法与
write实现套路,本篇在其上扩展一对多扇出。 - 下游应用:多订阅是 scoreboard、覆盖率收集器、协议 checker 并存的标准接线方式,覆盖率侧的消费细节见覆盖率模型相关篇章。
总结
UVM analysis port 多订阅利用的是 analysis_port 的广播语义:一个端口 connect 多次即扇出给多个 subscriber,write 一次各家各收一份,零连接也合法不报错;同一组件订阅多路同类型流时用 uvm_analysis_imp_decl(_后缀) 宏区分 imp 类型与 write_后缀 函数名;所有 subscriber 的 write 在同一时间步内并发调用,绝不可依赖 connect 顺序做先后假设——跨订阅者协作只能在 env 层显式协调。