latch 借时:电平敏感设计的时序弹性与 STA 计算口径
前面一系列文章都在讲 flip-flop(触发器)世界里的规则:GBA 与 PBA 分析模式里的 setup/hold 检查、STA hold 修复里的延迟填充,都默认时序元件是边沿触发的。但真实芯片里还有另一派——电平敏感的 latch(锁存器),在高性能 CPU、定制数据通路和 clock-gating 使能端大量存在。latch 借时(time borrowing)是 latch 设计独有的时序特性:前一级路径超了可以向后一级「借」时间,只要整条链总账不亏。这个特性既是性能红利,也是签核噩梦——STA 工具算借用量有一套专门的口径,算错任何一步都会报出假违例或漏掉真违例。本篇按「原理 → 计算 → 级联 → 与 flip-flop 的签核差异 → 风险清单」的顺序讲透。
本文要回答的问题
- latch 的透明窗口是什么?为什么它能带来 flip-flop 没有的「借时」能力?
- STA 工具计算一条 latch 路径实际借了多少时间的公式是什么?借用量上限由谁决定?
- 多级 latch 级联时借时怎么传递?最大可借时间链怎么算?
- latch 设计在 setup/hold 签核、约束写法、修复手段上和 flip-flop 设计有哪些实质差异?
- latch 借时有哪些经典翻车场景?签核时要额外盯什么?
一、从 flip-flop 到 latch:借时能力的来源
flip-flop 是边沿触发元件:时钟上升沿到来的那一瞬间,D 端数据被采样进内部,之后 D 怎么变都与 Q 无关。数据在两级 flip-flop 之间可用的传播时间严格等于一个时钟周期(假设零 skew),一级慢了没有任何机制向隔壁级求救——超了就是 setup 违例,只能降频或修路径。
latch 完全不同:它是电平敏感元件。时钟为高(以高电平有效 latch 为例)的整个期间,latch 是「透明」的——D 端数据直接穿到 Q 端,像一段组合逻辑;只有时钟拉低那一刻,数据才被锁存住。这意味着数据不必在时钟沿之前乖乖到齐:只要在高电平窗口关闭之前到达,路径就仍然成立。前一级组合逻辑如果超过半个周期才到,多出来的时间是从后一级的高电平窗口里「借」来的——这就是 time borrowing。
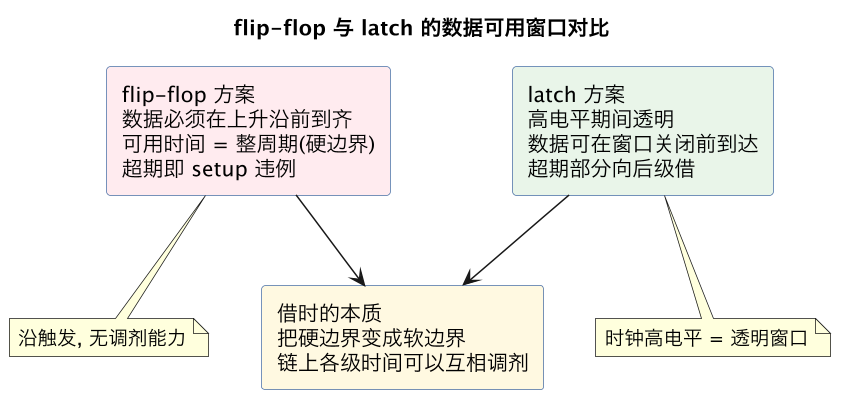
这张图里最关键的对照是「硬边界 vs 软边界」。flip-flop 的周期边界是一堵墙,latch 的周期边界是一扇半开的门——门开着的时候数据还能继续流。借时带来的直接工程收益有两个:一是平均化效应,一条逻辑深度不均的流水线(比如一级 8 级门、一级 14 级门)用 flip-flop 实现要按最深的 14 级定频率,用 latch 实现则两级可以互相匀,频率由平均深度决定;二是抗波动能力,OCV 造成的局部延迟抖动可以被透明窗口吸收一部分,不至于每条轻微超期的路径都变成违例。
历史上高性能 CPU 的定制数据通路(整数执行单元、浮点流水线)大量使用 latch 设计正是冲着这两点。代价是设计复杂度和签核难度成倍上升,这也是近二十年来主流 SoC 回归 flip-flop、只在局部保留 latch 的原因——clock gating 单元内部的使能 latch 就是每个设计里都有的活例子,见 clock gating 的 STA 检查。
二、STA 怎么算借用量:从数据到达时间到 borrow 值
STA 工具(PrimeTime/Tempus 口径)对 latch 的 setup 检查分两步:先按 flip-flop 的方式算「零借用」的到达时间需求,再看数据到底晚到了多少,晚到的部分记为借用量(time borrowed)。
以高电平有效 latch、时钟周期 T、占空比 50% 为例。数据从上一级 flip-flop(或 latch)在时刻 0 发出,到达本级 latch D 端的时刻记为 arrival。检查口径是:
- 零借用参考点:latch 打开沿(本例时钟上升沿,时刻 T/2 的前一个沿,即时钟上升沿在 0 和 T/2)之前到达的数据不需要借时。实际工具以打开沿为基准:数据在打开沿之前到,arrival 小于打开沿时刻,borrow = 0。
- 借用量:数据晚于打开沿到达的部分,borrow = arrival − 打开沿时刻。这部分时间占用了 latch 的透明窗口。
- 违例判据:数据必须在关闭沿之前留出 setup 时间。即 arrival + setup 时间 ≤ 关闭沿时刻。等价地,最大可借时间 = 透明窗口宽度 − latch 的 setup 时间(50% 占空比下约为 T/2 − setup)。borrow 超过这个上限就是 setup 违例。
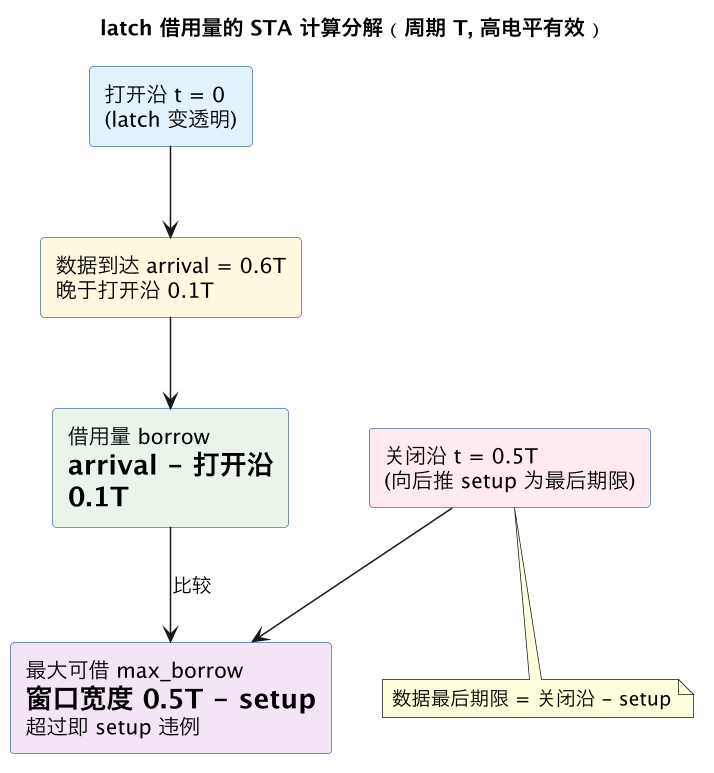
图里有一点容易绕:latch 的打开沿同时是上一级路径的「捕获参考沿」。数据在打开沿之后到达时,STA 报告里这条路径的 slack 不会立刻变负,而是体现为「time borrowed from next stage」——借走的 0.1T 会从下一级路径的可用时间里扣除。下一级组合逻辑原本有完整半周期加透明窗口可用,现在它的起始时刻被推迟了 0.1T。这就是借时的记账本质:不是凭空造时间,是在相邻级之间转移时间,STA 的账必须前后两级连起来看才平。
还有一个细节:很多工具报告 latch 路径时会同时给出「zero-borrow slack」和实际 slack。zero-borrow slack 是假设不许借时时这条路径的余量,用来评估「如果把它硬化成 flip-flop 边界会怎样」;实际 slack 则是借时生效后的数字。调阶段两个数都要看——实际 slack 为正但 zero-borrow slack 深负的路径,意味着整条链的时序平衡高度依赖借时,任何一级被 ECO 改动都可能引发连锁反应。
三、多级 latch 级联:借时的传递与上限
单个 latch 的借时好算,麻烦的是 latch 链。真实数据通路里经常出现连续三级、五级甚至整段流水都是 latch 的结构,借时沿链逐级传递,计算规则是:每一级最多只能借到自己透明窗口减 setup 的量,且前一级借走的时间从后一级的可用窗口里扣,直到某一级数据在打开沿之前到达(借时归零)或到达链尾的硬边界。
用具体数字走一遍。周期 1ns、占空比 50%、每级 latch 的 setup 为 30ps,三级 latch 级联,每级之间组合逻辑延迟分别是 620ps、540ps、380ps(零借用基准是每级 500ps):
- 第一级:数据 620ps 到达,打开沿在 500ps,借 120ps。上限 500 − 30 = 470ps,借得起。
- 第二级:起始时刻被推迟 120ps,数据 120 + 540 = 660ps 到达,相对打开沿(500ps)借 160ps。
- 第三级:起始时刻 660ps,数据 660 + 380 = 1040ps 到达,相对打开沿(1000ps)借 40ps。
- 链尾:如果第三级 latch 后面接的是 flip-flop(硬边界),flip-flop 在 1500ps 采样,数据 1040ps 加上 flip-flop 前的组合逻辑必须在此之前稳定——借时链在硬边界处终结,总账必须平。
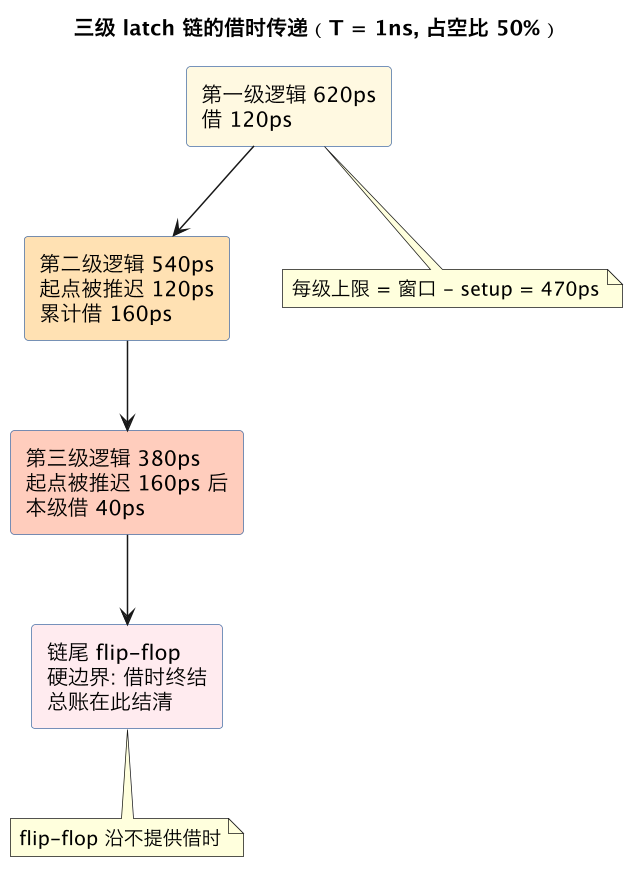
从这张链式图能看出两条重要规律。第一,借时不会放大:后一级借的量不一定比前一级大,它取决于本级逻辑延迟减去半周期后的盈余或缺口,逻辑短的级会自动「还」时间(第三级就只借了 40ps)。第二,链必须有硬边界终结:借时链的终点要么是 flip-flop,要么是 latch 的非透明沿,整条链总延迟(各级逻辑加链尾 setup)必须小于等于「链长周期数 × T + 最后一级的窗口借用量」。STA 工具内部对 latch 链做的是沿链的迭代收敛计算,报路径时会把整条借时链一起吐出,读报告时千万别只看最后一级的 slack。
级数越多,工具计算越敏感。经验上超过 4-5 级连续 latch 的链,PBA 模式(见 GBA 与 PBA 分析模式)下路径会显著增多,签核运行时间成倍涨——这也是流程上通常限制 latch 连续级数的原因之一。
四、与 flip-flop 设计的签核差异
latch 设计和 flip-flop 设计在签核桌上的待遇完全不同,差异集中在五个方面:
| 维度 | flip-flop 设计 | latch 设计 |
|---|---|---|
| setup 检查边界 | 每级独立,周期硬边界 | 级间耦合,借时沿链传递 |
| setup 最坏角 | ss 角 + 低温/高温按节点 | 同左,但借用量本身随 PVT 漂移,窗口宽度也在变 |
| hold 检查 | 同沿零周期检查 | 更严苛:透明窗口内数据随时可能穿过,hold 按打开沿检查 |
| 约束写法 | create_clock 加常规 I/O 约束 | 常需显式声明 latch 属性、占空比、max borrow 限制 |
| 修复手段 | sizing / 换 VT / 插 buffer / 重组逻辑 | 同左,外加调占空比、限制借时、拆链插 flip-flop |
逐条展开。
setup 侧的耦合性是最根本的差异。flip-flop 设计里修一条 setup 违例只影响该条路径前后各一级;latch 链里动任何一级,借用量沿链重新分配,前后好几级的 slack 全变。做时序 ECO(见 时序收敛 ECO)时 latch 链区域要像对待时钟树一样小心——改一处,回归一片。
hold 侧更严苛是 latch 设计最容易被低估的成本。flip-flop 的 hold 是同沿检查,修起来目标明确;latch 在透明期间数据直接穿透,hold 检查以打开沿为参考,等价于要求数据在 latch 打开之后还得稳定一段时间——短路径在 latch 设计里比 flip-flop 设计更容易违例,修复量通常大得多。修法和 STA hold 修复讲的一样是加延迟,但 latch 链上的 hold 违例往往成片出现,buffer 插多了又反过来吃掉 setup 借时空间,左右互搏。
约束写法上,纯 flip-flop 设计的时钟约束一个 create_clock 就够了;latch 设计经常要额外处理:非 50% 占空比要用 create_clock 的波形参数准确描述(窗口宽度直接决定可借上限)、用 set_max_time_borrow 限制某些 latch 的最大借用量(防止借时链把时序压力集中到链尾)、多相时钟(两相不重叠时钟驱动的 latch 交替链)要把每个相位的波形都建对。约束错了借时计算全盘皆错,所以 SDC 约束检查对 latch 设计的价值比常规模块更大。
时钟树与占空比是 latch 设计的另一条暗线。flip-flop 设计对 skew 敏感但对占空比钝感;latch 的透明窗口宽度由占空比直接决定,时钟经过 buffer 链后占空比会漂移(上升下降延迟不对称积累),窗口缩水多少,可借上限就缩多少。signoff 时 latch 设计必须把 duty cycle 随 PVT 的变化纳入时钟抖动预算,见 时钟延迟与 skew。
五、风险清单:latch 借时的经典翻车场景
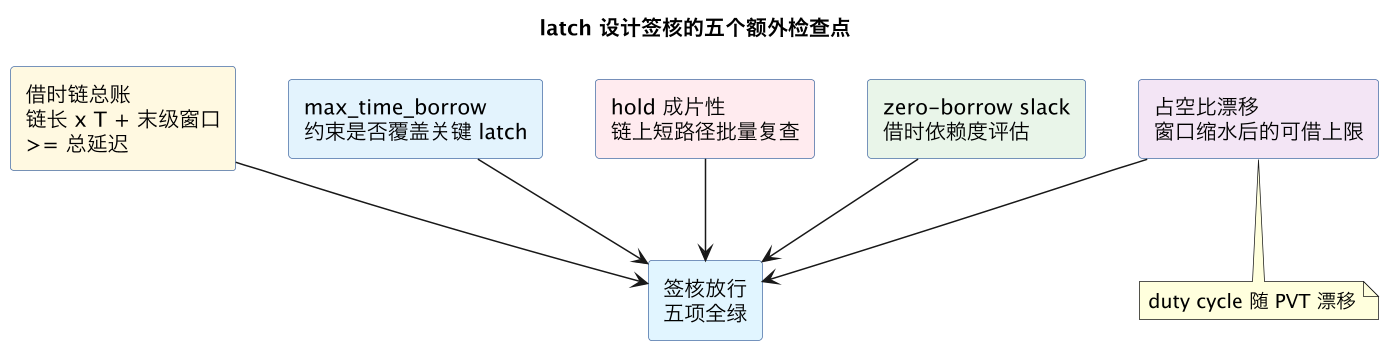
把上面的机制落到工程事故上,latch 借时的风险集中在六个场景:
- 借时链尾爆雷。每一级借得都不多、单看每级 slack 都是正的,但链尾 flip-flop 前的总账超期。原因通常是中间某级被 ECO 加了几级逻辑,借用量沿链重新分配后全部压力转移到链尾。对策:回归时把整条借时链的路径组一起看,不要只修报出来的那个端点。
- 占空比假设失真。约束里写 50% 占空比,实际时钟网络输出 52%/48%,可借上限凭空少了 20ps 以上,先进节点这足以让一批路径从绿变红。对策:签核用实际时钟网络仿真或时钟树的实测占空比反标。
- hold 修复吃掉借时空间。latch 链上修 hold 插的 buffer 同时落在 setup 借时路径上,hold 修绿了、借时上限被打穿。对策:hold 修复器要对 latch 链设置更紧的 setup 保护余量,修完连链回归。
- max_time_borrow 缺失。没设借时上限时,工具默认允许借满整个透明窗口,某些 latch 会深度依赖借时,PVT 变化下第一个崩。对策:对关键 latch 显式约束 set_max_time_borrow,把借时用量限制在窗口的 50%-70%,留出角间漂移余量。
- 扫描模式下的借时失效。功能模式的 latch 链在扫描移位时路径完全不同,借时平衡不复存在;扫描模式的时序要单独按 flip-flop 式的硬边界签。见 Tessent ATPG 与扫描。
- GBA/PBA 差异被放大。借时链上级数多,GBA 的悲观度假设沿链累积,PBA 重算后违例数经常骤降一个量级——但也意味着只跑 GBA 就去修 latch 链会浪费大量 ECO 精力。对策:latch 密集模块直接以 PBA 为修复依据,运行时间换修复精度。
这些场景的共同根源其实是一句话:借时让时序从「局部问题」变成「链上全局问题」。flip-flop 设计的所有检查和修复都是局部的,latch 设计的每一件事都是全局的——这是它的性能红利对应的全部代价。
这一篇在知识体系里的位置
- 上游:setup/hold 检查的基本口径见 GBA 与 PBA 分析模式,时序单元的延迟模型来自 Liberty NLDM/CCS 时序模型,时钟侧的变量见 时钟延迟与 skew 与 CTS 时钟树。
- 同层:悲观度处理见 Derate 与 POCV,约束写法与检查见 SDC 约束检查,时钟门控使能 latch 的半周期检查见 clock gating 的 STA 检查。
- 下游:latch 区域的 setup 修复手段(sizing、换 VT、useful skew)见 useful skew 与 CTS 优化,hold 侧见 STA hold 修复,最终收敛进 PrimeTime 签核 与 时序收敛 ECO 的迭代闭环。
总结
latch 借时的本质是电平透明窗口把周期硬边界变成软边界:数据晚于打开沿到达的部分向后一级借时间,STA 按「到达时刻减打开沿」记账、以「窗口宽度减 setup」为借用上限,借时沿链传递并在链尾硬边界结清总账——它换来流水线时间调剂与抗波动红利,代价是 setup 级间耦合、hold 更严苛、占空比与 max_time_borrow 约束一个都不能缺,签核时必须把借时链当全局问题看,只修单级必翻车。