persistent kernel 解码:一次 launch 跑完整个 decode step 的 megakernel 路线
更新时间:2026-10-04。前面 kernel launch 开销与融合 讲过为什么小 kernel 扎堆会饿死 GPU,CUDA Graphs 捕获回放 讲过怎么用图回放压掉启动开销。但 decode 阶段有个更狠的问题:每轮几十微秒的 step 里塞着二三十个 kernel,即使 Graph 回放消掉了 CPU 侧启动成本,kernel 之间的收尾-启动间隙和 wave 尾段空洞仍在 GPU 侧漏时间。persistent kernel 解码(持久内核解码)给出的答案是:干脆只 launch 一次,让整个 decode step 的所有算子在一个常驻 grid 里跑完。本篇讲它的结构、同步机制、适用范围和坑。
本文要回答的问题
- decode step 的 kernel 序列里到底有多少时间漏在「缝」里?
- persistent megakernel 的一次 launch 内部是怎么组织全部算子的?
- 常驻 grid 靠什么做算子间的全局同步,同步本身要花多少?
- 什么形状的工作负载适合上 megakernel,什么形状反而更慢?
- 它和 CUDA Graphs、kernel 融合是什么关系,能不能叠用?
一、先算账:decode step 里漏掉的微秒
decode 阶段每请求每步只产 1 个 token,整个前向是 memory-bound 的:GEMM 都退化成 GEMV,算力严重过剩,瓶颈在权重搬运。一个典型 70B 级模型的 decode step,展开后是 30~60 个 kernel 的序列——每层的 RMSNorm、QKV 投影、RoPE、attention(常是 split-K 的 FlashDecoding 两阶段)、O 投影、残差加、MLP 三个 GEMV,再加上层间的归一化。每个 kernel 的实际计算往往只有 3~15 微秒。
漏时间的缝有三类。第一类是启动与收尾间隙:即使 CUDA Graph 消掉了 CPU 提交成本,GPU 侧前一个 kernel 全部 block 退完、后一个 kernel 的 block 铺满 SM,中间仍有数百纳秒到一两微秒的空窗,30 个 kernel 就是几十微秒级的累积。第二类是 wave 尾段空洞:GEMV 的最后一 wave 常常只用了一半 SM,其余 SM 干等——而小 kernel 的尾段占比特别大。第三类是依赖串行化:attention 的输出没写完,O 投影就不能开,中间是硬等待,调度器无法把不同算子的波峰波谷拼起来填洞。
经验数字:batch 中小(4~32)、模型 13B~70B 时,decode step 实测 GPU busy 时间常常只占墙钟的 60%~80%,剩下的全在缝里。当单步目标压到 50 微秒以内时,这 20%~40% 就是决定胜负的部分。
用 Nsight Systems 看一条 decode 时间线会非常直观:满屏都是细碎的彩色小段,段与段之间是肉眼可见的空白。把某个 13B 模型、batch 8 的 step 放大看,单步墙钟约 210 微秒,其中 kernel 实际执行约 150 微秒,剩下 60 微秒里 kernel 边界间隙占 40 微秒上下,attention 两阶段之间的硬依赖等待又吃掉十几微秒。更要命的是这批缝隙是「每步必付」的固定税:模型越大层数越多,kernel 数量线性涨,缝隙总量也跟着线性涨,而每步产出的 token 数永远是 1——缝隙占收入的比重只会越来越高。
二、megakernel 结构:一次 launch,grid 常驻,软件流水
persistent kernel 解码的思路是把上面整条序列塞进一个 kernel:启动一个固定大小的 grid——block 数恰好铺满所有 SM(每 SM 一两个 block,常驻不退),然后在这个 grid 内部用一个算子状态机依次执行本 step 的全部计算。
上图的关键设计有三点。第一,block 常驻:所有 block 在 kernel 开头被一次性调度到 SM 上,之后永不退出,靠循环遍历「层 × 阶段」完成全部工作,彻底消掉启动间隙。第二,算子内并行度重新切分:传统做法每个 kernel 自己决定 grid 形状;megakernel 里 grid 固定,每个阶段把工作量(多少行权重、多少个 KV 分片)均摊到这固定数量的 block 上,等于手工做跨算子的负载均衡,wave 空洞被一个阶段内部的细粒度切分摊薄。第三,同步集中显式化:算子间的依赖从「kernel 边界天然同步」变成显式的全局栅栏。
和单纯融合的区别要分清:RMSNorm+RoPE 融合 这类是「相邻几个算子合成一个 kernel」,kernel 数量从 40 降到 15;megakernel 是直接降到 1,把融合推到极限,代价是放弃了「每个算子用最优 grid 形状」的自由。
三、同步的代价:grid 级栅栏并不免费
persistent kernel 的核心技术难点在同步。CUDA 提供 cooperative groups 的 grid.sync(),前提是用 cooperative launch 启动且 grid 不超驻留容量;不走路营 API 的实现则用手写的到达计数自旋栅栏:每个 block 完成后对全局计数器 atomicAdd,然后自旋等计数到达 block 总数。两条路的开销量级接近:全 GPU 一次栅栏大约 1~3 微秒(视 SM 数和显存延迟),一个 decode step 需要几十到上百次栅栏。
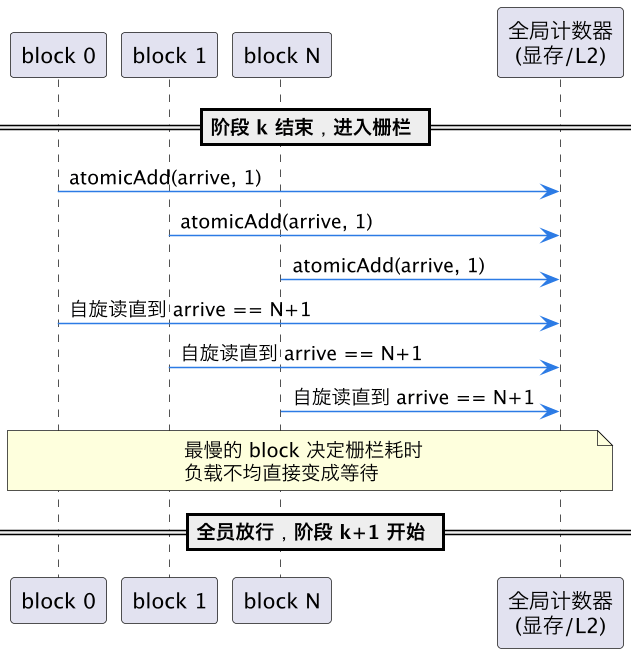
上图暴露了两个隐含成本。其一,栅栏的耗时由最慢 block 决定——任何阶段的负载不均(比如 split-K 的 KV 分片长度不齐)都直接变成全员等待,所以 megakernel 的实现往往花大量精力做阶段内的静态负载均衡。其二,自旋本身烧内存带宽:上百个 block 轮询同一个计数器会产生 L2 热点,工程上常用树形到达、分级栅栏或让计数器驻留 L2 来缓解。这就是为什么 megakernel 不是「无脑赢」:省下的启动缝如果是 1 微秒,付出的栅栏是 2 微秒,就亏了。只有当每算子的缝隙开销显著大于一次栅栏、且阶段划分足够粗(一层几十微秒分 4~6 个阶段而非 20 个)时,账才算得过来。公开报告(如 FlashInfer、mirage 系的工作)在 70B 级小 batch decode 上拿到 1.1~1.4 倍加速,前提正是这两个条件成立。
四、适用范围:什么时候上,什么时候别上
persistent megakernel 的收益结构决定了它有明确的甜区。
| 维度 | 适合上 megakernel | 不适合 |
|---|---|---|
| batch 规模 | 小(1~32),GEMV 为主 | 大 batch,GEMM 已吃满 SM |
| 单算子时长 | 微秒级,缝隙占比高 | 算子本身就几十微秒 |
| 模型结构 | 规整同构层(Llama 系) | 层形状差异大、带动态分支 |
| 硬件 | SM 数固定、单卡或 TP 内 | 跨节点、grid 无法常驻 |
| 维护成本 | 愿意手维护一份 megakernel | 依赖现成算子库快速迭代 |
大 batch 是最清晰的反例:batch 一大,GEMV 变回 GEMM,每个算子自己就能把 SM 喂满,缝隙占比缩到 5% 以内,megakernel 省的钱付不起栅栏和「放弃 cuBLAS 最优形状」的税。prefill 同理不适合——所以实际部署里 megakernel 只接管 decode,prefill 走常规路径,两者在 continuous batching 调度器 里分叉。
它和既有优化不冲突、可叠用:CUDA Graphs 管 CPU 侧提交开销,megakernel 管 GPU 侧缝隙,两者解决的问题正交——很多实现里 megakernel 本身也被 Graph 包起来做逐 token 回放。KV cache 量化 这类改数据通路的优化则直接搬进 megakernel 的 attention 阶段内部。工程上的一个稳妥打法是渐进迁移:先把缝隙最大的相邻算子对合并成两三个中型 kernel 验证收益,确认甜区成立后再整体推到 megakernel,避免一上来就背全部调试成本。
五、落地风险:调试、可移植与数值
最后说坑。一是调试地狱:一个 kernel 跑完整个 step,任何一个阶段算错,你面对的是一个几十万行的「单体 kernel」,Nsight 里看不到算子边界,得自己在阶段间插桩。二是可移植性差:grid 大小、每阶段切分都按特定 GPU 的 SM 数、L2 容量手工调,换卡几乎要重做一遍 Triton 式自动调参 在这里帮不上太多。三是占用率天花板:常驻 block 的寄存器和 shared memory 预算是「所有阶段的最大值」,attention 阶段要的大 shared memory 会压 GEMV 阶段的并发度,这个内部权衡常常吃掉理论收益的一部分。
这一篇在知识体系里的位置
本篇是 decode 优化链条上「省启动开销」这一支的最激进形态:上游是 kernel launch 开销与融合(为什么要省)和 CUDA Graphs 捕获回放(CPU 侧怎么省);同层对照 attention kernel 优化全景(算子内部怎么省)和 FlashDecoding split-K(megakernel 里 attention 阶段的常见形态);下游衔接调度层 continuous batching 调度器(prefill/decode 路径分叉)。选型建议一句话:batch 小、模型大、单步要压进几十微秒时再考虑它,先把 Graphs 和融合的红利吃完。
总结
persistent kernel 解码把整个 decode step 的几十个微秒级 kernel 合并成一次 launch:固定大小的常驻 grid 铺满 SM 后不再退出,内部用算子状态机逐阶段执行 RMSNorm、GEMV、attention、MLP,阶段间靠 grid 级栅栏(grid.sync 或原子计数自旋)同步,从而消掉 kernel 间启动间隙与 wave 尾段空洞,在 13B~70B 小 batch decode 上可拿到 1.1~1.4 倍加速;代价是每次栅栏 1~3 微秒、负载不均直接变成全员等待、grid 形状失去按算子最优化的自由,所以只适用于缝隙开销占比高的小 batch decode 场景,大 batch 与 prefill 仍走常规多 kernel 路径,且它与 CUDA Graphs、KV cache 量化等手段正交可叠用。