综合边界优化:跨层次 constant 传播、等价合并、端口穿透与 ungroup 取舍
更新时间:2026-10-04。综合边界优化(boundary optimization)是逻辑综合里最容易被「默认设置」糊弄过去的一环:在 逻辑综合与 Design Compiler 的总流程里,工具默认会跨模块边界做一系列改写——把端口常量灌进子模块、把功能等价的子模块合并成一份、把子模块的端口逻辑穿透到边界上。这些变换常常能拿到肉眼可见的 QoR 收益,但也会悄悄改变层次结构,给 形式验证 LEC 与 Formality、模块复用、物理实现带来连锁反应。这一篇把三类边界变换的机制讲透,再把 ungroup(打散层次)的三种策略摆上桌,给出「什么时候保边界、什么时候放手」的判据。约束侧的背景见 综合约束与 SDC,QoR 怎么读见 综合 QoR 报告解读。
本文要回答的问题
- 综合边界优化具体包含哪三类变换,各自改写网表的什么位置?
- constant 传播为什么能让子模块「缩水」,它改变的是功能还是实现?
- 等价合并(uniquify 的反面)什么时候省面积、什么时候反而害了复用?
- ungroup 的 flatten / auto / 保持三档各自换到什么、付出什么?
- 层次保持和 QoR 收益冲突时,工程上用什么判据拍板?
一、边界是什么:综合眼里的模块墙
RTL 里的 module 例化在综合中期变成一层一层的层次单元(hierarchical cell)。默认情况下,综合工具把每一层边界当成一堵「半透明的墙」:墙内的逻辑可以自由优化(工艺映射、结构重组、尺寸调整),墙与墙之间的逻辑也可以优化,但穿过墙的变换——比如把墙外一个已知常量推进墙内、把墙内一级反相器挪到墙外——默认只在工具认为「安全」的口径下做。这堵墙不是物理存在,而是综合器内部的一个属性位:边界优化开或关、ungroup 与否,都只是改这个属性。
为什么要保留这堵墙?因为层次结构承载了设计意图之外的一堆工程信息:模块是复用单元(同一个模块在芯片里例化 50 次,保持边界就能只优化一次、到处复用);模块是验证单元(LEC 按层次对点,边界在,对点就在);模块是物理单元(层次化布局布线、ILM/ETM 接口模型 都依赖稳定的边界);模块还是责任单元(网表里 u_dma/u_axi 这种路径名是 debug 和 ECO 的路标)。墙推倒了,这些信息全部重排。
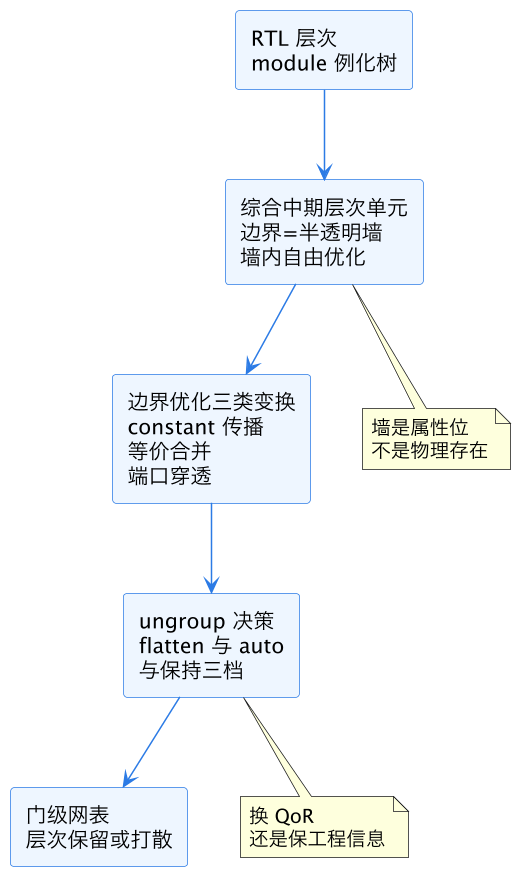
这张图是本文的主线:从 RTL 层次到门级网表,中间隔着「边界优化」和「ungroup 决策」两道关口。读图时注意顺序——边界优化先发生(在墙还在的时候穿墙做改写),ungroup 后发生(决定墙还留不留)。两者经常打包出现:先穿墙把能捞的收益捞完,再把空壳一样的墙拆掉。
二、三类跨边界变换:机制与代价
constant 传播:把端口常量灌进墙内
最常见的一类。上层模块用 inst u_core (.mode(1'b0), ...) 把子模块某个配置端口钉死在常量上,综合器发现后把这个常量沿边界推进子模块内部:所有以 mode 为条件的逻辑被常量折叠——if (mode) 分支整个消失、相关寄存器被优化掉、下游组合锥缩水。一个「通用」的 IP 核在某个例化点上可能因此砍掉 20%-40% 的无效逻辑。类似地,上层输出端口如果被发现只接到常量负载(比如接到 tie 单元或未连接),墙内的驱动逻辑也会被反向消掉。
代价是这一个例化点从此「特化」了:它和别的例化点不再是同一个东西,必须各自独立优化(这就是 uniquify 的由来,见下一节)。功能不变——这是纯实现层变换,LEC 能轻易对点;但网表里的模块结构变了,原本整齐的层次里长出一个「被削掉一半」的实例。
等价合并:发现两个模块其实一样
反过来的一类变换。设计里经常出现「写法不同、功能等价」的子模块——两个小组各自写的 byte swap、不同例化参数退化成相同配置的生成块。综合器做结构化比对后发现等价,可以把它们合并成同一份实现(共用同一个模块定义),或者反过来:原本共享的一份定义,因为 constant 传播后各例化点特化程度不同,必须拆成多份(uniquify)。等价合并省的是编译内存和优化时间(优化一次,处处生效),uniquify 花的是同样的东西,买的是每个例化点各自的局部最优。两者是同一个旋钮的两面。
端口穿透:把逻辑挪过墙
最激进的一类。典型场景:子模块输出端口内侧紧挨着一级反相器,外侧紧挨着一级与非门——两个门隔着边界相望。边界优化允许综合器把反相器「推」出边界(或把外部门「拉」进边界),让两级逻辑在同一优化域里合并成一个门。再进一步,穿边界的寄存器-组合逻辑链可以被整体重组,这直接打通 综合重定时与寄存器搬移 在边界上的通路——寄存器可以跨过模块边界搬移,时序收益常常就在这里。
代价最重:端口的驱动逻辑变了,接口时序预算(见 IO 时序预算约束)的假设可能被破坏;LEC 对点变难,尤其是寄存器跨界搬移后需要做顺序等价(SEC)而不是简单组合等价;网表路径名面目全非,后续 ECO 找不到路标。
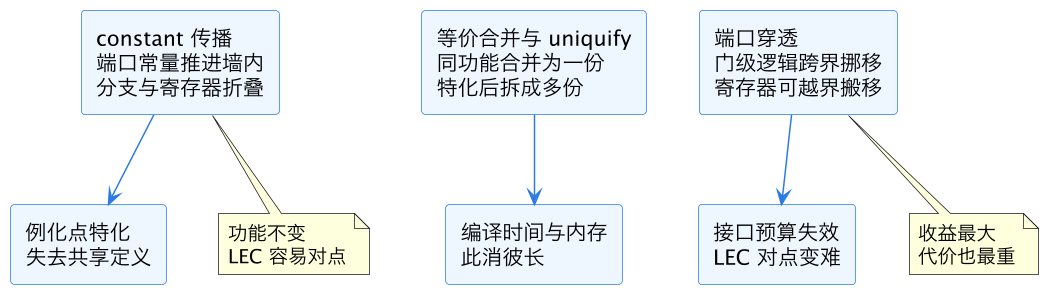
这张图把三类变换和各自的主要代价一一对应。核心记忆点:收益和代价都按 constant 传播 → 等价合并 → 端口穿透的顺序递增。工程默认策略也该按这个顺序收紧——constant 传播几乎总是该开,等价合并视编译资源定,端口穿透只在追 QoR 的关键模块上放。
| 变换类型 | 改写位置 | 功能是否变化 | 主要收益 | 主要代价 |
|---|---|---|---|---|
| constant 传播 | 边界内侧逻辑折叠 | 否 | 面积 -20%~40%(特化例化点) | 例化点特化、失去共享 |
| 等价合并 / uniquify | 模块定义层 | 否 | 编译时间或局部 QoR | 内存与编译时间此消彼长 |
| 端口穿透 | 边界两侧门与寄存器 | 否(但结构大变) | 关键路径时序、门数 | 接口预算失效、LEC 变难 |
三、ungroup:决定墙还留不留
边界优化做完,综合器面对一堆被穿墙改写得七零八落的层次,要做第二个决定:这些墙本身还留不留?这就是 ungroup 三档策略。
保持(preserve):所有用户定义的层次原样保留,只允许工具新增的优化层次。适合层次化物理流程(模块要独立布图、独立签核,见 层次化流程与 ILM/ETM)、强复用场景(硬核 IP 外围的 wrapper 必须稳定)、以及顶层集成阶段(边界即团队接口,动了谁都接不上)。
自动(auto ungroup):工具按收益阈值自行决定拆哪些墙——小模块(比如几百门以下)默认拆掉,因为小模块的边界维护成本高于优化收益;大模块、被多处例化的模块保留。这是多数 flat 综合流程的默认档,也是最「省心但不透明」的一档:综合报告里会列出被拆掉的实例清单,QA 时必须过一眼,确认没有误拆关键模块。
全平(flatten):除明确标记 dont_touch / size_only 的对象外全部打散,整个设计变成一个巨大扁平优化域。QoR 上限最高——所有跨边界变换都不再受限,全局共享逻辑(跨模块的公共子表达式)也能被挖出来;代价是编译时间暴涨(优化问题规模是实例数平方级的某些算法直接吃不消)、LEC 难度剧增、网表完全失去层次路标,ECO 变更传播 几乎无法增量做。实战里 flatten 只用于中小型 block(几十万门以内)或 QoR 死活过不去的攻坚场景。
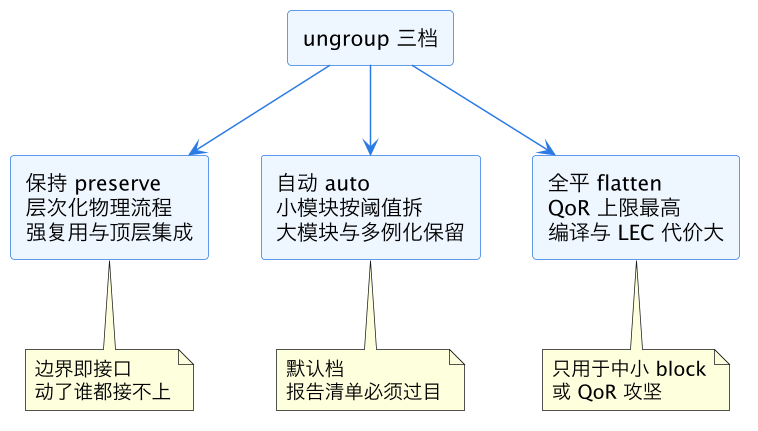
这张图是 ungroup 决策树。注意它不是三选一的全局开关——实际工程里几乎总是混合使用:顶层保持、关键数据通路模块 auto 甚至 flatten、标准复用 IP 保持并用 dont_use 与 dont_touch 流程 钉死属性。混合策略的颗粒度管理,正是综合工程师的经验所在。
| 策略 | QoR 上限 | 编译时间 | LEC 难度 | 适用场景 |
|---|---|---|---|---|
| preserve | 低 | 快 | 低 | 层次化流程、顶层集成、复用 IP |
| auto ungroup | 中 | 中 | 中 | flat 综合默认档 |
| flatten | 高 | 慢(可能数倍) | 高(常需 SEC) | 中小 block、QoR 攻坚 |
四、冲突拍板:层次保持 vs QoR 的判据
边界优化和 ungroup 的所有争论,最后都落到一个问题:这一堵墙换的 QoR 值多少钱?给一组可操作的判据。
第一看物理流程形态。走层次化布图(模块独立布局布线再顶层拼装)的项目,边界就是物理合同的边界,拆墙等于撕合同——此时 QoR 损失靠模块内优化和接口预算收紧来补,而不是靠拆墙。走 flat 物理流程的项目,墙只是逻辑组织手段,拆墙成本低得多。
第二看复用密度。一个例化超过 10 次的模块,保持共享定义的编译收益和 LEC 对点收益非常大,拆墙前要三思;只例化一次且不参与复用的粘合逻辑(glue logic),墙基本没有保留价值——很多团队的规则是「单例化 + 小于 5 万门的非 IP 模块一律 auto」。
第三看关键路径穿墙率。从 综合 QoR 报告 里统计 WNS 前 100 条违例路径中有多少条穿过同一类边界:如果某两个模块之间的边界反复出现在关键路径上(比如跨越 30 条以上),这堵墙就是时序瓶颈,穿透或拆掉它的收益可量化——拆后重综合对比 WNS/TNS 变化即可拍板。反过来,关键路径全部落在模块内部时,边界怎么动都不影响 QoR,那就选工程代价最小的保持档。
第四看验证资源。端口穿透开得越狠,LEC 越可能从组合等价滑向顺序等价,LEC 不等价 debug 的时间成本按天计。验证团队人手紧、里程碑近时,宁可牺牲 1%-2% 的 QoR 也要保住组合等价的边界。
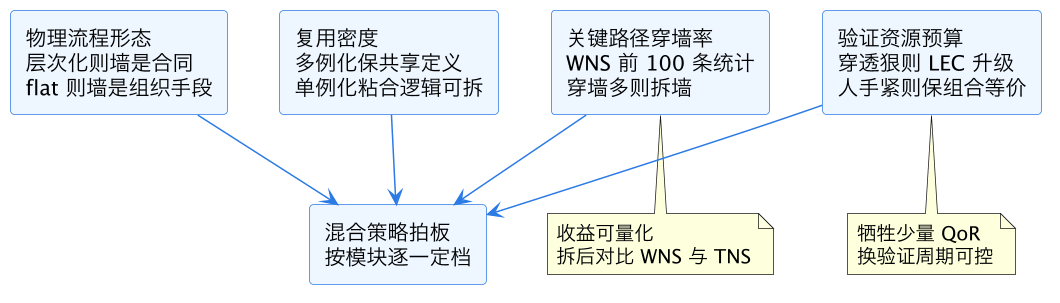
这张图是四个判据汇入同一个决策。四个判据的优先级实战中大致是:物理流程形态 > 验证资源 > 关键路径穿墙率 > 复用密度——前两个是「能不能」的硬约束,后两个是「值不值」的软权衡。
五、落地清单与常见坑
把上面的机制落成 checklist。综合启动前:在 综合约束与 SDC 里确认接口预算的假设和边界优化口径一致(端口穿透开启后,原本假设「边界即寄存器」的预算要复核);对必须保层次的模块预先打 set_dont_touch 或 boundary optimization 关闭属性,别等网表出来再追。综合结束后:读 ungroup 报告清单,核对被拆模块都在预期内;LEC 前先确认工具的边界优化记录(变换日志)能被验证工具消费——Formality 读不到变换日志时,跨界寄存器搬移就是一场灾难。进 综合交接数据流 时,网表的层次清单要和物理实现的模块划分对齐,物理侧按旧层次做的布图规划遇到被打散的网表,是第一优先级要拦住的事故。
常见坑有三个,都见过真实翻车。坑一:constant 传播后某例化点特化缩水,但 SDC 里还按通用模块写的时序例外(比如对已被折叠掉的路径写 false_path),约束悬空不报error,到 SDC 验证与约束 lint 才暴露。坑二:auto ungroup 把小模块拆了,网表路径名全变,复用旧脚本的 ECO 流程批量失配。坑三:wlm 模式下(见 线载模型综合)边界优化按线载模型估算穿墙路径延迟,到了物理实现线长完全不同,当初「值得穿透」的判断失效——综合口径和物理口径错位是这类坑的根因,缓解办法是综合后期开物理感知(physical aware)模式或尽早进 布图规划与摆放数据流 迭代。
这一篇在知识体系里的位置
本篇是 eda/ 目录综合线的「边界与层次」专文。上游接 逻辑综合与 Design Compiler 的总流程和 综合约束与 SDC 的约束口径;横向同族是 综合重定时与寄存器搬移(端口穿透打开了它的跨界通路)、ICG 插入综合流程(门控单元同样涉及层次落点)、dont_use 与 dont_touch 流程(属性管理是混合策略的执行手段);下游落地到 综合 QoR 报告解读 的效果度量、综合交接数据流 的交付对齐、层次化流程与 ILM/ETM 的物理侧依赖,以及 形式验证 LEC 与 Formality 和 LEC 不等价 debug 的验证侧闭环。读完本篇,综合报告里每一条 ungroup 记录、每一个被穿透的端口,你都能说清它换来了什么、赌上了什么。
总结
综合边界优化是综合器跨模块墙做的三类改写——constant 传播把端口常量灌进墙内折叠无效逻辑(例化点特化)、等价合并与 uniquify 在共享定义和局部最优之间调档、端口穿透把门与寄存器挪过边界打通时序通路(收益最大、接口预算和 LEC 代价也最大)——而 ungroup 的保持、自动、全平三档决定墙本身留不留;拍板用四个判据:物理流程形态定「能不能」、验证资源定「敢不敢」、关键路径穿墙率定「值不值」、复用密度定「亏不亏」,落地时以混合策略逐模块定档,并用约束 lint、ungroup 报告清单和 LEC 变换日志三道检查拦住口径错位的事故。