track 分配:track assignment 对耦合与时序的影响及长 net 优先策略
更新时间:2026-10-02。在布线这条流水线上,全局布线(global routing)只管把 net 穿进一个个 GCell 格子,详细布线(detailed routing)才在格子内把线真正画出来,而夹在两者之间的 track 分配(track assignment)常常被忽略——它决定每条 net 落在哪一根走线轨道(track)上、和谁做邻居。邻居选得好不好,直接决定平行耦合长度,进而决定串扰增量延迟。本站 全局布线拥塞分析 讲过全局阶段的格子与导向,布线拥塞、DRC 与串扰 给过三者的整体关系,STA 串扰 SI 增量延迟 讲了耦合延迟怎么进时序。这一篇聚焦中间这一环:track 分配到底在优化什么,为什么「长 net 优先」是几乎所有实现的共同选择。
本文要回答的问题
- track 分配在布线流程里处于什么位置,它的输入输出各是什么?
- 同层相邻 track 上两条线的平行长度如何换算成耦合电容与时序代价?
- 为什么长 net 要先分配,短 net 后分配,反过来会付出什么代价?
- track 分配阶段还能做哪些时序友好的动作(拉开间距、换层、预留 track)?
- 评估 track 分配质量时该看哪些指标?
一、track 分配在流程里的位置
先进工艺下一层金属的走线轨道是离散的:每层有固定的 pitch(轨道间距),信号线只能落在track 上。全局布线的产物是每条 net 的「导向」(guide)——一串 GCell 加偏好的层范围,粒度很粗,一个 GCell 里可能有七八根 track,guide 并不指定用哪一根。详细布线则要求每段 wire 的坐标、宽度、via 完全确定。track 分配的任务就是在两者之间把「哪根 track」先定下来:在 guide 允许的范围内,为每段 net 选一个具体的 track 和大致的走线区间,输出一份「准详细」的布线方案,交给详细布线做最后的 DRC 清理与微调。
这一步存在的意义是降复杂度。详细布线如果直接在网表级自由度下同时决定 track 选择、绕线和 DRC 修复,问题规模会失控;先把 track 定死,详细布线就退化成每根 net 局部的连线与修违规,可控得多。流程背景见 数据流 S4:CTS 与布线阶段。
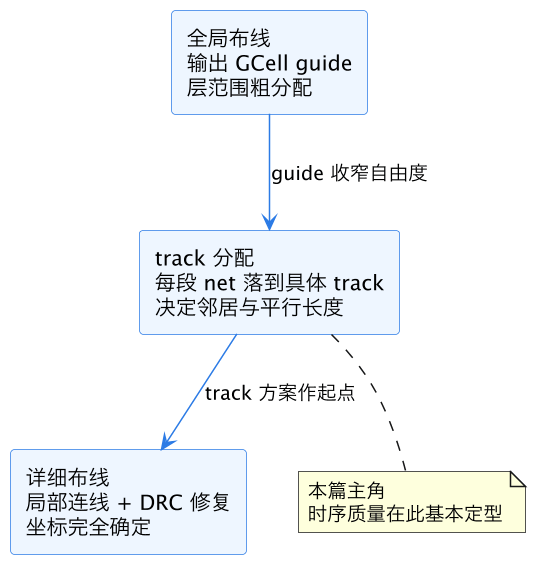
读这张图要记住一句话:详细布线能改的主要是「怎么连得合法」,而「和谁挨着、挨多长」在 track 分配阶段已经定了大半。也就是说,耦合电容的大头在 track 分配提交的那一刻就锁死了,后面的 SI 驱动时序修复只能在这个既定格局上打补丁。
二、平行长度如何换算成耦合与时序代价
耦合电容的物理很直白:同层相邻两根金属线,侧面正对,间距越小、平行长度越长,互容越大。先进工艺下金属层高变矮、线宽变窄,侧面面积占比上升,侧向耦合电容在总线电容中的占比轻松过半。一条 net 的总延迟里,耦合分量不仅抬升负载,更麻烦的是它随邻居切换方向变化——邻居同向切换时延迟变小,反向切换时延迟变大,这就是 STA 串扰 SI 增量延迟 讲的 delta delay。
track 分配直接操纵这两个变量中的「平行长度」和部分操纵「间距」。举个具体数字:M3 层最小间距下,两条线平行跑 100 微米产生的耦合电容,可能相当于几十微米走线的对地电容;如果 track 分配把这两条线在两根相邻 track 上并行排了 300 微米,反向切换时引入的增量延迟可以上百皮秒——在 0.7V 签核角点下,这足以把一条本来有裕量的 setup 路径打穿。而如果分配时把它们错开——中间隔一根空 track,或者干脆错层——耦合直接降一个数量级。
所以 track 分配的本质是一个带约束的「排座位」问题:座位是 track,人是 net 段,约束是 guide 和 DRC 间距规则,目标函数里权重最大的两项就是总线长(别绕路)和关键 net 的耦合暴露量(别和 aggressor 长距离并行)。
三、为什么长 net 优先
几乎所有 track 分配实现都按 net 长度降序处理:先分长的,再分短的。理由有三层。
第一层是资源竞争。长 net 跨越多个 GCell,对 track 的占用是连续的——它需要在每一格里都拿到同一根(或能对齐换层的)track,可用选择本来就少。如果短 net 先下手,把沿途 track 零碎占用掉,长 net 就会被切得七零八落,被迫频繁换层。每一次换层都要打 via,via 自带电阻电容,还引入对准和天线风险,一段路换三次层,延迟和可靠性都在亏。
第二层是耦合暴露与长度成正比。长 net 的耦合暴露量天然大:同样的邻居质量,300 微米的 net 积累的耦合是 30 微米 net 的十倍。先分长 net,可以在轨道资源还充裕的时候给它挑好邻居——旁边是静态 net(电源地、恒定电平信号)、是 timing window 不重叠的 net,或者干脆旁边留空 track。短 net 后分,即使邻居不理想,绝对耦合量也小,SI 引擎算出来的增量延迟有限。
第三层是时序关键性相关。经验上跨模块的长 net 更容易出现在 setup 关键路径上(物理距离长,线延迟占比高),把最好的轨道资源优先给它们,等于把时序裕量花在刀刃上。这和布局阶段 全局布局时序驱动 的思路一脉相承,也和给时钟网络特殊待遇的 NDR 与时钟屏蔽规则 是同一个哲学的不同表达。
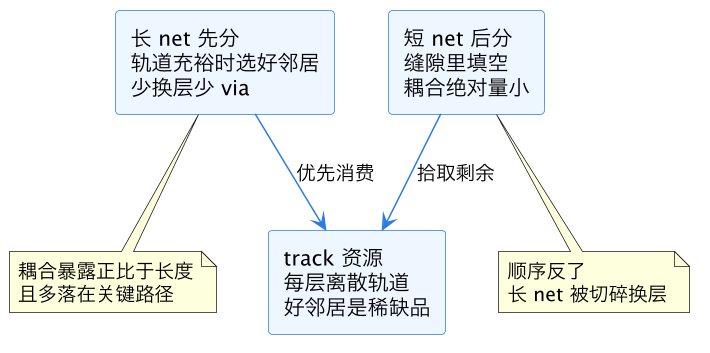
这张图概括了分配顺序的因果链:顺序不是习惯,是由「谁对邻居质量更敏感」决定的。反过来做——短 net 先占坑——的典型症状是长 net via 数暴涨、耦合暴露集中爆发,最后靠 PR 时序收敛 ECO 阶段大量换驱动、插缓冲硬救,代价远高于分配阶段的一次排序。
四、分配阶段还能做的时序友好动作
除了排序,track 分配器手里还有几张牌。其一是主动拉距:对标记为时序关键或 SI 敏感的 net,在 track 选择时偏好旁边有空轨道的位置,等效于把间距翻倍,耦合电容近似减半再减半。其二是错层:同向长距离平行的两条 net 分到不同层,用层间距离(通常大于同层最小间距等效隔离)换耦合下降。其三是预留 track:拥塞热点区域故意不放满,给详细布线和后续 ECO 留修线空间,这和布局期 布局拥塞与 cell padding 的留白逻辑同源。其四是配合 timing window:如果工具支持,分配时可以参考 时序窗口与 SI 噪声合并 的信息,让切换窗口不重叠的 net 做邻居——它们即使平行也不产生串扰增量,白捡的密度。
这些动作的共同代价是布线资源变紧,所以它们只该施加在真正关键的少数 net 上;全网一视同仁地拉距,等于人为制造拥塞,最后 DRC 和绕线反而更糟。
五、质量评估看什么
track 分配跑完,详细布线之前,值得花十分钟看四个数。一是 via 总数和每条长 net 的平均换层次数,和全局布线估计值对比,暴涨说明分配被资源挤兑了。二是关键 net 的耦合报告:耦合电容占总电容比例超过 30%-40% 的 net 有多少条、集中在哪些区域,这些将是 STA 串扰 SI 增量延迟 分析里的高危对象。三是 track 利用率分布,局部超过九成的区域是后续 DRC 事故高发区。四是关键路径沿线 net 的邻居画像——旁边是静态信号还是同窗口切换的总线。四个数都健康,详细布线基本就是走流程;任何一个亮红灯,趁早回到分配阶段调参,比详细布线后返工便宜一个数量级。
这一篇在知识体系里的位置
本篇是 eda/ 目录布线线路上的一环,向上接 全局布线拥塞分析 的 guide 产出与 数据流 S4:CTS 与布线阶段 的流程坐标,向下接 布线拥塞、DRC 与串扰 的详细布线视角和 STA 串扰 SI 增量延迟 的签核算账;横向与时序窗口(时序窗口与 SI 噪声合并)、特殊网络规则(NDR 与时钟屏蔽规则)、修复回路(PR 时序收敛 ECO)相呼应,轨道物理背景可回看 标准单元 track 高度选择。
总结
track 分配把全局布线的 guide 落成具体轨道选择,在详细布线之前就把每条 net 的邻居与平行长度——也就是耦合电容的大头——定了型;因为长 net 对 track 连续性和邻居质量最敏感、耦合暴露与长度成正比、且多压在关键路径上,主流实现一律长 net 优先,再配合拉距、错层、预留 track 和 timing window 配对等手段照顾关键少数,评估时盯住 via 数、耦合占比、track 利用率和关键路径邻居画像四个指标,就能在进入详细布线前把时序风险拦在 cheapest 的修复点。