FPGA 原型验证专题 31:速率适配器(Speed Adapter)原理——解决原型慢速与真实接口高速的根本矛盾
更新时间:2026-09-13。本文是原型外围姊妹系列第六篇,也是模块 C(真实接口与外设接入)的总纲。27 在电路仿真 ICE 与协同加速模式 接线/时钟纪律反复强调:ICE 能不能成立,取决于关键接口有没有合格的速率适配。本篇把"速率适配"这个在 02 多 FPGA 原型系统 ASIC 分区/TDM和 03 原型平台 bring-up 多片点亮/trace里只被一句话带过的概念,展开成一套可指导后续 DDR/PCIe/外设/IO 各篇的系统原理。
这一篇在体系里的位置
06 原型验证系统全景与文档地图给过一个刺眼的数字:FPGA 原型等效速度 1~30 MHz,受多片 TDM 拖累时更低。而芯片要连的真实世界是:DDR4/5 数 Gbps 每引脚、PCIe Gen3/4/5 每通道 8~32 GT/s、以太网 10/25/100G、MIPI/USB/SerDes 数百 MHz~十几 GHz。两者差两到四个数量级。
ICE 的全部价值在于"真实对端不分辨原型和真芯片",可如果原型根本跟不上真实对端的物理速率,链路在训练阶段就起不来,ICE 无从谈起。**速率适配器(speed adapter)**就是架在"慢速、被 TDM 拉长的原型域"与"全速率、物理时间真实的器件域"之间的转换层。后续 73(DDR)、74(PCIe/SerDes)、75(Ethernet/USB/MIPI 子卡)、76(IO 引出/引脚)都是这一原理在具体接口上的实例。
本文要回答的问题
- 为什么不能让真实器件也降速,或者干脆直连试试?物理层协议在哪些地方锁死了速率?
- 速率适配的两种根本范式——FPGA 内协议重建 vs 专用降速桥/子卡——各自结构、优劣、适用接口是什么?
- 跨速率边界的时钟域怎么划?弹性 FIFO(elastic FIFO)深度、时序预算、反压怎么设计?
- 适配层引入的额外延迟和缓冲,会让哪些保真度结论失效?哪些测试不能在带适配的链路上做?
- 给一个新接口设计速率适配,决策流程和验收测试是什么?
一、根本矛盾:慢原型 vs 全速率物理世界
先明确"慢"在哪里、"快"在哪里,才知道要适配什么。
- 原型域(DUT 侧):用户设计的数字逻辑跑在降频系统时钟上,跨片信号还被 TDM 时分复用,一次事务的发起/响应延迟被拉长且可能不均匀。它慢,但它是"我们要验证的设计"。
- 器件域(PHY/对端侧):真实 DDR、PCIe endpoint、以太网 PHY、显示面板按自己的物理时钟和物理时间工作。SerDes 锁相环、链路训练状态机、DDR 的刷新与定时参数、USB 的 SOF 间隔、对端设备的超时,全部以真实速率、真实时间运行,不接受你"请慢一点"。
直连为什么必然失败,分三种情形:
- 物理层就起不来:SerDes 收发器必须在标称线速上完成 CDR(时钟数据恢复)、均衡、链路训练(PCIe LTSSM、以太网 autoneg)。原型给不出这么高速率的参考时钟/并行数据,PHY 锁不住、训练超时、链路 down。
- 定时参数对不上:DDR 协议的 tRCD/tRAS/tREFI 是绝对物理时间。控制器在慢时钟下按比例发出的刷新间隔,换算成真实时间远超 DRAM 允许的最大刷新间隔→数据丢失;或者读训练窗口在慢时钟下根本对不准。
- 对端超时/实时性失败:对端有固定超时(USB 事务、显示面板的扫描定时、PCIe ack 超时)。原型响应慢于对端超时,对端直接报错/掉线/花屏。
关键结论:速率不是一个可以两端商量的参数。物理层和很多协议定时器把速率锁死在标称值,所以适配只能在"速率/时间"这一维上做转换,而不能指望真实世界迁就原型。
二、两种根本范式
2.1 范式一:FPGA 内协议重建(protocol rebuild / BFM on adapter clock)
思路:不让 DUT 直接面对真实高速 PHY。在 FPGA 内放一个工作在适配时钟域的协议主控/外设模型(本质是一个时钟更快、时序确定的 BFM/控制器),它以 DUT 能承受的慢速事务接口(经异步 FIFO)和 DUT 交互,在另一侧按真实/可接受速率实现完整协议,再接到物理引脚或一个真实器件。
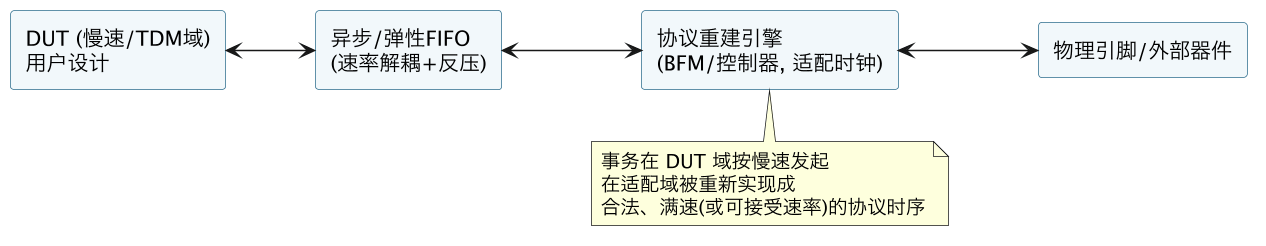
特点:
- DUT 看到的是一个"反应稍慢但协议合法"的对端;重建引擎把慢事务重新定时成合规波形。
- 对纯数字、时序余量可由缓冲吸收的接口很有效:低速 UART/SPI/I2C、很多并行总线、经事务处理器建模的接口(与 26 事务处理器 SCE-MI 三类通道/transactor 实现同构,区别在于这里另一侧接的是真实引脚/器件而非主机)。
- 对高速 SerDes 类,重建引擎自身仍需达到物理线速,通常要借助 FPGA 内的硬核 SerDes/收发器(见范式二的混合),纯软逻辑重建不到数十 Gbps。
- 保真度限制:重建的是"协议行为",不是"真实 PHY 的电气/抖动/均衡"。功能、软件、协议栈可以这样验;PHY 电气、眼图、BER 不能。
2.2 范式二:专用降速桥接芯片 / 速率适配子卡(speed-bridge chip / daughter card)
思路:用一块专门的协议感知(protocol-aware)桥接芯片或速率适配子卡做两侧的"时间单位换算器"。靠 DUT 一侧运行在原型慢速时钟、按原型时序收发;靠器件一侧用真实 PHY 跑满真实速率与真实端点通信;中间用大容量异步/弹性缓冲把两侧彻底解耦,由桥芯片把"慢侧的一帧/一笔"缓冲后在"快侧"以正确速率重放,反之亦然。商用原型平台的 PCIe/以太网/USB/MIPI/DDR 速率适配子卡基本都是这一形态。
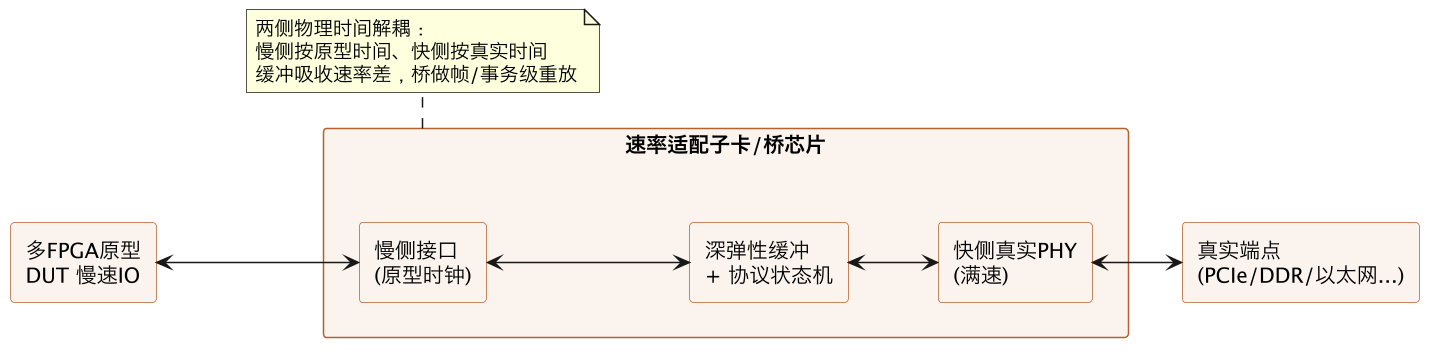
特点:
- 真实 PHY 在子卡上跑满速,所以链路训练、枚举、真实对端行为都能成立——这是能接真实 PCIe endpoint/真实以太网/真实显示的唯一现实途径。
- 桥芯片协议感知:它理解帧/包/事务边界,能正确处理流控、CRC、重传、乱序,而不只是字节 FIFO。
- 代价:成本高、每种接口/速率档往往要专用子卡;引入可观且可变的延迟;带宽受桥缓冲和慢侧消耗能力限制;对"端到端时延敏感"的测试不透明。
- 保真度:数据通路功能、协议互通、软件/驱动可在真实端点上验证;但端到端延迟、线速吞吐、实时确定性被适配层改写,不能据此给芯片性能下结论(性能口径见后续 E3 篇)。
2.3 两种范式与"直接用替换 IP"的区别
注意还有第三种常被混淆的做法:直接把 ASIC 的 DDR/SerDes PHY 替换成 FPGA 硬核 + 替换控制器 IP(11 ASIC→FPGA 等价单元替换 SRAM/时钟/IO/PHY),跑在能满足该硬核的频率上,但 DUT 逻辑仍降频。这通常需要在替换 IP 与降频 DUT 之间做异步桥,本质上退化成范式一/二的一种;如果整个系统都能被强行提到硬核要求的频率(往往不现实,TDM 不允许),才不需要额外适配。理解这点,就不会误以为"换了硬核就能直连真 DDR"。
三、时钟域、弹性 FIFO 与时序预算
速率适配的核心数据结构是弹性 FIFO(elastic FIFO)/ 双时钟异步 FIFO:两侧不同时钟、不同速率,靠缓冲吸收速率差。它和普通 CDC FIFO 的区别在于"弹性"——它不仅跨时钟域,还要吸收持续的速率不匹配(不只是相位差),因此深度设计是关键。
**1) 水位与深度估算。**考虑 DUT→器件方向:DUT 慢、器件快且可能突发。FIFO 必须容纳"慢侧最长一次连续供给间隔内,快侧已经取走/还需要的数据"。工程估算:
- 快侧突发写入(如一次 PCIe TLP/一帧视频)可能瞬间灌满,深度 ≥ 最大突发长度;
- 慢侧停顿时(跨片 TDM 调度、被其它路径占用互连)快侧仍在按真实速率收发,深度要覆盖"慢侧最坏停供时间 × 快侧数据率",并留 2 倍以上裕量;
- 对连续等时流(显示、音频、实时视频)不能靠无限缓冲——缓冲只改变延迟不改变平均速率,若慢侧平均供给率长期低于快侧消耗率,必然 underrun(花屏/断流)。这类接口的根本前提是 DUT 经降频后的平均吞吐仍要跟得上等时流的最低要求,否则只能降分辨率/帧率或换更高频的分区。
**2) 反压如何跨边界传播。**快侧器件不能无限接收时(credit 不足、对端反压),反压要传到慢侧让 DUT 停发。问题是慢侧响应一个反压要好几个被拉长的周期,期间快侧已经又产生/要求了一批数据——靠 FIFO 吸收这段"反压飞行时间"。设计上 FIFO 高水位要提前触发反压(类似 AXI 的 almost-full),预留管线排空空间。对不支持反压的等时/实时协议,不能用"卡住快侧"的办法(会直接违例),只能靠缓冲+保证平均带宽,或丢弃+上层重传(需协议允许)。
**3) 时钟域划分纪律。**典型至少三个域:DUT 系统时钟域(慢、可能多片多个)、适配/桥时钟域(确定、独立)、真实 PHY 时钟域(全速率、可能含恢复时钟)。所有跨域走异步 FIFO 或标准 CDC 同步器,绝不能让慢域组合逻辑直接进快域 PHY 接口。参考时钟(refclk)质量直接决定 SerDes 能否训练成功,要给适配子卡干净、频率正确的参考源。
**4) 复位与训练顺序。**快侧 PHY 必须先完成自身锁定/训练,再允许慢侧流量进入;复位释放要让 FIFO 先处于确定空状态。顺序错误会出现"偶发前几帧损坏"。
四、延迟、带宽与保真度边界:适配层改写了什么
速率适配让接口"能用",但它在 DUT 和真实世界之间插入了一段不可忽略且可能可变的缓冲。必须显式记录哪些被测特性因此失真:
| 指标 | 带速率适配后是否可信 | 说明 |
|---|---|---|
| 功能/协议互通/枚举 | ✅ 可信 | 真实对端、真实帧交换、真实错误恢复 |
| 软件/驱动/OS | ✅ 可信(需放宽超时) | 真实交互顺序,仅变慢 |
| 数据完整性(CRC/重传) | ✅ 多数可信 | 真实链路层行为 |
| 端到端延迟 | ❌ 被显著放大 | 缓冲+重放增加且抖动 |
| 线速吞吐/带宽 | ⚠️ 受慢侧与桥限制 | 测到的是"原型+适配"系统带宽,非芯片 |
| 实时/等时确定性 | ❌/⚠️ | 抖动可能破坏显示/音频/定时 |
| PHY 电气/眼图/BER | ❌ 不可信 | 适配子卡 PHY ≠ 目标工艺 PHY |
| 超时/重传边界行为 | ⚠️ 谨慎 | 延迟变大可能触发真芯片不会有的超时 |
两条使用纪律:
- **在带适配的链路上做"功能与软件"结论,不做"时序/绝对性能/PHY"结论。**架构性能测量要在能扣除适配延迟的条件下做(用周期计数、在 DUT 内部测点测,而非测端到端墙钟;方法见后续 E3 篇)。
- 延迟敏感用例会被适配层"人造地"拖慢,可能触发软件超时、甚至改变竞态结果。要么放宽原型超时参数,要么对这类用例改用事务级建模/加速模式(27 在电路仿真 ICE 与协同加速模式 接线/时钟纪律),并在验证计划里标注"该结论不代表芯片时序"。
五、为新接口设计速率适配:决策流程
遇到一个还没有适配方案的接口,按下面顺序决策:
- **它是不是物理速率锁死的接口?**低速 UART/SPI/I2C/GPIO 这类对端能接受宽范围速率的,多数不需要专门适配,直接引出或经电平转换即可(76 篇)。SerDes/DDR/高速串行/等时显示类才需要重型适配。
- **DUT 降频后的平均吞吐够不够?**算清慢侧平均数据率 vs 接口最低实时要求。不够则先在分区/频率上解决(把该接口控制器放同片、提高该域频率),否则任何缓冲都救不了等时流。
- 选范式:只需要协议行为、无真实全速率对端要求 → FPGA 内协议重建(范式一,便宜灵活);必须接真实全速率端点/完成真实训练 → 协议感知降速桥/商用子卡(范式二)。
- 估缓冲与水位:最大突发、慢侧最坏停供时间(含 TDM 跨片停顿)、反压飞行时间,取三者包络并留 2× 裕量;等时流额外验证平均带宽与 underrun。
- 划时钟域与 refclk:慢/适配/快三域隔离,给子卡干净参考时钟,定复位与训练先后。
- 定保真度清单:写明该适配链能/不能回答哪些指标,超时参数怎么放宽,性能数据在哪里测才能绕开适配延迟。
- 验收测试:①快侧链路训练/枚举稳定(反复复位/上下电);②满突发不溢出、长稳不 underrun;③注入反压/断流看慢侧行为与恢复;④用真实仪表/对端做独立见证;⑤测适配延迟与抖动并记录,供性能数据校正;⑥版本纳入 manifest(20 比特流烧录与四方版本一致 manifest/门禁)。
八、速率适配子系统的验收测试:怎么证明它"真的等价"
装上适配器不等于它正确——适配器本身是一段复杂逻辑/固件,且它的 bug 会被当成 DUT 的问题上报,浪费两端时间。接入真实接口前,建议按下面四级对子系统做独立验收(不依赖 DUT 正常工作):
**1) 电气/链路层自检。**先不接 DUT 逻辑,用子卡自带的 BIST/环回:PHY 环回(电口 near-end/far-end loopback)、SerDes PRBS、训练/均衡状态寄存器读全绿;示波器/眼图确认电平与时钟(与 33 PCIe/SerDes 上原型 硬核/降速子卡/LTSSM的 LTSSM 检查同法)。这一级排除"卡本身坏了/引脚接错/时钟没给"。
**2) 协议层合规自检。**用独立的总线分析仪/协议 VIP 或主机端标准工具,验证适配器在不挂 DUT 时的协议行为:PCIe 能被主机枚举成正确配置空间、DDR 能跑厂商训练+内存测试、以太网能 link 并响应 ARP/ping、USB 能枚举测试设备。这一级证明"对真实世界呈现的协议面是对的"。
**3) 数据完整性压测。**用一个简单的 DUT 替身(小型 RTL traffic generator),跑各类模式——固定码型、伪随机、地址/数据边界、背靠背突发、随机反压与断流,对比两侧事务日志逐事务/逐字节比对,统计长时间运行(小时级)的误码、溢出、丢事务。重点制造两侧速度极端不匹配(DUT 侧刻意停-走、全速突发交替),专打弹性 FIFO 的上下界。
**4) 背靠背时钟扰动与复位恢复。**热插拔、复位、时钟重新锁定、中途改频、突然断对端再恢复,验证两侧都能干净恢复且不残留脏事务——74 篇强调的 LTSSM 恢复、75 篇等时流的恢复都属此列。
验收产物要固化。每种子卡/适配器的这套四级测试应脚本化并在每次适配器固件升级、比特流大版本、子卡更换后重跑,结果连同子卡序列号、固件版本进 manifest(20 比特流烧录与四方版本一致 manifest/门禁)。一个实用纪律:bring-up 遇到接口怪相时,先花 10 分钟重跑适配器自检再怀疑 DUT——经验上相当比例的"接口 bug"最后定位到适配器配置/版本错配。
**保真度声明随验收给出。**验收通过后,明确写出该子系统可以代表什么(功能序列、寄存器语义、带宽下限)、不能代表什么(真实延迟分布、电气余量、极端温度/电压行为),贴在平台状态页上,让软件和验证团队在报告性能/异常时有据可依,不把适配层行为误记到芯片账上。
与系列及现有篇目的链接
- 两种上板模式(本篇是 ICE 的使能条件):27 在电路仿真 ICE 与协同加速模式 接线/时钟纪律
- 事务处理器(协议重建的同构机制):26 事务处理器 SCE-MI 三类通道/transactor 实现
- 单元替换(替换硬核/IP):11 ASIC→FPGA 等价单元替换 SRAM/时钟/IO/PHY
- 接口实例:73 DDR/存储、74 PCIe/SerDes、75 外设接口与子卡、76 IO 引出与引脚
- 降频与跨片停供来源:19 原型频率与时序收敛 TDM 降频/关键路径、13 跨 FPGA 互联与 TDM SerDes/跨片同步/降频
- 平台/存储映射背景:02 多 FPGA 原型系统 ASIC 分区/TDM、03 原型平台 bring-up 多片点亮/trace
总结
一句话总结:速率适配是让"1~30 MHz、还被 TDM 不均匀拉长的原型"能够对接"数百 MHz~数十 Gbps、物理时间锁死的真实接口"的使能层,根因在于物理层(CDR/链路训练)、DDR 绝对定时参数和对端超时把速率锁在标称值,既不能让真实器件降速、也不能直连硬试;可行路线只有两种——在 FPGA 内用工作于适配时钟的协议重建 BFM 把慢事务重新定时成合规协议(便宜灵活、能验功能与软件但到不了全速 PHY、也不能回答电气问题),或用协议感知的专用降速桥/速率适配子卡让快侧真实 PHY 满速训练、慢侧按原型时间收发、中间靠深弹性 FIFO 在帧/事务级解耦重放(能接真实 PCIe/以太网/显示端点,但成本高、引入可变延迟);适配的工程核心是三时钟域(慢 DUT 域/适配域/满速 PHY 域)严格隔离、异步弹性 FIFO 按"最大突发+慢侧最坏停供(含跨片 TDM)+反压飞行时间"三者包络取深并留 2 倍裕量、用 almost-full 提前反压,而对等时连续流必须先保证降频后的平均吞吐本就跟得上,缓冲只能改延迟改不了平均速率;最关键的认知纪律是适配层改写了时间——功能、协议互通、软件驱动、数据完整性在真实对端上可信,但端到端延迟被放大且抖动、线速吞吐测的是"原型+适配"而非芯片、PHY 眼图/BER 完全不可信,所以性能要在 DUT 内部用周期计数测点测、并在验证计划里显式列出每条适配链的保真度边界与放宽的超时参数;为新接口做适配时按"是否速率锁死→平均吞吐够不够→选重建还是桥→算缓冲水位→划时钟域/refclk→定保真清单→做训练稳定/满突发/反压/长稳/延迟标定六项验收"的流程推进,这正是后面 DDR、PCIe、外设子卡、IO 引出四篇共同遵循的母版。