UVM driver sequence item:seq_item_port 握手、item_done 与 put_response 响应回路全解
更新时间:2026-09-28。在 sequence 与 driver/scoreboard 协作 里,激励从 sequence 出发、经 sequencer 仲裁、由 driver 拍成信号,这条链路上最容易写错的一段恰恰是 driver 与 sequencer 之间的两口之家:
get_next_item和item_done。这一篇专门拆开 UVM driver sequence item 的取件与回执机制:seq_item_port 怎么连、握手为什么必须成对、响应怎么沿 put_response 回路送回 sequence,以及流水线化场景下item_done提前调用的边界。
本文要回答的问题
- driver 和 sequencer 之间靠哪个端口通信,connect 的方向和参数化类型有什么讲究?
get_next_item和item_done为什么必须严格成对,多调一次或少调一次会发生什么?- sequence 的
get_response收不到响应,问题一般出在响应回路的哪一环? - 总线有 outstanding 能力时,driver 怎样在上一笔没打完时就取下一笔?
try_next_item、item_done(rsp)、rsp 队列深度这些细节各自解决什么问题?
一、seq_item_port:driver 向 sequencer 要活的唯一入口
driver 不生产事务,它是事务的消费者与信号的执行者。事务躺在 sequencer 的仲裁队列里,driver 想要一笔新活,只能通过基类 uvm_driver 自带的 seq_item_port 去取。这个端口在 uvm_driver #(REQ, RSP) 声明时就已经备好,driver 作者不需要也不应该自己再声明一个。
接线在 agent 的 connect_phase 里完成,方向固定为 driver 侧发起:
class my_agent extends uvm_agent;
  my_driver    drv;
  my_sequencer sqr;
  function void connect_phase(uvm_phase phase);
    drv.seq_item_port.connect(sqr.seq_item_export);
  endfunction
endclass类型匹配是这条连接的生死线。uvm_driver #(REQ, RSP) 与 uvm_sequencer #(REQ, RSP) 的参数化必须一致,sequence 里 uvm_sequence #(txn_t) 送出的事务类型也要对得上 REQ。对不上的话 elaboration 阶段就报 connect 失败,属于「疼在前面」的好错误。常见的隐蔽写法是 driver 参数化只写了一个类型 uvm_driver #(txn_t),此时 RSP 默认等于 REQ,如果后面要用响应回路又不想共用类型,就得显式写两个参数。
和 monitor 侧的 analysis_port 不同(参见 SystemVerilog TLM 通信),seq_item_port 是阻塞拉取语义:driver 主动 get,sequencer 被动给。这也决定了激励通路的节奏由 driver 控制——driver 取得快,sequence 发得就快;driver 卡在信号时序里不取件,sequence 的 finish_item 就会挂在那里等仲裁。整个激励链路的反压天然成立,不需要额外 fifo。
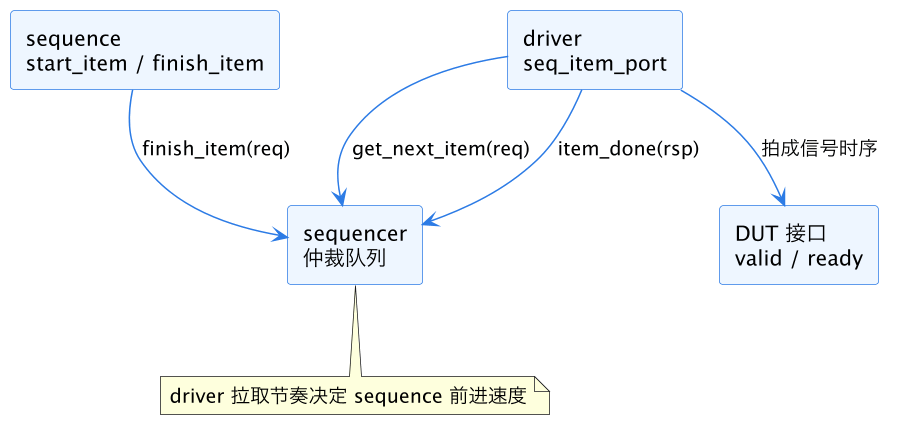
上图把四方关系摆在一起:sequence 只和 sequencer 对话,driver 也只和 sequencer 对话,两者之间没有直连。这种「sequence 与 driver 互不知晓」的设计正是激励层和驱动层能各自独立替换的原因——换一个协议 driver,sequence 一行不动。
二、get_next_item / item_done:一次取件必须配一次回执
driver 的 run_phase 骨架几乎是定律:
task run_phase(uvm_phase phase);
  txn_t req;
  forever begin
    seq_item_port.get_next_item(req);  // 阻塞等一笔事务
    drive_one(req);                    // 拍信号,耗时若干拍
    seq_item_port.item_done();         // 回执:这笔做完了
  end
endtask
get_next_item 是阻塞 task:sequencer 队列里没货时,driver 线程挂起,直到某个 sequence 的 finish_item 把事务递进来并通过仲裁。sequencer 内部维护一个「当前已发出但未回执」的状态,item_done 就是清这个状态。sequencer 收到 item_done 之前,同一个 sequence 的下一个 finish_item 不会被放行——这是 UVM 默认的单笔锁步(lock-step)语义:一笔在途,做完才给下一笔。
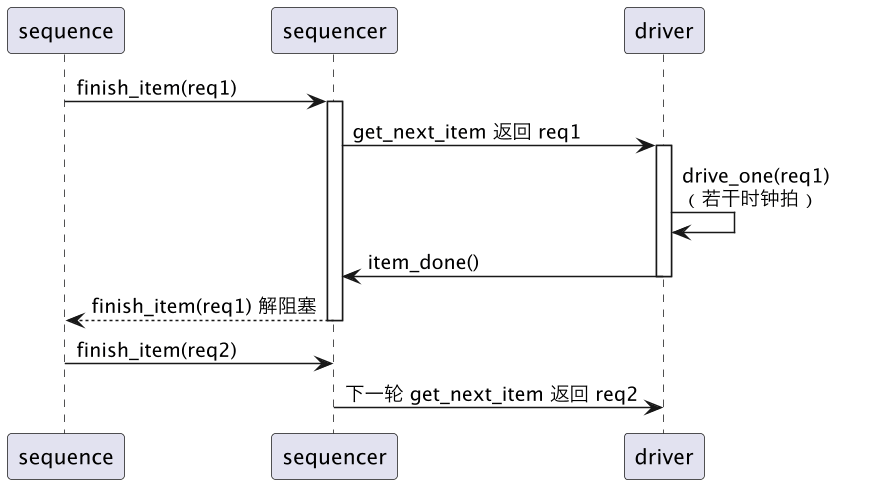
时序图里最关键的是 finish_item 的返回点:它不在事务递给 driver 时返回,而在 driver 调 item_done 之后才解阻塞。所以 sequence 侧的 start_item/finish_item 体感是「我把事务交出去并且它被执行完了」。理解这一点,很多「为什么 sequence 卡住」的疑问就自动消失了——顺着链路看,一定是 driver 的 item_done 没到。
漏调 item_done 是最经典的 driver bug:第一次循环正常,第二次 get_next_item 时 sequencer 发现上一笔还没回执,直接报 get_next_item called twice without item_done 一类的 fatal 或 UVM_ERROR。反过来,多调一次 item_done 也会被 sequencer 抓出来。成对纪律没有例外,连错误处理路径也不例外——drive_one 里发现总线异常想丢弃这笔事务,仍然要调 item_done 再 continue,否则下一笔永远等不到。
三、响应回路:item_done(rsp) 与 put_response
很多协议需要 driver 把执行结果反馈给 sequence:读操作要回数据,写操作要回状态码,寄存器模型要回访问结果。UVM 给了两条返回路径,语义不同,别混用。
第一条是 item_done(rsp):回执和响应一次完成。rsp 对象会先被 clone 进 sequencer 的响应队列,同时标记当前事务完成。sequence 侧对应 get_response(rsp),阻塞等响应入队。
第二条是 seq_item_port.put_response(rsp):只送响应,不回执。它用在「响应到达的时刻和事务做完的时刻不一致」的场景,比如 split transaction——driver 早早 item_done 放行下一笔,几个拍之后总线上才回来读数据,这时再 put_response 把结果补送回去。
task run_phase(uvm_phase phase);
  txn_t req, rsp;
  forever begin
    seq_item_port.get_next_item(req);
    if (req.op == READ) begin
      drive_read(req, rsp);
      seq_item_port.item_done(rsp);   // 回执 + 响应
    end else begin
      drive_write(req);
      seq_item_port.item_done();      // 只回执
    end
  end
endtask
sequence 侧的配合有个铁律:每发出一笔会带响应的请求,就必须有一次对应的 get_response。响应进了 sequencer 的响应队列而没人取,队列涨到默认深度 8 就会报 Response queue overflow,再往后响应被直接丢弃——用例看起来还在跑,但读回来的数据已经错位了。对应的防护是 uvm_sequence::set_response_queue_depth() 调深,或者干脆把 response_queue_error_report_disabled 打开换成自己兜底,不过更常见的修法是让 sequence 的结构保证发出与收取成对,比如用 fork...join 起一个专门的响应收取线程。
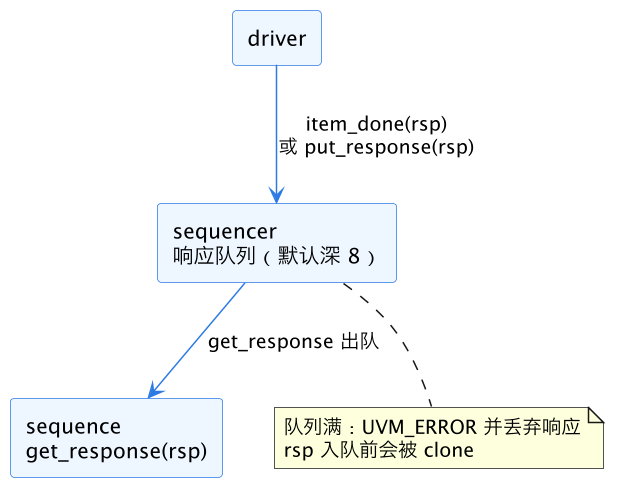
注意图里的 clone 细节:driver 把 rsp 句柄交给 item_done(rsp) 后,sequencer 存的是副本,driver 下一轮复用同一个 rsp 对象不会污染已入队的响应。但 put_response 走的是 TLM put 语义,同样由 sequencer 内部 clone,所以两条路在对象所有权上都是安全的,driver 侧不需要自己 clone。
rsp 对象的准备也有约定俗成的写法:用 $cast(rsp, req.clone()) 从请求派生响应,自动带上 transaction_id 和 sequence_id。sequencer 靠这两个 id 把响应路由回正确的 sequence(多 sequence 并发时尤其关键),手工 new 一个 rsp 而漏掉 set_id_info(req),响应就会送错人家或直接报错。寄存器模型的 frontdoor 访问正是走这条路,细节可对照 UVM 寄存器模型集成。
把完整回路按对象生命周期再过一遍,很多模糊点就清楚了。sequence 在 start_item 里等仲裁授权,finish_item 把 req 交给 sequencer 并挂起;driver 的 get_next_item 取走 req,seq_item_export 内部记下「在途一笔」;driver 执行完调 item_done(rsp),sequencer 做两件事:清在途标记让 finish_item 解阻塞,把 rsp clone 一份压入响应队列;sequence 从 finish_item 返回后调 get_response(rsp),按 id 从响应队列取回属于自己的那份。整条回路里 req 和 rsp 各自独立存活,sequence 拿到 rsp 时 req 可能早已被 driver 复用或丢弃,所以协议要求「响应必须自包含」——rsp 里该带的地址、id、状态字段一个不能省,指望回 req 里翻数据是结构性错误。
还有一种进阶用法:一个 sequence 发出多笔请求、按任意顺序收响应。这时不要顺序 get_response,而是起两个并发进程,一个连续 start_item/finish_item,另一个循环 get_response,靠 rsp 里的 id 把响应与请求配对。virtual sequence 调度多个子 sequence 并发时也遵循同样的成对账:每个子 sequence 各自管理自己的响应队列份额,互不侵占。
四、流水线化:item_done 提前返回与 try_next_item
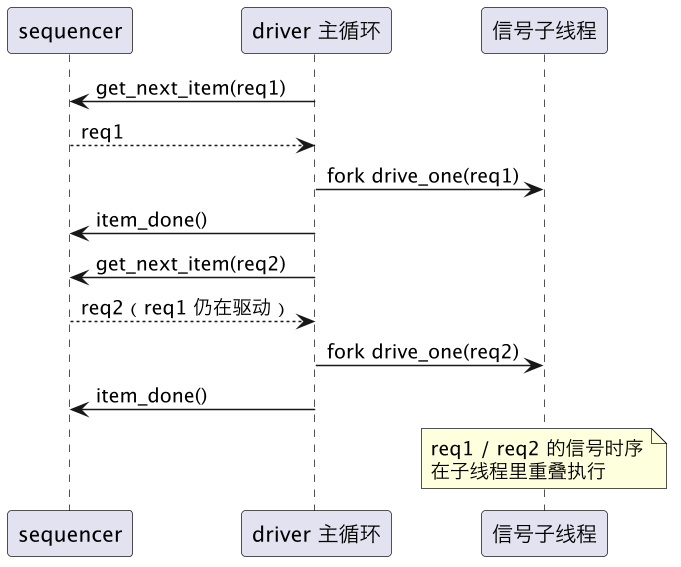
锁步语义对 APB 这种单发单收的协议刚刚好,但 AXI、PCIe 这类支持 outstanding 的总线,要求 driver 在上一笔还没打完时就能取下一笔,否则带宽喂不满。UVM 的解法是允许 item_done 在 drive_one 完成之前调用:
task run_phase(uvm_phase phase);
  txn_t req;
  forever begin
    seq_item_port.get_next_item(req);
    fork
      drive_one(req);          // 后台慢慢打
    join_none
    seq_item_port.item_done(); // 立刻放行下一笔
  end
endtask
item_done 一调,sequencer 立即解锁,下一个 finish_item 放行,driver 的下一轮 get_next_item 拿到新事务,而旧事务的信号时序还在 fork 出去的线程里跑着。这样驱动线程变成了纯粹的「取件-派发」循环,拍信号交给动态产生的子线程,outstanding 深度由 fork 出去的线程数自然决定。
这个写法的代价要自己掂量。其一,req 句柄被多个子线程共享前必须确认每个线程拿到的是独立对象——get_next_item 每次返回的是新事务,所以上面写法安全,但如果中间有缓存复用就要小心。其二,异常处理变难:子线程里总线报错时,主循环可能已经取了后面好几笔,想精确停在某一笔要靠额外的同步原语,比如 event、semaphore 与 mailbox 里的机制。其三,phase 结束时这些 join_none 的线程还可能在跑,driver 需要在 shutdown_phase 或用 objection 管住它们,否则最后一笔事务打到一半仿真就结束了,这类问题可结合 UVM phase 与 objection 的收尾纪律一起处理。
工程上更稳妥的 overlap 写法是给并发度加一个显式上限:driver 内部维护一个计数 semaphore,容量等于协议允许的最大 outstanding 数,每次 fork 前 get、子线程结束时 put。这样既保留流水线吞吐,又避免子线程在极端用例下无界膨胀把仿真内存吃光,出问题时的现场也可控——计数器打满就是反压信号,说明下游比预期慢,直接暴露性能假设的错误。带响应的流水线里,子线程在信号回来时调 put_response(rsp),主循环照旧只负责取件与立即回执,两条职责泾渭分明,响应乱序返回也由 sequencer 按 id 归位,driver 不需要自己排序。
与流水线相对照的还有一个冷门端口方法 try_next_item:非阻塞取件,队列空时立即返回 null 而不是挂起。它和 get_next_item 的差异不只在「等不等」,还在调度语义上——get_next_item 是 task,内部会停在 sequencer 的等待事件上,sequence 的 finish_item 一到立刻被唤醒,激励间隙为零;try_next_item 是 function 风格的一次性探测,返回 null 后 driver 要自己决定下一步,两次探测之间至少隔一个时间步,激励之间天然带缝。
它适合「有活就干、没活干干别的」的 driver。典型场景有三个:一是周期性心跳或保活包,主激励没来时发 idle 帧维持链路;二是多路复用驱动,一个 driver 轮询两个 sequencer(比如控制面与数据面共用一个物理口),哪边有货发哪边;三是后台流量发生器,主用例跑定向激励时它负责填充随机噪声流量。写法骨架如下:
task run_phase(uvm_phase phase);
  txn_t req;
  forever begin
    seq_item_port.try_next_item(req);
    if (req != null) begin
      drive_one(req);
      seq_item_port.item_done();   // 取到就必须回执
    end else begin
      send_idle_frame();           // 没货,干副业
      @(posedge vif.clk);
    end
  end
endtask
用 try_next_item 取到 null 时不要调 item_done,成对规则只对成功取件成立;取到事务后同样必须 item_done,纪律与阻塞版本完全一致。轮询写法还有一个隐藏成本:try_next_item 返回 null 的循环如果不插任何延时,会在同一个时间步里空转,把仿真事件调度器刷爆——上面骨架里的 @(posedge vif.clk) 不是装饰,是必备的节奏阀。需要「没货时真正等货」的语义就老实回 get_next_item,非阻塞轮询只服务「没货时有别的事可干」的场景。
| 场景 | 取件方式 | item_done 时机 | 响应路径 |
|---|---|---|---|
| 锁步单发(APB 风格) | get_next_item | 驱动完成后 | 不需要或 item_done(rsp) |
| 读写混合需回数据 | get_next_item | 驱动完成后 | item_done(rsp) |
| outstanding 流水线 | get_next_item | 派发给子线程后立即 | put_response 补送 |
| 心跳/后台流量 | try_next_item | 取到才调 | 视协议而定 |
五、完整实例:一个带响应的读写 driver
把三节内容合起来,一个能在真实项目里用的 driver 长这样:
class my_driver extends uvm_driver #(txn_t, txn_t);
  `uvm_component_utils(my_driver)
  virtual bus_if vif;

  task run_phase(uvm_phase phase);
    txn_t req, rsp;
    forever begin
      seq_item_port.get_next_item(req);
      if (req.op == READ) begin
        do_read(req);
        rsp = txn_t::type_id::create("rsp");
        rsp.set_id_info(req);        // 带上路由 id
        rsp.data = vif.rdata;
        rsp.ok   = (vif.slverr == 0);
        seq_item_port.item_done(rsp);
      end else begin
        do_write(req);
        seq_item_port.item_done();
      end
    end
  endtask
endclass
sequence 侧:
task body();
  txn_t req, rsp;
  req = txn_t::type_id::create("req");
  start_item(req);
  req.randomize() with { op == READ; };
  finish_item(req);          // 此刻事务已被 driver 执行完
  get_response(rsp);         // 取回读数据
  `uvm_info("SEQ", $sformatf("rdata=%0h ok=%0b", rsp.data, rsp.ok), UVM_LOW)
endtask这套代码里每个调用都能在前面找到出处:set_id_info 保证响应路由,finish_item 的返回点由 driver 的 item_done 决定,get_response 与带 rsp 的回执成对。如果换成 AXI 风格环境(参考 AXI UVM 环境搭建),只需把 driver 换成流水线版,sequence 侧代码原封不动——这正是这套握手协议的价值。
调试这类通路时有两个顺手的观测点:sequencer 自带事务记录,打开 uvm_sequencer 的 enable_print_topology 或在仿真里看 seq_item_export 上的活动,能直接看到取件/回执的配对是否整齐;响应队列深度可以用 rsp_queue.size() 在 sequence 里断言,任何时刻大于预期 outstanding 数就说明收取线程漏了。
六、常见坑
| 坑 | 现象 | 处理 |
|---|---|---|
忘记 item_done | 第二笔事务报 fatal 或 sequence 永久挂起 | 所有路径(含异常分支)都回执 |
get_response 漏调 | 响应队列溢出丢响应,读数据错位但不报错 | 发出/收取成对,或起专职收取线程 |
rsp 漏 set_id_info(req) | 多 sequence 并发时响应送错对象 | rsp 一律从 req 派生 id |
| 流水线子线程无人收尸 | phase 结束时事务打一半,scoreboard 漏最后一笔 | shutdown_phase 或 objection 管住 |
| 绕过 seq_item_port 直连 sequencer | agent 复用时连接关系全乱 | 只用基类端口,不自建旁路 |
| 锁步下指望 driver 并行执行 | sequence 体感卡死 | 认清 finish_item 的返回点在 item_done |
item_done(rsp) 后继续改 rsp | 偶发响应数据被污染 | 送出去就不碰,要改先 clone |
try_next_item 空转无延时 | 仿真在同一时间步刷爆事件调度器 | null 分支必须插时钟等待 |
| 复位期间照取照打 | reset 期间事务残留进下一段激励 | driver 监听 reset,丢弃在途件并照常 item_done |
最后一条值得展开:DUT 复位打断在途事务时,driver 不能一走了之。正确姿势是检测到 reset 后中止当前 drive_one,对被中断的那笔照样调 item_done(可选择附带一个错误标记的 rsp),让 sequence 的 finish_item 正常返回,由 sequence 或 test 层决定重发还是放弃。sequence 侧对应的做法是在 body 里捕获复位事件、清空待发队列,这与 复位初始化验证 里的激励分段思路一致。
跨项目复用 driver 时还有一个句柄传递的暗坑。有人为了让 test 层「临时干预」激励节奏,把 driver 的句柄经 config_db 传到 sequence 里,直接拨弄 driver 内部的队列或标志位。这等于在标准握手协议旁边开了一条私有旁路:取件与回执的账本仍记在 sequencer 里,旁路改动的状态 driver 自己并不知道,两本账一对不上,表现就是偶发的挂死或重复驱动,且只在特定激励密度下复现。正确做法是任何节奏干预都走协议内通道——要么用 sequence 控制发出速度,要么用带优先级的多 sequence 让 sequencer 仲裁,driver 只面对 seq_item_port 一个入口。复用评审时值得专门问一句:这个 driver 除了 seq_item_port 之外,还有没有别的手能伸进来?答案必须是没有。
这一篇在知识体系里的位置
- 向上承接:UVM 组件与 phase 给出 driver/sequencer 的组件骨架,本篇解释两者之间的事务取送协议。
- 横向相关:sequence 与 driver/scoreboard 协作 从 sequence 视角看激励链,本篇从 driver 视角把握手讲透。
- 机制基础:SystemVerilog TLM 通信 的阻塞 get/put 语义正是 seq_item_port 与响应回路的底座。
- 落地延伸:AXI UVM 环境搭建 展示 outstanding 总线下的流水线 driver 实际形态。
总结
UVM driver sequence item 通路围绕一条铁律运转:get_next_item 取件必须配 item_done 回执,回执到达前 sequence 的 finish_item 不返回;响应经 item_done(rsp) 或 put_response 走 sequencer 响应队列送回,sequence 侧 get_response 必须成对收取;outstanding 总线靠提前 item_done 加 fork 子线程流水线化——取件、回执、响应三件事各就各位,激励链才不会在半夜的回归里无声错位。