POCV 降额建模:LVF 的 sigma 表征、moment-based LVF 与悲观度对比
MMMC 与 OCV 寄生全景铺过多角多模的棋盘,OCV/AOCV/POCV 降额概念讲过三代降额的来龙去脉;本篇往库侧再钻一层:POCV(Parametric On-Chip Variation,参数化片上偏差)的统计模型到底怎么建——LVF(Liberty Variation Format)文件里那几列数字是什么意思,sigma 怎么从蒙特卡洛仿真来,moment-based LVF 为什么取代经典 LVF,以及在签核引擎里这些分布如何沿路径累加。
本文要回答的问题
- POCV 的「每个单元延迟是高斯分布」这句话,落到 .lib/LVF 文件里具体是哪些字段?
- sigma(标准差)是怎么从工艺仿真提取出来的?为什么 N5 以下经典 sigma 模型不够用了?
- moment-based LVF 的 mean shift、std deviation、skewness 三个矩分别修什么问题?
- 同一条 20 级路径,flat derate、AOCV、POCV 算出来的悲观度差多少?
- 先进节点为什么从「可以用 POCV」变成「必须用 POCV」?
一、从「系数」到「分布」:POCV 的建模对象
flat derate 时代,片上偏差是一个标量:所有单元统一乘 1.08,简单但粗暴——20 级路径和 3 级路径被扣一样多的余量。POCV 换了一个世界观:每个时序弧的延迟不再是一个数,而是一个随机变量,工程上近似为高斯分布 N(μ, σ²)。建模的任务就退化成两件事:给每条弧定 μ(标称延迟,NLDM/CCS 本来就给),再定 σ(偏差项,LVF 专门给)。
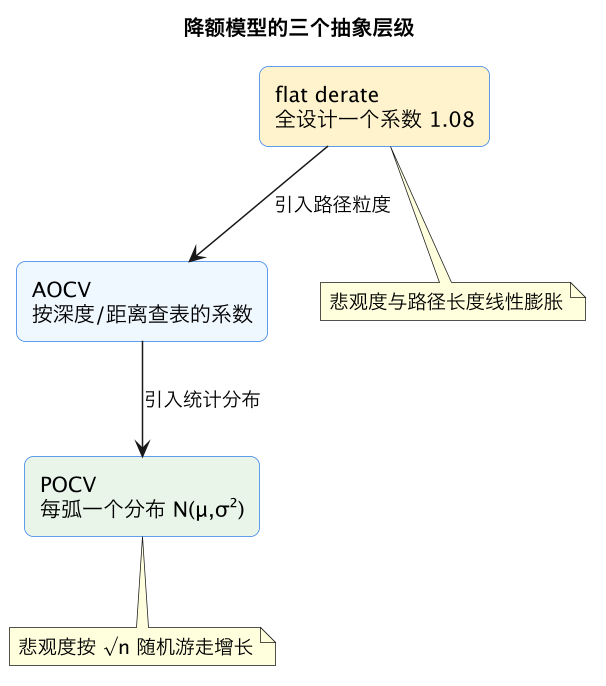
这张图是理解全篇的钥匙。flat derate 的悲观度随级数 n 线性增长(每级都乘同一个系数),而独立随机变量累加时,标准差只按 √n 增长——20 级路径的统计悲观度大约只有 flat 的 20/√20≈4.5 分之一。级数越多,POCV 省下的余量越可观,这正是它在深度流水线设计上收益巨大的原因。
二、LVF 文件里到底写了什么
LVF 是 Liberty 语法的扩展,挂在 timing 弧上的偏差表。经典 LVF(synopsys 口径也叫 sigma-based LVF)每个弧给一张与 PVT、输入转换时间、输出负载相关的 sigma 表:
| LVF 字段 | 含义 | 签核引擎怎么用 |
|---|---|---|
ocv_sigma_delay_rise/fall | 延迟本身的 σ | 沿路径累加方差 |
ocv_sigma_slew_rise/fall | 输出斜率的 σ | 传到下一级影响其延迟 σ |
ocv_sigma_setup/hold_constraint | 时序约束值的 σ | 直接加在 required time 上 |
| 索引轴 | input transition × output load | 与 NLDM 查表方式一致 |
提取流程是:代工厂或库厂用 SPICE 级蒙特卡洛(或响应面模型 RSM)对每个单元在每个 corner 下扰动工艺参数(Vth、Leff、tox、互连 RC),跑几百到几千次仿真,把延迟样本的均值和方差拟合成查找表。这张表的口径与 PDK 的局部失配(local mismatch)+ 全局片上偏差(global OCV)分开建模还是合并建模有关,因此LVF 文件必须和对应 corner 的 .lib 严格配对,混用等于拿别人的骰子掷自己的签。
三、经典 LVF 的天花板与 moment-based LVF
经典模型有一个隐含假设:延迟分布是对称高斯。28nm 以上这个近似尚可;到了 N7/N5/N3,三个物理效应把假设打穿:
- 低电压运行:0.6V 附近延迟对 Vth 的灵敏度急剧非线性化,分布长出长尾;
- FinFET/GAA 量子与工艺涨落:RDF(随机掺杂涨落)虽减轻,但金属栅粒度、鳍宽涨落引入偏斜;
- 反向温度效应与局部自热:延迟-电压曲线不再是单调光滑形状。
非高斯分布只用 σ 描述,会系统性低估悲观一侧的尾巴,签核就可能欠保护。moment-based LVF 的解法是用统计矩代替单一 σ,每个弧给三个量:
| 矩 | 物理含义 | 修正的问题 |
|---|---|---|
| mean shift(均值偏移) | 分布中心相对标称值的平移 | 标称延迟本身就偏乐观/悲观 |
| std deviation(标准差) | 分布宽度 | 等价于经典 σ |
| skewness(偏度) | 分布左右不对称程度 | 长尾方向的欠保护 |
签核引擎拿到三个矩后,用 Cornish-Fisher 展开或矩匹配把路径级分布重构出来,再取目标分位(如 3σ 或指定的 99.865% 分位)作为签核点。这样即使单元级分布是偏斜的,路径级分位点也不再依赖高斯假设。
迁移到 moment-based LVF 时还有一个口径陷阱:经典 LVF 的 σ 表与 moment 表不能混算。同一条路径里如果一部分弧来自 moment 库、另一部分弧只有 σ 数据,引擎要么把 moment 退化成 σ(丢掉偏度信息),要么用默认值给缺矩的弧补齐——两种做法都会在报告里留下不易察觉的偏差来源。库交付检查时应把「所有 corner 下 LVF 口径一致」列入验收项,而不是只看文件存在。
四、引擎侧:分布如何沿路径累加
POCV 签核引擎的内部动作可以拆成三步,下图是数据流:
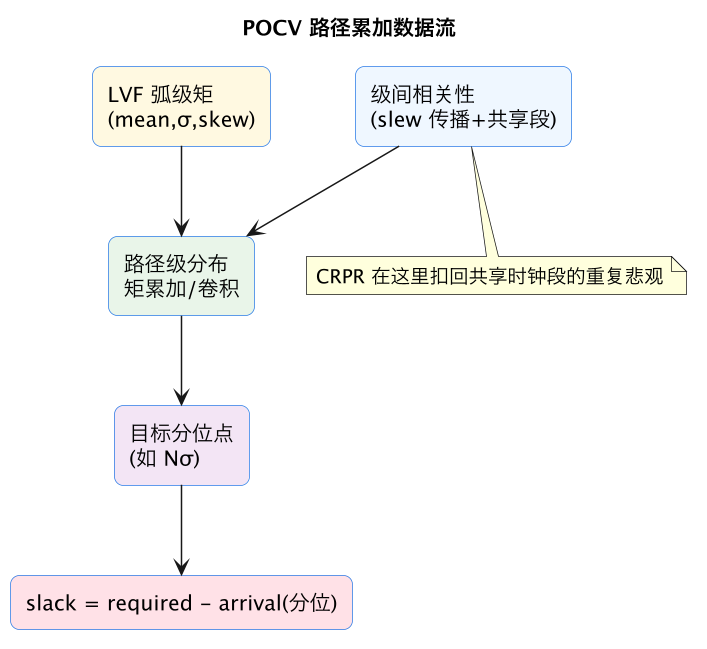
两个细节决定累加的准确度。其一,slew 也要当随机变量传:上一级输出斜率的 σ 会调制下一级的输入转换时间,从而改变下一级的 μ 和 σ,引擎沿 timing graph 逐级传播这两个统计量。其二,相关性不能假装不存在:同一条时钟树共享段上的偏差是同一个随机源,launch 与 capture 各算一次就重复扣了,CRPR(Clock Reconvergence Pessimism Reduction)负责把这部分加回来;数据路径上相邻单元因版图邻近产生的空间相关,则由相关距离模型近似。
五、悲观度对比:一个 20 级路径的算例
设每级标称延迟 20ps,LVF 给的 σ/μ≈8%,目标签核分位 3σ:
| 模型 | 路径悲观量估算 | 相对 flat 的余量回收 |
|---|---|---|
| flat derate(±8%) | 20×20ps×8% = 32ps | 基准 |
| AOCV(按深度表收敛到 3%) | 20×20ps×3% = 12ps | 约 62% |
| POCV(σ 按 √20 累加) | 3×20ps×8%×√20/20 ≈ 4.3ps | 约 87% |
数字是示意,但量级关系是真实签核里反复观察到的:路径越长,POCV 相对 flat 的回收越接近 1−1/√n。对 hold 检查(路径短)回收有限,对 setup 长路径、深度流水线的时钟树,回收直接决定能否 closure。这也是为什么同一份 netlist,从 flat 切到 POCV 后 WNS/TNS 往往显著好转——不是时序变好了,是扣掉的假悲观还回来了。
六、为什么先进节点「必须」POCV
- 偏差占比倒挂:N5 局部失配 + 全局偏差占单元延迟的比例从 28nm 的约 5% 涨到 12-15%,flat derate 要覆盖就得把系数拉大到拖垮频率目标的程度;
- 非高斯尾巴:低电压下对称 σ 模型欠保护,只有 moment-based LVF 能给代工厂背书的签核分位;
- 经济性:POCV 相对 AOCV 每 100ps 周期省出的余量乘以全芯片路径数,折成的是面积(少插 buffer)、功耗(少 upsize)和 TAT(少 ECO 轮次);
- 代工厂签核要求:主流 N7 以下 PDK 的 signoff corner 直接以 LVF/moment-LVF 形式交付,AOCV 表不再随新节点维护——不是选不选,而是只有这一种口径。
工程落地时的注意事项:LVF 版本与 .lib 配对检查、库未提供 LVF 的单元(少数模拟/IO 单元)要回退到 derate 系数并在 waiver 清单登记、以及 POCV 分析的运行时与内存开销约为 OCV 的 1.5-2 倍,大设计要预留机器资源。
这一篇在知识体系里的位置
- 概念上游:OCV/AOCV/POCV 降额概念、OCV/AOCV/POCV 深读;
- 场景与棋盘:MMMC 与 OCV 寄生全景、corner×mode 矩阵;
- 库格式邻居:Liberty 多视图、NLDM/CCS 时序模型;
- 签核落地:PrimeTime/Tempus 黄金 STA 流程、S5 签核收敛;速查口径见 FAQ:OCV/AOCV/POCV 区别。
总结
POCV 降额建模把每条时序弧从「一个延迟数」升级为「一个带统计矩的分布」:经典 LVF 用 σ 描述高斯偏差、moment-based LVF 再加 mean shift 与 skewness 修正先进节点的非高斯长尾;签核引擎沿路径按 √n 累加方差、用 CRPR 扣回共享段相关性后取目标分位,使悲观度远低于 flat derate 与 AOCV——在偏差占比超过一成的先进节点,这既是代工厂唯一交付的签核口径,也是时序收敛与面积功耗经济的现实前提。