编译型仿真器内核:为什么它能跑赢解释型一个数量级(A1)
综述见 EDA 验证工具链:仿真器是验证的发动机。本篇握具体工具讲操作层——VCS、Xcelium(irun/xrun)、Verilator 这类编译型仿真器内部怎么把 RTL 变成可执行、工程上怎么组织编译、怎么提速、坑在哪。方法学(UVM/覆盖率)放下一篇。
一、两阶段(实际是三阶段)模型
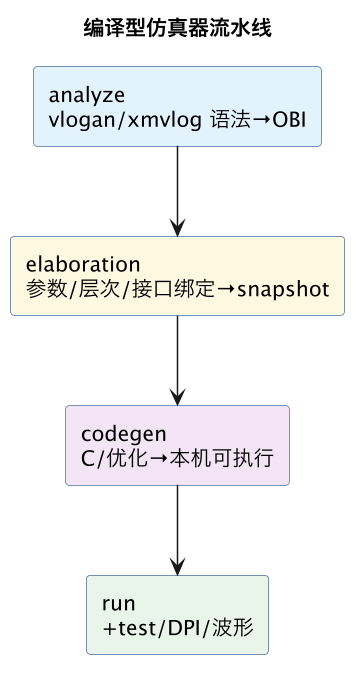
- analyze(编译):
vlogan/xmvlog按 filelist 检查语法,生成中间对象;SystemVerilog/VHDL/Verilog 可分别 analyze(对应 A5 多语言); - elaboration(细化):绑定 parameter、层次例化、接口与虚方法,解决跨文件引用,产出 snapshot;绝大多数「编译能过、起不来」错在这一阶段(找不到模块、接口多驱动、参数不匹配);
- code generation:把细化后的设计生成 C/C++ 再用本机编译器编成可执行——这是比解释型快的根本原因;
- run:可执行装载 test、通过 DPI/PLI 挂 C/C++ 模型,按 plusarg 选择波形/随机种子。
Verilator 更激进:只支持可综合子集,把 RTL 两态化、展开周期编成多线程 C++,因此比四态商用器再快数倍~数十倍,但不支持 X/Z 传播、时序延迟与完整 UVM——适合作为周期精确的高速回归/软件协同仿真,不适合需要 X 初始化检查的签核前仿真。
二、工程脚本骨架(两工具对照)
| 阶段 | VCS | Xcelium (xrun) |
|---|---|---|
| 编译+细化 | vlogan -f filelist.f → vcs top +vcs+... | xrun -elaborate -f filelist.f(可单命令) |
| 运行 | ./simv +UVM_TESTNAME=t1 +seed=... | xrun -R +UVM_TESTNAME=t1 ... |
| 多步调试 | -debug_access+pp 后接 Verdi | -access +rwc |
| 波形 | +vcdplusfile/FSDB via NOVAS | +fsdbfile/SHM |
| 加速 | -j N、partcomp 分区编译 | -j N、multi-cell |
xrun 是单命令封装(自动决定 analyze/elab/run),适合快速迭代;大流程里仍建议显式分阶段,错误定位和增量编译更清晰。
三、提速手段(按收益排序)
- 关掉调试负担:回归批跑不加
-debug_all/-access +rwc(可能慢 2~5 倍),需要时才在失败用例重放开波形; - 增量/分区编译(partcomp):稳定的 RTL 分区编成独立对象,改一处不重编全片,超大规模回归收益最大;
- 并行仿真:多机/多线程跑同一 testbench 的不同种子/向量分片,靠回归平台而非单线程提速;
- checkpoint/restore:在复位后、长激励前打快照,多个用例从同一 checkpoint 恢复,跳过重复的上电启动;
- DPI 化热路径:把纯算的参考模型用 C 写、DPI 调,避免 SV 里建大数组逐 bit 翻转;
- 波形分级:FSDB 仅 dump 层次/信号白名单或只在故障窗口 dump(见 F6 活动数据)。
四、排错速查
| 症状 | 多半在哪 | 处置 |
|---|---|---|
| 编译过、run 报 hierarchy/interface 错 | elaboration | 查 filelist 顺序、重复定义、虚接口未传 |
| X 传播争议(Verilator 正常、VCS 挂) | 两态 vs 四态 | 复位/初始化检查必须用四态器 |
| 回归比调试慢/快得反常 | debug 开关、波形 | 区分 debug build 与 batch build |
| DPI 调用结果错乱 | 参数方向/位宽 | 查 input/output、svOpenArrayHandle |
| 随机激励不可复现 | 种子未固定 | 强制打印并回灌 +seed |
相关与延伸
总结
编译型仿真器用「analyze→elaborate→本机 codegen」把 RTL 编成可执行而赢得一个数量级,工程上要分清编译/细化/运行三阶段定位错误、用分区编译+并行+checkpoint+DPI 给回归提速、并让调试开关和波形只在需要时打开;Verilator 的高速来自两态化,代价是不能承担需要 X 传播的检查。