SI 串扰增量延迟:攻击网络对齐窗口、delta delay 与 glitch 传播的签核口径
布线拥塞、DRC 与串扰从物理实现侧讲过串扰是怎么被布线工具「防」出来的——屏蔽、拉开间距、限制并行长度;黄金 STA:PrimeTime 签核流程讲过签核要开带 SI 模式,但只给了一句话。本篇把这一句话展开:SI 串扰增量延迟(crosstalk delta delay)到底是什么、攻击网络(aggressor)的翻转窗口怎么和受害者(victim)对齐、增量延迟为什么可正可负、噪声毛刺(glitch)凭什么能穿过逻辑门一路传下去,以及报告里哪些字段说明你的违例其实是串扰造成的。
本文要回答的问题
- 耦合电容摆在两条相邻网线之间,为什么只有「同时翻转」才影响延迟?
- 攻击网络的对齐窗口(alignment window)是怎么算出来的,为什么对齐越准越悲观?
- delta delay 为什么既能加速也能减速,方向和哪些因素有关?
- 串扰毛刺(glitch)的产生和传播判据是什么,为什么有的毛刺会被逻辑门「吃掉」?
- PrimeTime 里怎么开 SI 分析、报告怎么读、违例怎么修?
一、受害者、攻击者与耦合电容模型
在 28nm 之前,线间耦合电容占总寄生电容的比例还不高,串扰一般被当成噪声问题交给专门的 SI 工具扫一遍就算完。进入 16nm/7nm 之后,金属层越做越窄、越做越高,侧壁耦合电容(lateral coupling capacitance)在总电容里的占比可以超过一半,串扰从「噪声问题」升级为「延迟问题」——它直接改变 setup/hold 的计算结果,必须进 STA 主流程。
基本概念只有三个角色。受害者网络(victim net)是我们关心的那条线;攻击者网络(aggressor net)是和它有显著耦合电容、且时序窗口可能重叠的邻居线;两者之间是耦合电容 Cc。一条受害者通常有多个攻击者,工具会按耦合电容大小排序,过小的(比如低于某个阈值)直接剪掉,否则分析量爆炸。
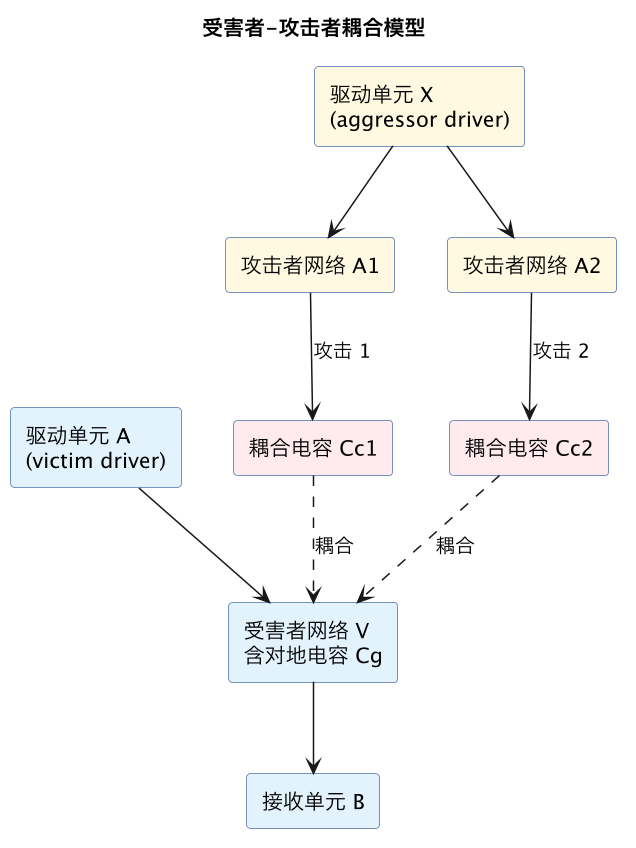
上图里要注意一个常被忽略的点:耦合电容两端都在动。如果攻击者不动(恒定 0 或恒定 1),Cc 对受害者来说就退化成一个普通的对地电容,只贡献一点固定负载,延迟算一次就完事,没有「增量」可言。SI 串扰增量延迟的前提是攻击者真的会翻、而且翻的时刻和受害者靠近。这就引出了下一节的对齐窗口问题。
二、攻击网络对齐窗口:什么时候才算「同时翻转」
STA 是静态分析,没有仿真波形,怎么判断攻击者和受害者「同时」翻转?答案是用到达时间窗口做重叠判断。每个网络在每个分析角下都有一个最早到达时间和最晚到达时间,构成一个时序窗口。受害者的窗口和攻击者的窗口有重叠,就认为它们可能同时翻转,串扰效应成立;完全不重叠,攻击者就算耦合电容再大也被排除。
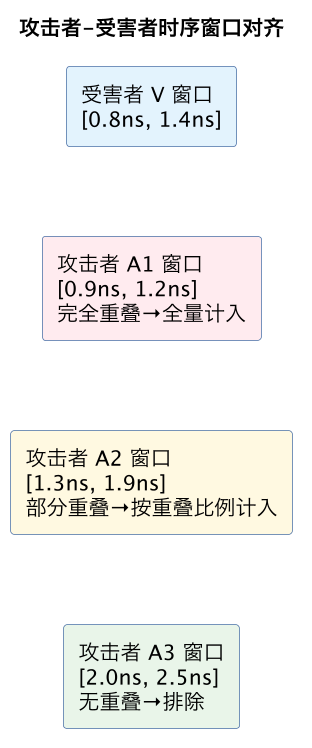
但窗口重叠只解决了「能不能算」,没解决「怎么对齐最坏」。对 setup 分析,工具要把受害者的延迟往大推,就要让攻击者翻得恰到好处——不是简单取攻击者窗口的中点,而是在重叠区间内搜索一个对齐位置,使受害者的增量延迟最大。这个搜索就叫窗口对齐(window alignment)。悲观度来自两处:一是攻击者真实翻转时刻由逻辑功能决定,未必能在最坏位置翻(比如它和受害者由同一时钟域里互斥的条件驱动),静态分析看不到功能关系,只能假设它能翻;二是多攻击者被假设在最坏位置同时对齐,而现实中它们各自的窗口未必能同时取到极值。这就是为什么 SI 分析天然偏悲观,也是 PrimeTime 签核流程里 path-based(PBA)模式能拿回一部分悲观度的地方——PBA 沿具体路径重算窗口,一些 GBA 里被判重叠的对齐在 PBA 里被证明不可能。
工程上还有一个反向问题:攻击者窗口本身是串扰影响后的结果。A1 的窗口被它自己的攻击者推宽了,又反过来影响 V 的对齐。工具的处理是迭代:先算一遍无 SI 的窗口,叠加串扰后更新所有窗口,再重新对齐,直到收敛或达到迭代上限。这就是为什么带 SI 的 STA 比不带慢好几倍的原因之一。
窗口对齐还有一个和工艺角强相关的坑:不同角下各网络的窗口宽度差别很大。SS 角下整体变慢,窗口被拉长,原本在 TT 角下不重叠的攻击者可能变得重叠;FF 角下边沿变快,耦合注入的电流脉冲更陡,单次对齐造成的增量反而更大。所以「哪个角串扰最坏」没有先验答案,setup 最坏通常在慢角、glitch 最坏常常在快角,这正是签核必须全角跑 SI 的物理理由,而不是流程上的形式主义。
三、delta delay:增量延迟的方向、大小与 slew 退化
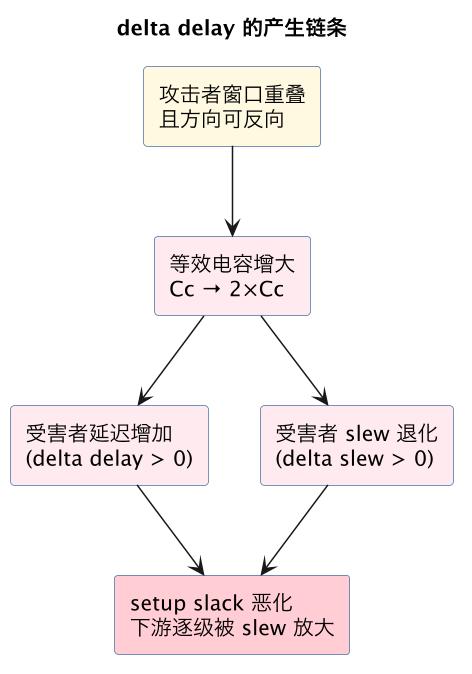
对齐完成之后才进入计算核心:受害者因为攻击者翻转,延迟变了多少。结论是方向相反减速、方向相同加速:
| 攻击者相对受害者翻转方向 | 对受害者的影响 | delta delay 符号 | 对哪项检查危险 |
|---|---|---|---|
| 反向(victim 升、aggressor 降,或反之) | 耦合电容等效充电量加倍,等效电容近似 2×Cc | 正(变慢) | setup 违例加剧 |
| 同向 | 耦合电容两端同涨同落,等效电容减小甚至接近 0 | 负(变快) | hold 违例加剧 |
| 不翻转 | Cc 退化为对地电容 | 零 | 无 |
这个现象用密勒效应(Miller effect)理解最直观:反向翻转时受害者驱动器要充放的电荷是 Cc×2ΔV,等效电容翻倍;同向翻转时两端电压差不变,Cc 上几乎没有电流,等于消失。所以串扰不是单纯的「变慢」,它让 setup 更坏的同时也在让 hold 更坏——hold 检查用的是最快数据路径,攻击者同向翻转把路径推快,余量被两头压缩。这也是为什么带 SI 分析常常发现 hold 违例变多而不是变少。
除了延迟本身,串扰还退化受害者的转换时间(slew):反向对齐让受害者的边沿拖长,而单元延迟和输出 slew 都是输入 slew 的函数(查 .lib 里的二维表),一级 slew 变差会沿着路径逐级放大。所以签核口径里 SI 效应包含两部分:增量延迟(delta delay)+ 增量 slew(delta slew),后者常被初学者漏看,却是深路径上 slack 突然崩掉一截的常见原因。
量级上给一个直觉:在 7nm 长并行走线上,单攻击者反向对齐造成的增量延迟可以到受害者线延迟的 20%–40%;多攻击者叠加后超过 100ps 并不罕见——而一个周期的 setup 余量可能也就这么多。这就是为什么 布线阶段宁可绕线也要限制并行长度:物理上拆掉的耦合,是签核阶段唯一不用付悲观税的解法。
还要澄清一个常见误解:delta delay 叠加在线延迟上,而不是单元延迟上。单元延迟由输入 slew 和输出负载决定,耦合电容确实会让负载变大从而间接推高单元延迟,但签核口径里这部分计入单元查表结果,「crosstalk delta」一列只报互连线段的增量。读报告时把两者混在一起,会误判该修单元还是修线。
四、glitch:串扰毛刺的产生与传播判据
延迟问题之外,串扰还制造另一类失效:受害者本来静止(恒定 0 或 1),攻击者翻转经耦合电容在受害者上感应出一个电压毛刺(glitch,串扰噪声)。毛刺不直接改变时序,但它有两个致命去处:一是被下游触发器当作有效边沿采样(功能错误,硅上表现为偶发数据错乱,极难复现);二是注入存储元件的异步端——clock、set、reset 引脚上的毛刺直接误触发,比数据路径上的更危险。
毛刺会不会闯祸,要过三道判据:
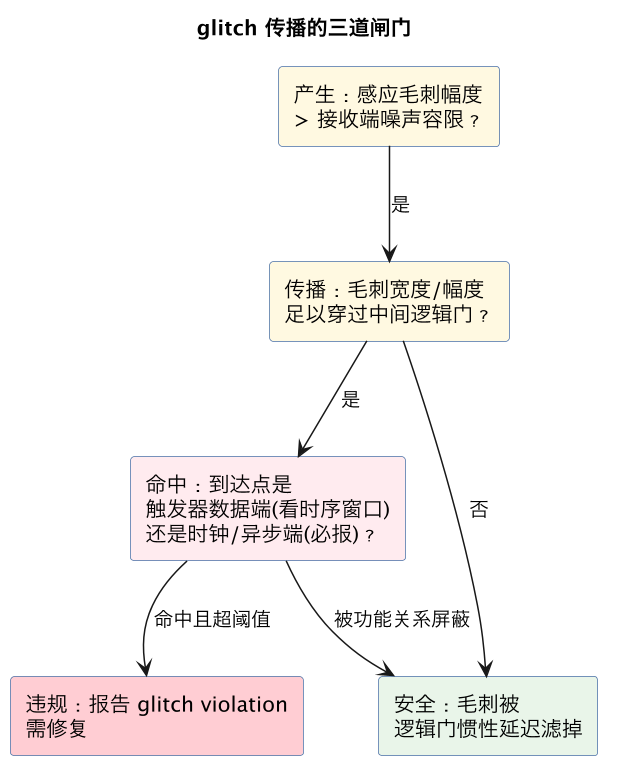
第一道是产生判据:毛刺幅度取决于攻击者摆率、Cc 与受害者对地电容的比例、受害者驱动器的保持强度。驱动器越弱(高阻长线的末端)、攻击者越快越近,毛刺越高;幅度低于接收单元的噪声容限(noise margin,.lib 里按输入高低电平各给一条曲线)就不算事。第二道是传播判据:逻辑门有惯性延迟,比门延迟窄的毛刺会被衰减——毛刺穿过一级门后变矮变窄,多级之后往往消失;但缓冲器链(buffer chain)几乎不衰减毛刺,这也是长 buffer 链路径容易报 glitch 的原因。第三道是命中判据:到数据端的毛刺只有在采样窗口内才可能被采走,工具会结合时序窗口判断;到时钟/set/reset 端的毛刺没有豁免,直接报 violation。
修 glitch 的手段和修 delta delay 同源:换强驱动、插 buffer 缩短单段线长、拉开间距、上下层换层走线,见 布线拥塞、DRC 与串扰的修复清单。区别在于 glitch 更吃「驱动强度」——把受害者驱动换大一档往往立竿见影,而对 delta delay 更有效的是拆并行。
五、PrimeTime 里怎么开 SI、报告怎么读
带 SI 的分析在 PrimeTime 里是一组开关的组合,核心变量如下:
| 设置 | 作用 | 签核口径建议 |
|---|---|---|
set si_enable_analysis true | 开启串扰增量延迟与噪声分析 | 签核必开 |
set si_xtalk_composite_aggr_mode statistical | 多攻击者叠加模式 | 统计叠加比简单全加省悲观 |
set si_filter_per_aggr_noise_peak_ratio | 小攻击者过滤阈值 | 过低运行时间爆炸,过高漏报 |
report_timing -input_pins -crosstalk_delta | 报告里展开每级串扰增量 | 定位串扰主导违例的关键列 |
report_noise -all_violators | 报 glitch 违规 | 布后必跑,重点看 clock/异步端 |
读 report_timing 时,带 -crosstalk_delta 后每一级会多出一列增量值:某一级线延迟后面跟着一个可观的正数(setup 路径)或负数(hold 路径),且该网络在 report_crosstalk(或等效查询命令)里能列出强攻击者,就可以定性「这条违例是串扰主导」。反过来,如果增量列普遍很小,违例是逻辑/布线结构问题,别浪费时间去修串扰。这个定性直接决定 ECO 走哪条路,是 ECO 变更传播里改动最小的分流点。
修复优先级按代价从低到高:先 size_cell 把受害者驱动换强(对 glitch 最有效、对 slew 退化次之);再对攻击者降 slew(set_max_transition 收紧或给攻击者驱动降档)——攻击者翻得越慢,耦合注入的电流越小,delta delay 和毛刺同步减小,这是「隔山打牛」的一招;然后插 buffer 拆长线;最后才是让布线工具对受害者做 shield 或拉开间距(route_eco 级别的改动,签核末期慎用,一改动寄生全变,所有角要回归)。
最后一个纪律:SI 分析必须在所有应签场景下跑齐。串扰的窗口对齐依赖每个场景各自的到达时间,func 模式下不重叠的攻击者在 test 模式下可能重叠,只跑一个角报「SI clean」不算数——这和 PrimeTime 签核流程里 MMMC 场景覆盖的要求是同一条纪律。
这一篇在知识体系里的位置
本篇属于 EDA 签核纵深:上承 PrimeTime 签核流程里「带 SI 模式」的一句话,把串扰增量延迟、对齐窗口与 glitch 三个概念展开;横向上,串扰的物理成因与预防在 布线拥塞、DRC 与串扰,寄生数据的来路在 SPEF/SDF 数据格式,多场景口径在 MMMC 与场景矩阵;往下,串扰违例的修复会进入 ECO 变更传播的回归链路。读完本篇,你应该能看懂签核报告里每一个 crosstalk delta 数字背后的物理故事。
总结
SI 串扰增量延迟的本质是:相邻网线经耦合电容互相「借力」,攻击者反向翻转把受害者推慢(伤 setup)、同向翻转推快(伤 hold),静止受害者还可能被感应出毛刺(伤功能);签核工具用时序窗口对齐判断「会不会同时翻」,用等效电容变化算「慢多少」,用三道判据筛「毛刺闯不闯祸」——看懂对齐窗口,就看懂了报告里每一个 delta delay 的来路,而最好的修复永远是在布线阶段就不让耦合发生。