llama.cpp 投机解码:内置 draft model 加速的用法、参数与实测收益
更新时间:2026-10-08。前面 投机解码推理 讲过投机解码(speculative decoding,用小模型先猜、大模型并行验收的解码加速技术)的通用原理,投机解码接受长度 分析过接受率与加速比的关系。本篇落到工程实操:llama.cpp 自带的
llama-speculative工具怎么用、参数怎么选、收益怎么量。llama.cpp 投机解码的特别之处在于它不依赖 vLLM/TensorRT-LLM 这类重型服务框架,一台 Mac、一块消费级显卡甚至纯 CPU 就能跑,是端侧和单机部署最顺手的加速手段。
本文要回答的问题
- llama.cpp 的投机解码在什么二进制里,目标模型和草稿模型怎么配?
--draft-max、--draft-min、--draft-p-min这些参数各管什么,怎么调?- 接受率从哪里看,多少接受率对应多少实际加速?
- 什么模型组合、什么负载下值得开,什么时候反而变慢?
一、原理三十秒回顾:一次前向验收一串
普通自回归解码每生成一个 token 都要跑一遍完整大模型前向,decode 阶段是显存带宽瓶颈——每步都要把全部权重读一遍,却只算出一个 token。投机解码的思路是:用一个快得多的小草稿模型(draft model)连续猜 k 个 token,然后把这 k 个拼成一段交给大模型一次前向并行验收,从前往后找到第一个大模型不同意的位置,前面的全部收下,那个位置用大模型自己的输出顶替,后面的丢弃重猜。
关键性质有两个。其一,输出分布在数学上与直接用大模型采样完全一致(验收用的是拒绝采样修正),所以开了投机解码不改变生成质量,只改变速度。其二,收益完全由「草稿命中率」决定:大模型一次前向的耗时约等于普通解码一步,如果平均每次能收下 a 个草稿 token,理想加速比约等于 a。llama.cpp 投机解码的全部调优,本质上就是在抬这个 a。
二、llama-speculative 上手:两个模型、一条命令
llama.cpp 的投机解码在独立二进制 llama-speculative 里(老版本叫 speculative),需要两个 GGUF 模型:目标模型(-m)和草稿模型(-md)。最小可跑命令:
llama-speculative \
  -m  Qwen2.5-7B-Instruct-Q4_K_M.gguf \
  -md Qwen2.5-0.5B-Instruct-Q8_0.gguf \
  --draft-max 16 --draft-min 4 \
-p "写一段快速排序的 Go 实现" -n 256选草稿模型的三条经验。第一,同系列同词表是硬约束:草稿模型的 tokenizer 和词表必须和目标模型一致,否则 token 对不上无法验收——所以草稿模型基本只能从同家族的小尺寸里挑(7B 配 0.5B/1.5B,70B 配 7B)。第二,草稿模型量化可以比目标模型更激进:它只负责猜,猜错有大模型兜底,Q4 甚至 Q3 的草稿模型接受率掉得很少,但前向快不少。第三,草稿模型参数量控制在目标模型的 1/10 到 1/50:太小接受率崩,太大猜本身就成了瓶颈。GGUF 格式与量化档位的选择细节见 GGUF K-quant 选择 和 llama.cpp GGUF 格式。
GPU 部署时注意两个模型都要分 layer 数:-ngl 管目标模型,--draft-ngl(或 -ngld)管草稿模型。显存紧张时草稿模型可以全放 GPU、目标模型部分 offload,CPU 线程绑定技巧参考 llama.cpp CPU 线程绑定。
三、一轮解码的内部流程
下面这张图把 llama-speculative 的一轮 draft-verify 循环画清楚,注意验收是「大模型一次前向」而不是逐 token 调用。
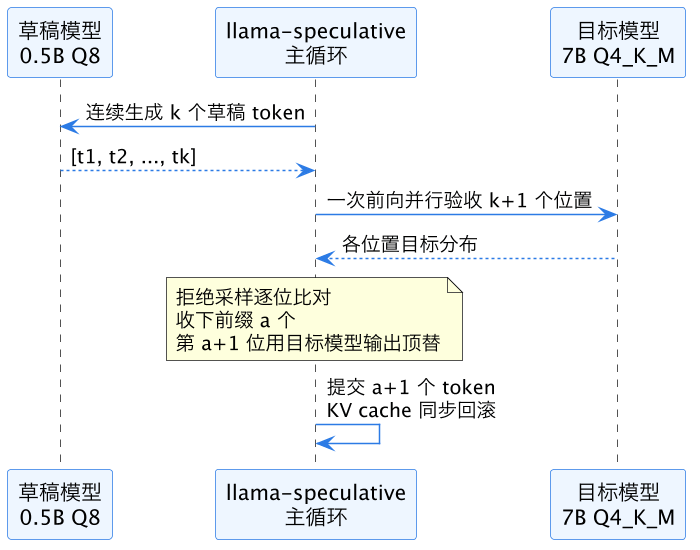
图里最容易被忽略的是最后一行「KV cache 同步回滚」:被拒绝的草稿 token 已经进了草稿模型的 KV cache,llama.cpp 会把两边的 KV 状态裁到一致位置再开下一轮。这个回滚是有成本的,草稿猜得越长、拒绝越靠后,白算的 token 越多——这正是下一节参数要权衡的事。
四、参数调优:draft-max 与接受率
三个核心参数:
| 参数 | 含义 | 默认值 | 调大 | 调小 |
|---|---|---|---|---|
--draft-max | 每轮最多猜几个 token | 16 | 接受率高时收得更多 | 降低白算与回滚成本 |
--draft-min | 每轮至少猜几个 | 5(依版本) | 避免碎轮次 | 让采样早停更灵 |
--draft-p-min | 草稿 token 概率低于此值就提前停猜 | 0.75 | 更敢猜长串 | 更早收手保接受率 |
调参逻辑一句话:接受率说了算。llama-speculative 运行结束会打印 n_accept / n_drafted 统计,即草稿 token 被接受的比例。经验换算:接受率 0.75 左右时,平均每次验收收下约 3~4 个 token,对应实际加速 1.8~2.2 倍;接受率掉到 0.5,加速只剩 1.3~1.5 倍;低于 0.35 基本不值得开——草稿模型自身的前向开销(哪怕只有目标模型的 1/15)已经把收益吃光了。
接受率怎么抬?三件事按性价比排序。第一,换更贴近目标模型分布的草稿模型:同家族微调版永远比通用小模型好,有业务领域微调的目标模型时,草稿模型最好也过一遍同样的微调数据(草稿模型训练的系统方法见 draft model 训练)。第二,调 --draft-p-min:代码、数学这类低熵负载草稿模型信心天然高,0.6 也能猜得又准又长;创意写作这类高熵负载要收紧到 0.8 以上。第三,--draft-max 跟着接受率走:接受率 0.8 以上拉到 16~24 都收得回来,0.6 以下压到 6~8 减少白算。
负载类型对收益的影响极大,给一张速查表:
| 负载 | 典型接受率 | 实测加速(7B+0.5B,M 系芯片) | 结论 |
|---|---|---|---|
| 代码生成 | 0.75~0.85 | 1.8~2.2x | 最值得开的场景 |
| 结构化输出(JSON/表格) | 0.8 以上 | 2x 以上 | 模板部分几乎全猜中 |
| 中文闲聊 | 0.6~0.7 | 1.4~1.7x | 值得开 |
| 开放创意写作 | 0.5~0.6 | 1.2~1.4x | 可开可不开 |
| 高温度采样(T>1.0) | 0.4 以下 | 不到 1.1x | 关掉,纯开销 |
五、什么时候不要开
三种情况投机解码是负收益。其一,追求极限吞吐的多并发服务:投机解码省的是单请求的解码步数,但每步算 k+1 个位置,总计算量是上升的;批量一拉满,GPU 从带宽瓶颈变成算力瓶颈,投机解码反而降低总吞吐——服务端高并发场景该看 vLLM 侧的 PagedAttention 与 vLLM 推理显存,llama.cpp 投机解码的主场是单流或低并发端侧。其二,草稿模型质量太差或词表不匹配,接受率低到 0.3 以下,纯纯白算。其三,prompt 极长输出极短的负载(如长文档分类):耗时大头在 prefill,投机解码只加速 decode,开了也看不见收益。
验证收益的正确姿势是同 prompt、同 seed、同输出长度跑两遍:关投机解码记一次 eval time(llama.cpp 会打印每 token 毫秒数),开了再记一次,同时看接受率统计。不要凭感觉——猜测带来的额外显存占用(两份 KV cache)在显存紧张的机器上可能触发 swap,表面上接受率不错,端到端反而更慢。另一个实用技巧是先在 32 个 token 的小输出上做冒烟对比,确认接受率落在合理区间再拉长输出正式测——接受率不达标时,先换草稿模型或收紧 --draft-p-min,而不是急着下「投机解码没用」的结论。
这一篇在知识体系里的位置
本篇是投机解码线的工程实操篇:原理层 投机解码推理、投机解码方法全景、投机解码接受长度;同层进阶 draft 长度调优、EAGLE 与 Medusa 多头草稿、树状验证 kernel;llama.cpp 部署侧 llama.cpp GGUF 格式、llama.cpp CPU 线程绑定。
总结
llama.cpp 投机解码用 llama-speculative 配「目标模型 + 同词表小草稿模型」即可开启,大模型一次前向验收草稿串、数学上输出分布不变;收益全看接受率——0.75 对应约 2 倍加速、0.5 只剩 1.3 倍、0.35 以下倒贴,代码和结构化输出是最甜场景,高温度采样和多并发服务不要开;调参就三招:草稿模型贴近目标分布、--draft-p-min 按负载熵值收紧放松、--draft-max 跟着接受率伸缩,验收时同 seed 对比 eval time 并盯接受率统计。