Yosys write_json 下游 QoR 统计:用 Python 提取单元并核对 stat
更新时间:2026-11-22。综合回归里经常要回答的不是「这条命令有没有跑完」,而是「这次修改多了哪些单元、寄存器有没有变化」。人工翻日志能看一次,却不适合几十组参数反复比较。本文把
write_json当作机器接口,在固定综合阶段导出三份 RTLIL JSON,用 Python 标准库生成可复核的单元表,再与stat对照。Yosys stat 报告怎么读 解释报告字段,本文继续解决下游脚本怎样取数、怎样避免层次实例重复计数。
本文要回答的问题
write_json导出的modules、cells、netnames与attributes分别承担什么角色?- 只数顶层
cells和从顶层递归展开实例,为什么会得到不同的 QoR 数字? - 怎样只用 Python 标准库提取单元类型与数量,并用
stat -json做独立核验? - 组合、时序、层次三个设计在相同 pass 阶段各得到什么结果?
- 这些计数能支持什么决策,又不能被解释成面积、门数或时序结论?
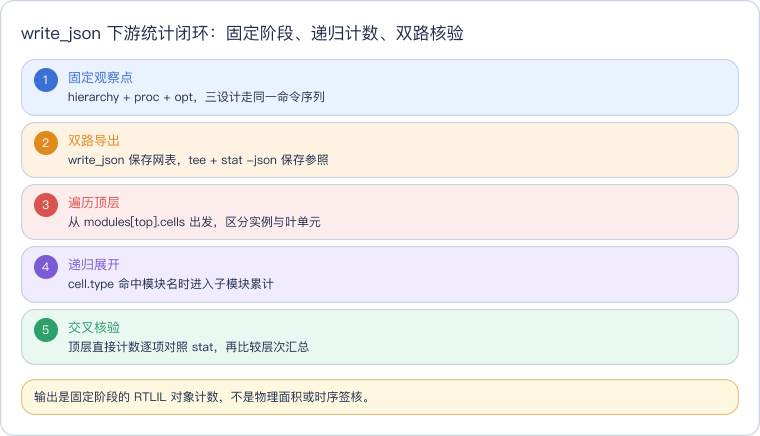
这条链路里最重要的不是换了一种画图或制表工具,而是把「直接单元」「层次实例」「展开后的叶单元」三个口径分开。后续所有结果都以这条定义为前提。
一、先固定观察点,否则 JSON 数字没有可比性
实验使用下面这条 Yosys 命令骨架,${design} 只是 shell 变量,不是 JSON 字段:
yosys -p "read_verilog -sv rtl/arbiter4.v rtl/counter8.v rtl/hier_alu.v; \
  hierarchy -check -top ${design}; proc; opt; \
  stat; tee -o build/${design}.stat.json stat -json; \
  write_json build/${design}.json"
hierarchy -check -top 选定根模块并移除不可达模块,proc 把 always 过程转换成寄存器与选择逻辑,opt 合并等价单元、清理未使用对象。三个设计都停在这里,不继续 techmap 或工艺映射,所以表中 $add、$mux 是 RTLIL 抽象单元,不能直接称为实际门数。
stat -json 在这一版本的 Yosys 里把 JSON 写到标准输出,后面的文件名会被当成选择表达式,而不是输出路径。因此用 Yosys 自己的 tee -o 文件 stat -json 落盘。这个细节很容易漏掉:仅写 stat -json result.json,日志会出现选择未匹配警告,预期的结果文件也不会生成。
| 命令片段 | 对统计口径的影响 | 回归时应如何使用 |
|---|---|---|
hierarchy -check -top | 确定遍历根,清理不可达模块 | 顶层名必须与脚本参数一致 |
proc | 过程变成 $dff、$adff 等对象 | 未执行前不能按最终电路解释 |
opt | 合并、化简并清除无效对象 | 对照实验必须保持完全相同 |
write_json | 保存当前内存设计 | 放在观察点,不与综合日志混写 |
stat -json | 提供同观察点的独立计数 | 用 tee -o 保存并纳入差异检查 |
二、读懂 JSON 结构:计数走 cells,位连接走 bits
RTLIL 是 Yosys 的内部设计表示,write_json 是它的序列化结果。它不是一个只含单元清单的平表,模块端口、内部线名和对象来源也都保存在同一文件里。
图中蓝色是模块入口,绿色描述命名与位连接,橙色是真正参与本次 QoR 计数的单元,紫色是附加元数据,红色提醒实例不能当作普通叶单元。ports.bits 与 connections 中的整数是位编号,常数位则用 "0"、"1"、"x"、"z" 字符串表达;netnames 给这些位向量附上名称。单元数量应遍历 cells 的对象值并读取 type,不要数 netnames,也不要数连接数组的长度。
attributes 常用于保存 src、top、keep 等信息,它描述对象的来源或约束,不自动增加一个电路单元。parameters 中的 A_WIDTH、Y_WIDTH 等位字符串可进一步用于位宽统计,但那是另一项口径:一个 8 位 $add 仍是一个 cell,不能因为它有 8 位输出就报成 8 个加法器。
例如本次 hier_alu 的子模块中,JSON 把一个加法器记录为 $add,其 A_WIDTH、B_WIDTH、Y_WIDTH 均为 8;同层还有一个 $sub 和一个 $mux。attributes.src 指回 rtl/hier_alu.v 第 7 行,说明三个对象来自同一条条件表达式。这样既能做总量表,也能在异常时回到源码位置。
三、实验设计:三个结构差异对应三个检查点
为了不让「三张表」变成同一结果的重复展示,三个输入分别承担不同任务。
| 顶层 | RTL 结构 | 统计要验证的问题 |
|---|---|---|
arbiter4 | 4 路固定优先级仲裁,纯组合 | 时序计数必须为 0,共享子表达式经 opt 合并后的数量可重复 |
counter8 | 8 位异步低有效复位、装载与使能计数器 | 一个多位寄存器对象与加法、选择逻辑应分开统计 |
hier_alu | 顶层寄存器加 addsub8 子模块 | 顶层直接单元是 2,但递归展开后的叶单元应为 4 |
arbiter4 的四个 grant 共用低优先级请求取反,opt 将相同的 $not 合并;这提醒我们,综合后统计衡量的是优化后的结构,不是 RTL 运算符出现次数。counter8 虽然有 8 位状态,却只生成一个 $adffe,再次说明 cell 数不等于触发器位数。hier_alu 则专门制造「一个单元其实是整个子模块」的情况。
核心 Python 遍历可以压缩成下面几行。完整脚本还包含参数解析、错误处理与对照逻辑:
def walk(module_name):
    for cell in modules[module_name].get("cells", {}).values():
        cell_type = cell["type"]
        if cell_type in modules:
            instances[cell_type] += 1
            walk(cell_type)
        else:
            leaf_cells[cell_type] += 1
这里没有把所有以 $ 开头的类型硬编码成白名单,而是用当前 JSON 的 modules 键判断层次关系,因此参数派生模块名也能走同一条路径。未知黑盒或工艺单元不在 modules 中,会被计为叶单元;如果项目需要把黑盒单列,应另加类型表,而不是默默把它算作已知逻辑。
四、统计脚本与 stat 双路核验
完整脚本产生两类结果。第一类是 direct_cells:只统计 modules[top].cells,用于与 Yosys 自己的顶层统计逐项比较;第二类是 leaf_cells:递归展开用户模块实例后的总数,用于 QoR 横向表。只有直接计数完全一致,脚本才打印 direct_stat_match=PASS,否则返回非零退出码。
层次设计的实测输出如下,注意 direct_cells=2 与 leaf_cells=4 同时存在,并不矛盾:
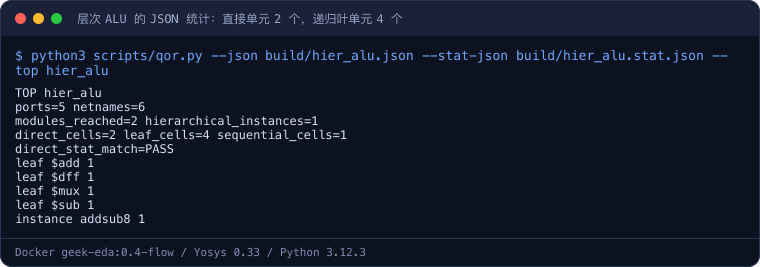
这段输出中的 addsub8 1 是实例记录,不计入叶单元总数;递归后得到 $add、$sub、$mux 各一个,加上顶层 $dff 一个,总计 4。Yosys 文本 stat 的 design hierarchy 汇总也给出同一组四个类型。也就是说,Python 与 stat 不只是总数碰巧一样,顶层直接分类和展开后的分类都能对上。
计数器的输出则提供了另一种锚点:
TOP counter8
ports=6 netnames=10
modules_reached=1 hierarchical_instances=0
direct_cells=5 leaf_cells=5 sequential_cells=1
direct_stat_match=PASS
leaf $add 1
leaf $adffe 1
leaf $mux 2
leaf $reduce_bool 1
ports=6 对应 clk、rst_n、en、load、din、q 六个端口,netnames=10 还包含综合过程生成的内部命名对象。二者只是结构规模信息,不应加进单元总数。sequential_cells=1 也不是说电路只有一位状态,而是说当前 RTLIL 用一个 $adffe 对象表示整个 8 位寄存器。要进一步核对位宽,可以读取该单元 parameters.WIDTH 的位字符串,或检查 connections.Q 的数组长度,两者在本例都是 8。这样把「对象数」与「对象宽度」分成两个字段,回归报告才不会把重构引起的对象拆分误报成状态位增加。
建议下游结果文件保留 top、Yosys 版本、导出命令摘要、direct_cells、leaf_cells、各类型计数与对照状态,而不是只留下一个合计。合计相同但类型迁移,例如 $mux 减少而 $and 增加,仍可能代表一次有意的逻辑重写;只盯总数会漏掉这种变化。反过来,合计变化也未必是缺陷,opt 策略改变就足以重排对象,因此差异必须回到同一版本、同一 pass 链下解释。
核验分两层更稳妥。stat -json 的 modules 键带反斜杠前缀,例如 \\counter8,其单元计数字段是 num_cells_by_type;write_json 的模块键则直接使用 counter8。脚本处理这两种命名后再比较 Counter 对象,任何一种单元数量变化都会失败。对于层次设计,还应查看 stat -json 的 design.num_cells_by_type 或文本层次汇总,不能只拿顶层 $dff + addsub8 去验证递归结果。
时序分类也要避免宽松字符串匹配。例如 $add 与 $adffe 都以 $ad 开头,用「前缀含 d 就算寄存器」会把加法器误报为时序单元。实验脚本要求类型匹配完整的 dff、dlatch 或 latch 词干,再统计其带复位、使能的变体。更严格的项目可以按所用 Yosys 版本维护显式类型表,并把未知新类型列为待复核项。
五、三设计 QoR 结果:看构成,不夸大结论
固定 proc; opt 后的完整结果如下,所有数字都来自上述 JSON 与日志:
| 顶层 | 顶层直接单元 | 层次实例 | 展开叶单元 | 时序叶单元 | 叶单元类型明细 |
|---|---|---|---|---|---|
arbiter4 | 10 | 0 | 10 | 0 | $and 6、$not 3、$reduce_or 1 |
counter8 | 5 | 0 | 5 | 1 | $add 1、$adffe 1、$mux 2、$reduce_bool 1 |
hier_alu | 2 | 1 | 4 | 1 | $add 1、$sub 1、$mux 1、$dff 1 |
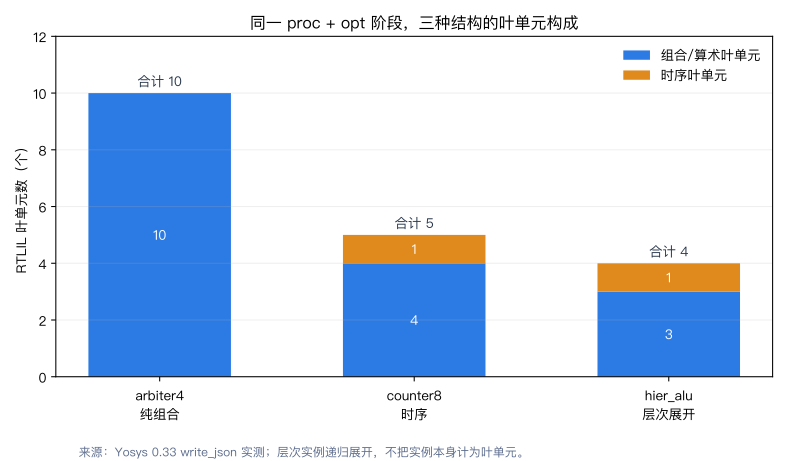
图中蓝色是组合或算术叶单元,橙色是时序叶单元。仲裁器的 10 个对象全部来自优先级逻辑;计数器总量虽只有 5,却有一个 $adffe 承载 8 位状态;层次 ALU 的柱高按递归后的 4 计算,而不是顶层的 2。这个对比适合做「结构是否按预期变化」的回归检查,不适合据此断言哪个设计运行更快。
从读者决策看,可以把脚本用于三个具体场景。其一,修改 RTL 前后比较同一单元类型,寄存器对象意外增加时回到 src 属性定位;其二,参数扫描时保存每组 JSON 和统计表,避免人工复制 stat;其三,在层次设计里分别跟踪直接实例数与叶单元数,判断变化来自例化关系还是子模块内部。若指标是寄存器位数,还要结合 Q 连接长度或参数计算,不能复用本篇的时序 cell 数。
六、统计边界与落地清单
QoR(Quality of Results,结果质量)在完整流程里还包括面积、时序、功耗与布线拥塞。本文只实现其中的结构计数,标题中的 QoR 表不能替代后续签核。尤其在 RTLIL 抽象阶段,一个 $add 后续可能映射成许多门,不同位宽和进位结构也会影响结果。
脚本遇到 JSON 语法错误或顶层缺失时会直接异常退出,不会打印一张全零结果表;接入持续集成时,这类失败与 MISMATCH 一样都应让本次统计无效。还要避免上游 Yosys 中断后继续读取上一轮残留 JSON:每次运行先清理独立输出目录,全部对照通过后再归档版本、命令和结果,防止旧数据造成假通过。
| 需求 | 本篇脚本是否直接满足 | 正确补充动作 |
|---|---|---|
| 比较固定阶段的 cell 类型与数量 | 满足 | 固定 Yosys 版本、pass 和顶层 |
| 统计层次展开后的叶单元 | 满足 | 从顶层递归,不汇总所有模块定义 |
| 计算寄存器总位数 | 不直接满足 | 结合单元参数、端口位宽和连接向量 |
| 得到标准单元面积 | 不满足 | 技术映射后读取 Liberty 面积属性 |
| 判断最高频率或关键路径 | 不满足 | 映射后执行静态时序分析 |
| 检查 JSON 截断或回读兼容性 | 不属于本篇 | 分别走文件完整性与往返检查 |
把脚本接入自己的回归时,按下面顺序落地:固定导出命令;保存原始 JSON 与 Yosys 版本;先做顶层直接计数对照;再生成递归叶单元表;最后对差异设置项目自己的阈值。重复例化同一模块 N 次时,递归会被调用 N 次,这是按实例展开的正确语义,不要给模块做全局「只访问一次」去重。若设计可能存在递归例化,则应在进入前做层次合法性检查,正常可综合设计不应形成模块实例环。
另一个常见误区是把 modules 中所有模块的 cells 直接相加。未被顶层可达的模块、同一模块被多次例化、参数派生模块同时存在时,这种算法都会偏离真实实例规模。以顶层为根、按每次实例调用展开,才是与层次设计一致的统计方式。
实验环境
- 机器/系统:macOS 宿主机启动 linux/amd64 Docker 容器,容器内 Ubuntu 24.04
- 工具版本:
Yosys 0.33 (git sha1 2584903a060),Python 3.12.3,镜像geek-eda:0.4-flow - 日期:2026-11-22
- 完整命令:实验目录执行
bash run.sh;脚本对arbiter4、counter8、hier_alu依次运行read_verilog -sv、hierarchy -check -top、proc、opt、stat、tee -o ... stat -json与write_json,再调用scripts/qor.py比较直接计数并递归统计叶单元 - 原始记录:
run1.log保留三份完整 Yosys 输出、三组 Python 结果和最终通过行;各设计的独立日志、JSON 与统计结果随实验目录保存在build/
代码获取
三份 RTL、Python 统计脚本、容器运行脚本、README 和本次生成结果已整理到公开仓库:geek-doc.cn/experiments/flow-yosys-json-qor-script。取得相同镜像后进入目录执行 make run,即可重新生成三份 JSON、顶层对照结果与叶单元表;scripts/plot_qor.py 可用实测 JSON 重绘本文柱状图。
这一篇在知识体系里的位置
- 想先弄懂
Number of cells、线网位数和不同阶段单元名:读 Yosys stat 报告怎么读; - 要确认 JSON 清空后回读仍保留哪些参数、属性与连接:读 Yosys JSON 网表回读,它处理往返保真,不处理本文的层次 QoR 脚本;
- 遇到
Unexpected EOF in JSON file,先按 Yosys read_json 截断排查 恢复完整文件,文件合法后再运行本文统计; - 想调整
proc、opt在流程里的位置:读 Yosys 手工 pass 链,但改变观察点后应重新建立基线。
总结
Yosys write_json 下游 QoR 统计的关键不是把 cells 全部相加,而是固定观察点并区分口径:modules[top].cells 给顶层直接单元,cell.type 命中 modules 键时表示层次实例,递归展开后才得到叶单元。本次 Yosys 0.33 实测中,arbiter4 有 10 个组合叶单元,counter8 有 5 个叶单元且仅 1 个时序对象,hier_alu 顶层直接单元为 2、递归叶单元为 4;三组直接计数都与 stat -json 一致,层次汇总也与文本 stat 相符。把原始 JSON、版本、命令和双路核验一起保存,就能形成可复现的资源回归表;但 cell 数仍不是寄存器位数、工艺面积或时序性能,后续指标必须换对应工具与数据口径。