投机解码方法全景:draft model、EAGLE、Medusa、prompt lookup、MTP 与 tree attention 的选型决策框架
更新时间:2026-10-05。这是一篇枢纽文。站内已经有一批投机解码的长尾深文——投机解码推理加速、接受率与接受长度、EAGLE 与 Medusa 投机头、prompt lookup 解码、MTP 多 token 预测、tree attention 草稿验证内核、投机草稿模型训练——每篇都在回答「某一条路线怎么跑好」。这篇换一个更靠近架构选型的视角:这么多条投机路线,我的负载到底该上哪一条。投机解码(speculative decoding)要做的事情,就是把「逐个 token 串行解码」这件带宽受限的苦差,变成「小代价猜一批、大模型并行验一批」的流水线游戏,而各路线的差别全在「谁来猜、猜成什么形状、猜错了亏多少」。
本文要回答的问题
- 为什么 decode 阶段天然适合投机——投机解码到底在利用哪一段被浪费的硬件能力?
- draft model、EAGLE、Medusa、prompt lookup、MTP、tree attention 六条路线各自「谁来起草」,机制差异在哪里?
- 接受率、草稿开销、验证开销三个指标怎么合成一条「端到端加速比」的估算公式?
- 不同负载(代码补全、RAG 问答、闲聊对话、长输出 Agent)下,各路线的加速比为什么天差地别?
- 从零落地,一条「先白嫖、再小训、再重投入」的渐进式选型路径长什么样?
一、投机解码为什么成立:decode 是被显存带宽掐住脖子的阶段
要理解全景,先理解共同的病根。大模型推理分两段:prefill 把整个 prompt 一次性并行算完,是计算密集;decode 逐 token 串行生成,每生成一个 token 都要把全部模型权重和 KV cache 从 HBM 读一遍,但这一步的计算量小到可怜——算术强度(每字节访存对应的浮点运算数)极低,GPU 的算力大片闲置,瓶颈完全在显存带宽。batch size 等于 1 的 decode,H100 的算力利用率常常不到 5%。
投机解码的核心观察是:decode 一步能算出 1 个 token,也同样能并行算出 k 个候选位置的 logits——只要把这 k 个候选拼进同一次前向。验证 k 个草稿 token 的成本和生成 1 个 token 的成本几乎一样(都是一次带宽受限的前向),如果草稿被接受了 n 个,这一步就净赚 n-1 个 token 的进度。这就是全部路线的共同公式:
端到端加速比 ≈ 平均接受长度 /(1 + 草稿成本系数 + 验证浪费系数)
三条路线的竞争,本质是围绕这个公式的三项做文章:draft model 路线压低「草稿成本系数」时牺牲了「接受长度」;prompt lookup 把草稿成本压到接近零但接受长度波动极大;EAGLE/Medusa/MTP 试图两头都占;tree attention 则把「一次验证 k 个」扩展成「一次验证一棵树」,从验证侧抬高平均接受长度。接受率的精确定义与测量方法,见 接受率与接受长度。

上图把投机解码的「白嫖逻辑」画清楚了:同一次前向的两种用法,左边是原始解码把并行验证能力白白扔掉,右边是投机解码把它兑换成进度。注意右下角那个黄色分支——拒绝不是免费的,草稿前向和验证中被丢弃的算力都是真实开销,所以投机不是稳赚,是「期望收益为正才值得开」的赌局。下注之前先估接受率,这正是选型框架的出发点。
还有一个数学性质值得记住:只要验证流程严格按目标模型的分布做拒绝采样,投机解码的输出分布和原始解码逐位一致,不是近似。这意味着开不开投机不改变模型行为,只改变速度——这也是它区别于量化、蒸馏这类「有损压缩」加速手段的根本点,业务侧无需为开投机重新验收模型质量。工程上要保证这个性质,验证必须用目标模型自己的 logits 做接受判定,任何「看着差不多就接受」的宽松策略都会引入分布漂移。
二、六条路线的机制版图:谁来起草、猜成什么形状
把六条路线摆在同一张地图上,分类轴只有两根:草稿从哪来(外部小模型 / 主模型自带的头 / 上下文检索)和草稿是什么形状(一条链 / 一棵树 / 一个 n-gram 片段)。
| 路线 | 草稿来源 | 草稿形状 | 每步草稿成本 | 典型接受率 | 实现复杂度 |
|---|---|---|---|---|---|
| draft model | 独立小模型自回归 | 链(或树) | 中(多次小前向) | 60%~80% | 高(双模型工程) |
| prompt lookup | 从 prompt 检索 n-gram | 片段 | 近零(纯 CPU) | 10%~90%(强负载相关) | 极低 |
| Medusa | 主模型加多个并行头 | 树(笛卡尔积) | 低(一次主前向) | 50%~70% | 中(要训头) |
| EAGLE | 主模型特征层加轻量头 | 树 | 低 | 65%~85% | 中高 |
| MTP | 主模型训练时内置预测头 | 链/短树 | 低 | 55%~75% | 低(模型自带) |
| tree attention | 验证侧内核,不是独立路线 | 树 | 零(验证技巧) | 提升等效接受长度 | 中高(内核改造) |
表里最后一行要特别说明:tree attention 严格说不是「一条路线」,而是验证侧的通用基础设施——Medusa、EAGLE 这些产树形草稿的路线,都必须配 tree attention 内核才能在一次前向里验证整棵树(给每个树节点算合法因果掩码,让同层兄弟节点互不可见)。把它单列出来,是因为选型时「要不要为树形草稿改造内核」是一个独立的决策点,细节见 tree attention 草稿验证内核。

上图是版图的骨架:三根来源分支汇到两种草稿形状。从这张图可以直接读出一个反直觉的结论——路线之间不是互斥的,是可以叠加的。draft model 也可以产树形草稿,Medusa 头也可以挂在 draft model 上,prompt lookup 可以和其他路线混跑兜底。真实生产系统里,「开哪几条、各占多少流量」往往比「选哪一条」更接近实际问题。
三、逐路线拆解:机制、甜头与暗坑
3.1 draft model:最经典也最重的路线
独立小模型(比如用 7B 给 70B 当草稿)自回归生成 k 个 token,大模型一次前向并行验证。机制最直白,接受率也最有保障——小模型和大模型同源蒸馏时,逐 token 接受率能到 70% 以上。但它是六条路线里工程负担最重的:要维护两个模型的权重、两套 KV cache、两个 tokenizer 必须严格对齐(词表不一致时还要做 token 级别的对齐转换),小模型的自回归草稿本身是串行的,k 步草稿就是 k 次小前向延迟,batch 大时小模型还会和大模型抢带宽。训练侧的门道——蒸馏温度、数据配比、草稿长度调优——见 投机草稿模型训练。
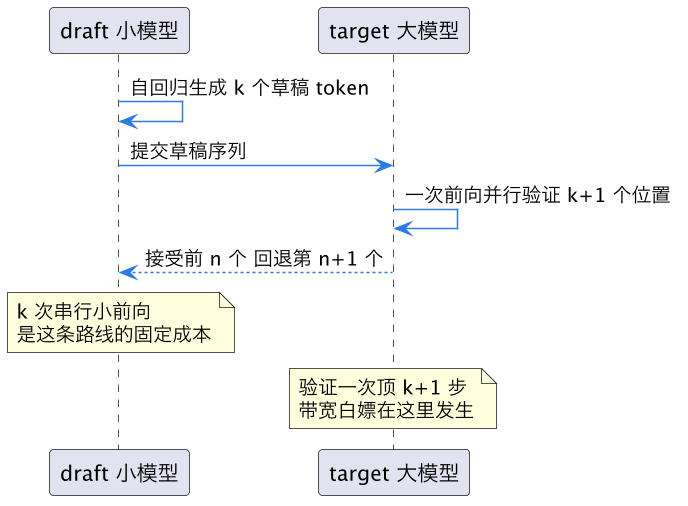
上面这张时序图把 draft model 路线的成本结构画清楚了:左边的 k 次串行小前向是雷打不动的固定开销,右边的一次并行验证是收益来源。净加速比 = 平均接受长度 × 大模型单步耗时 /(k × 小模型单步耗时 + 大模型单步耗时)。这个公式直接给出小模型尺寸的甜点:太小了接受率崩,太大了草稿成本吃掉收益,主流配置是目标模型参数量的 1/10 到 1/20。
3.2 prompt lookup:零训练的白嫖路线
思路朴素到极致:正在生成的文本很可能重复 prompt 里已有的片段,那就直接在 prompt 里做 n-gram 匹配,把匹配到的后续片段当草稿。没有任何模型、没有任何训练,草稿成本是一次 CPU 字符串检索,可以压到微秒级。代价是接受率完全由负载决定:代码补全(大量重复上下文)、文档续写、多轮对话里复读 system prompt 的场景,接受率奇高;开放域闲聊,接受率可能低到 10%,开投机反而拖慢。完整的负载适配分析见 prompt lookup 解码。
这条路线有两个工程细节常被忽略。其一是检索窗口的选择:在全 prompt 里检索随着上下文变长会变慢,实践中通常只在最近几千 token 的滑窗里匹配,或者用哈希索引把 n-gram 查找摊到常数时间;窗口太小则命中率下降,甜点窗口一般在 2k~8k token 之间,按负载标定。其二是它和采样温度的交互:prompt lookup 给的草稿是确定性片段,在贪心解码下几乎百发百中,但在高温采样下,即使草稿「语义正确」,只要采样出来的 token 和片段不一致就算拒绝——所以高温负载上它的实际接受率会比直觉低一截,标定时要用真实采样参数测,不能用贪心测出来的数字外推。
3.3 Medusa 与 EAGLE:把草稿头焊在主模型上
Medusa 的思路是:与其外挂一个小模型,不如在主模型最后一层上加 k 个并行预测头,第 i 个头专门预测第 t+i 个 token。一次主模型前向同时产出 k 个头的分布,笛卡尔积展开成一棵候选树,用 tree attention 一次验证。草稿零额外前向,这是它相对 draft model 的核心优势。EAGLE 更进一步:它观察到 Medusa 各头独立预测丢失了序列依赖,于是改在特征层(hidden state)上做轻量自回归——把主模型的中间特征和已生成 token 的 embedding 喂给一个小头,串行猜 k 步但每步成本极低,预测精度显著高于 Medusa 的纯并行头,接受率普遍高 10~20 个百分点。两条路线的头结构设计、训练配方和接受率实测对比,见 EAGLE 与 Medusa 投机头。

上图把 Medusa 和 EAGLE 的结构差异画在同一棵树上:Medusa 三个头并行、互相独立(各猜各的,组合成树靠笛卡尔积,深层位置准确率衰减快);EAGLE 一个头串行但每步吸收上一步信息(特征级依赖保住了,深层位置明显更准)。这就是为什么 Medusa 的树通常「宽而浅」、EAGLE 的树「窄而深」,而后者在同样的验证预算下平均接受长度更长。
3.4 MTP:训练时就内置的投机能力
MTP(Multi-Token Prediction,多 token 预测)把投机头直接做进预训练:模型训练时就带若干个预测未来 token 的辅助头,用辅助损失联合训练。推理时这些头白捡现成,不用任何事后训练。DeepSeek-V3 带火了这条路线。它的接受率通常略低于专门微调的 EAGLE(辅助头毕竟分了训练容量),但胜在「模型出厂自带」、部署成本最低——前提是你要部署的模型本身训了 MTP。机制与实测数据见 MTP 多 token 预测。
MTP 还有一个容易被低估的隐性收益:辅助头在预训练阶段同时充当正则项,强迫主干网络的中间表示里编码更长的前瞻信息,部分工作报告这对主任务质量本身有轻微正贡献。也就是说这条路线的账不能只算推理侧——对自研预训练的团队,MTP 是「训一次、推理永久受益」的投资;对只用开源权重的团队,它则简化成一道选择题:选型模型时把「是否带 MTP 头」列入比较维度,和上下文长度、许可协议放在一起权衡。
3.5 tree attention:验证侧的基础设施
链式草稿一次只能验一条,任何一个位置错了后面全废;树形草稿把「同一个前缀下的多个候选」打包成一棵树,一次前向验证所有分支,哪个分支对就走哪条,等效接受长度显著提升。代价是要给注意力算合法的树形因果掩码——同层兄弟节点互不可见、每个节点只看得见自己的祖先链,且 KV 布局要按树展平。这是内核级改造,vLLM、SGLang 等主流引擎已内置,自研引擎要自己写。收益上,树形相对链式在同样草稿预算下平均接受长度能再抬 20%~40%,是 Medusa/EAGLE 路线的必要伴侣。
四、负载决定一切:同一条路线在不同业务里的加速比差 4 倍
选型框架的第一原理:投机解码的加速比是负载的函数,不是路线的固定属性。同一个 Medusa 配置,在代码补全上能跑到 2.2 倍,在创意写作上可能只有 1.3 倍。四类典型负载的画像:
| 负载类型 | 输出特征 | 最佳路线 | 典型加速比 | 原因 |
|---|---|---|---|---|
| 代码补全 / 编辑 | 高重复、强局部模式 | prompt lookup 或 EAGLE | 1.8x~2.5x | n-gram 命中率极高,预测性强 |
| RAG 问答 | 复读检索片段 | prompt lookup + Medusa | 1.6x~2.2x | 答案大量摘自上下文 |
| Agent 工具调用 | 结构化 JSON、模板化 | EAGLE / MTP | 1.7x~2.1x | 格式固定,token 可预测性高 |
| 开放域闲聊 / 创意写作 | 高熵、低重复 | draft model 或 EAGLE | 1.3x~1.7x | 只有语义级可预测,n-gram 失灵 |
还有两个全局变量会整体压缩所有路线的收益,选型前必须先量:
第一,batch size。投机利用的是「小 batch 时 decode 的算力闲置」,batch 越大,decode 越接近计算受限,验证 k 个候选的额外算力从「白嫖」变成「实付」。经验拐点:batch 到 32~64 以上,多数路线加速比掉到 1.2x 以内,吞吐优先的离线场景干脆关掉投机更划算。
第二,输出长度与温度。温度越高、输出越发散,接受率越低;贪心解码下接受率显著更高。对高温采样负载(创意类 API),要么调小草稿长度 k,要么干脆只开 prompt lookup 这种零成本路线。
第三,投机与 KV cache 显存的争抢。树形草稿验证时,候选分支的 KV 要临时驻留显存,验证完再裁剪掉拒绝的分支。在长上下文、大 batch 的服务里,显存本来就是最紧的资源——为投机预留的临时 KV 空间会压缩可并发请求数,吞吐侧的损失可能抵消延迟侧的收益。这也是为什么「端到端加速比」不能只看单请求延迟:对按吞吐计费的服务,应该用「单位显存单位时间的 goodput」作为投机的验收指标。接受长度怎么测、显存怎么核算,指标口径统一见 接受率与接受长度。

上图是选型框架的入口决策树。它的读法是自上而下一层层过滤:先用负载特征筛掉必然不划算的选项(大 batch 离线场景直接出局),再在剩下的候选里按实现预算排序。三个问题任何一个答错,后面的路线对比都是白做——把 prompt lookup 部署到开放域闲聊上、或者给 256 batch 的离线打分任务上 EAGLE,是选型阶段最高发的两类错误。
五、落地决策框架:先白嫖、再小训、再重投入
把前面的版图和负载分析收敛成一条可执行的渐进路径。核心思想是按投入排序,每一级都先验证接受率再升级:

上图这条阶梯有几个执行要点值得展开:
第 0 级是大多数团队跳过的,也是最不该跳的。在真实流量上埋点统计「输出 token 与 prompt 的 n-gram 重合率」「相邻 token 的预测熵」,一天的数据就能告诉你这个业务的投机上限在哪。重合率高的业务,prompt lookup 一级就可能吃掉大半收益,后面三级都不用做了。
第 1 级到第 2 级的跳跃是性价比最高的。如果你部署的模型本身带 MTP 头(比如 DeepSeek-V3 系),这一步是纯配置开关;不带的话,Medusa 头的训练是轻量的——冻结主模型、只训几个小头,几张卡跑几天就够。训练配方踩坑记录见 EAGLE 与 Medusa 投机头 和 投机草稿模型训练。
第 3 级的门槛在内核不在模型。EAGLE 本身不难训,难的是生产引擎要支持树形草稿的高效验证。用 vLLM/SGLang 的团队这一步相对平滑,自研引擎的团队要诚实评估内核改造成本——tree attention 草稿验证内核 里有掩码布局和 KV 展平的完整工程清单。
第 4 级只对特定团队划算。当你同时满足「模型尺寸很大(70B 以上)」「负载可预测性中等」「有蒸馏基础设施」三个条件,专属 draft model 的接受率上限才值回双模型工程的票价。7B 级别的模型给 7B 级别的模型当草稿是个常见误判——草稿成本直接吃掉收益。
最后是一个贯穿所有级别的纪律:投机配置要随负载灰度,不要全局一刀切。生产上成熟的做法是按路由分流——代码补全流量走 prompt lookup 加 EAGLE、创意写作流量只开短 k 的 MTP、离线批处理直接关投机。路由判据就用第四节的负载三问,实现成本不过是一个请求分类器,但它让每条路线都跑在自己的甜点负载上,整体集群的等效加速比往往比「全流量上最强路线」还要高。
另外三类高频踩坑集中提醒,都是真实部署里反复出现的。第一,用论文的接受率数字做容量规划——论文多在短上下文、小 batch、特定数据集上测,生产数字通常打七到八折,规划时一律按实测口径重测。第二,灰度期只看 P50 延迟——投机对 P50 提升明显,但验证失败的步会引入额外抖动,P99 可能恶化,验收必须带全分位延迟。第三,升级模型版本后忘记重标定——主模型换权重、换分词器、甚至换推理引擎版本,接受率都会漂,投机配置应纳入模型发版的回归清单,而不是「配好一次永久生效」。
这一篇在知识体系里的位置
本篇是投机解码专题的枢纽:向上,它假设你已经理解 decode 的带宽瓶颈与 KV cache 机制(背景见 投机解码推理加速);向下,六条路线各自有一篇长尾深文承接细节——指标口径看 接受率与接受长度,头的训练看 EAGLE 与 Medusa 投机头 和 投机草稿模型训练,零训练路线看 prompt lookup 解码,出厂自带路线看 MTP 多 token 预测,内核改造看 tree attention 草稿验证内核。读完本篇你应该能回答「我的负载该先上哪条路线」,再带着这个问题去对应长尾文里抠实现。
总结
投机解码的六条路线共享同一个地基——decode 的算力闲置让「一次前向验证 k 个候选」近乎免费——它们的差别只在谁来起草、猜成什么形状、猜错亏多少:draft model 接受率最高但工程最重,prompt lookup 零训练但只吃高重复负载,Medusa/EAGLE/MTP 把草稿头焊进主模型各擅胜场,tree attention 是树形草稿的验证底座;选型的正确顺序不是比论文数字,而是先测负载重复度与 batch 形态,再沿「prompt lookup → MTP/Medusa → EAGLE → draft model」的阶梯逐级验证接受率,哪一级实测加速比跌破 1.15x 就停在哪一级。