跨层注意力 KV 共享:CLA 与 YOCO 的显存收益和质量边界
更新时间:2026-10-04。前面 GQA 与 MQA 的 KV 节省 讲过怎么在一层之内让多个 query 头共享 KV 头,MLA 多头潜在注意力 讲过怎么把一层里的 K、V 压成一个低秩潜在向量。这两条路都是「层内压缩」——每一层仍然有自己的一份 cache,只是这份 cache 变瘦了。跨层注意力 KV 共享(cross-layer attention KV sharing)换了一个正交的方向:能不能让相邻几层干脆共用同一份 K、V? CLA(Cross-Layer Attention)和 YOCO(You Only Cache Once)是这条路线的两个代表,前者让层两两结对共享,后者更激进——全网络只算一次全局 KV,后面所有层轮流复用。长上下文时代 KV cache 是显存第一大头(见 KV cache 推理显存),这条路线的收益直接而粗暴:cache 总量除以共享层数。本篇把机制、收益账本和质量边界讲透。
本文要回答的问题
- 跨层 KV 共享到底共享了什么,它和 GQA、MLA 的层内压缩是什么关系?
- CLA 的「层结对」具体怎么结,KV 总量能省多少?
- YOCO 的「只缓存一次」是怎么做到全局复用的,decoder-decoder 结构长什么样?
- 共享之后质量掉不掉,边界在哪里,哪些层最不能共享?
- 工程上怎么把跨层共享和层内压缩、KV 量化叠加使用?
一、为什么层内压缩之后还要跨层:KV cache 的账还有一层结构
先回忆 KV cache 的总量公式。设模型 L 层、每层 KV 头数 h、头维度 d、序列长度 n、batch 为 b、每个元素 b_bytes 字节,那么全模型 cache 总量正比于:
总 KV 字节 = 2 × L × h × d × n × b × b_bytes
GQA 把 h 从几十压到几(比如 64 头 query 配 8 头 KV,h 缩小 8 倍);MLA 把每层的 K、V 合成一个低秩向量,等效于把 h×d 这一项压掉一个数量级。但注意这两项都动不了公式里的 L——层数这一维,层内压缩一点办法都没有。一个 80 层的模型,就算每层 cache 压到极致,80 份瘦 cache 叠起来仍然按层数线性增长。
跨层共享盯上的正是 L 这一维。它的出发点是一个经验观察:相邻层算出来的 K、V 高度相关。每层的输入都是上一层输出加残差,逐层变化平滑,注意力关注的模式(缩进结构、指代、分隔符)在相邻层之间大量重复。既然内容像,就没必要各存一份。理论上把共享因子记作 s(每 s 层共用一份 KV),总量公式变成 2 × (L/s) × h × d × n × b × b_bytes——s=2 再砍一半,配合 GQA 的 8 倍,合计就是 16 倍。

上图把三条压缩路线放到同一个公式里:GQA 压头数、MLA 压头数乘头维、跨层共享压层数,三者作用在不同因子、互不冲突。这也是为什么 2025 年之后的长上下文模型设计普遍是组合拳——GQA 打底,跨层共享或 MLA 二选一甚至叠加,再上 KV cache 量化 压 b_bytes,每一项各管一个因子。
二、CLA:让相邻层两两结对,共享那一层的 K 和 V
CLA(Cross-Layer Attention,2024 年由 Character AI 团队公开)的做法非常直白:把 L 层分成 L/s 组,每组 s 层,组内只有第一层正常算自己的 K、V 并写入 cache,其余 s-1 层不算 K、V,直接拿组内第一份来用。最常见配置 s=2,即 1、2 层共用,3、4 层共用,依此类推。
被共享的层不是「跳过注意力」——它的 query 照常从自己的隐状态算出来,照常做注意力、过 FFN、更新表示,只是 K、V 投影矩阵不训练也不用,注意力打分用的是结对层提供的 K、V。也就是说每一层仍然有自己独立的「提问方式」,只是大家查阅的是同一本「台账」。
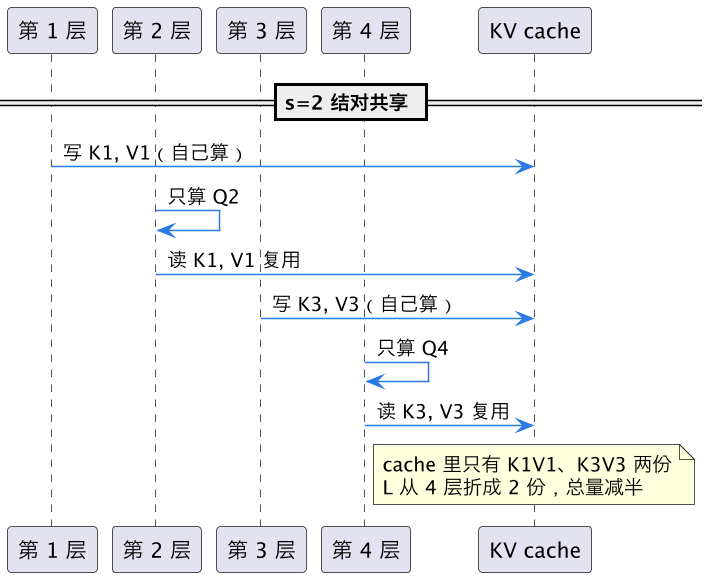
图中可以看到 s=2 时 cache 里实际只落了一半层数的 KV。CLA 论文的实测是:s=2(即 KV cache 减半)在 1B 到 7B 尺度上,下游任务精度基本无损,perplexity 略微上升但落在噪声区间;配合 MQA 一起用,KV cache 可以压到原始 MHA 的 1/16 而质量仍可用。这个「减半几乎免费」的结果是跨层路线能成立的核心证据。
还有一个训练侧的细节值得一提:被共享层虽然不写 cache,但它的 Q 投影、注意力输出投影、FFN 全部照常训练,参数量并没有省——CLA 省的是推理期的显存和访存带宽,不是模型体积。这对 decode 阶段尤其重要,因为 decode 是访存受限(memory-bound)的:每生成一个 token 都要把整份 KV cache 从 HBM 读一遍,cache 减半意味着每步的 KV 读取量减半,在小 batch 场景下吞吐提升可以接近线性的 1.5 到 1.8 倍。也就是说 CLA 的收益是双份的——既能塞下更长的上下文,又让每个 decode 步更快,这是纯显存手段(如 offload)给不了的。
但结对不是随便结的,有两个细节决定成败。其一,组内谁当「主层」:主流做法是组内第一层算 KV,因为它离原始输入更近、表示更「通用」;也有变体让每层都算 KV、组内取平均或拼接后共享,质量更好但 cache 省得少。其二,前几层和最后一层不适合共享:底层的注意力模式还在成形(位置、语法骨架),顶层直接服务输出头,这两处的 K、V 个性化程度高,硬共享掉点明显。实务配置常是「头尾各留几层独享,中间层两两结对」。
三、YOCO:只缓存一次的全局 KV,和只查它的 decoder 层
YOCO(You Only Cache Once,微软 2024 年提出)比 CLA 激进一个量级:整个模型只为「全局注意力」算一份 K、V,其余所有层都不产生新的全局 KV。它的结构把网络劈成两半。
前半段是一个「高效 decoder」,层内用滑动窗口注意力(sliding-window attention,只看最近 w 个 token)或线性注意力——这些机制的 cache 要么固定大小(窗口就 w 个槽位,与序列长度无关),要么是个常数维的状态向量,总之不随 n 增长。后半段是一个「全局 decoder」,每一层做全序列注意力,但它的 K、V 全部来自前半段末尾统一算出、只缓存一次的那份全局 KV——后半段的层只出 query。

这套结构的显存账很漂亮。传统 L 层模型的全局 cache 随 n 线性涨、随 L 线性涨;YOCO 里随 n 线性涨的只剩一份全局 KV,其余 cache 要么常数(窗口、状态)要么干脆不存在。论文给的数字:1M token 上下文下,YOCO 的 GPU 显存占用约为同规模 Transformer 的十几分之一,prefill 时间也因为前半段不用维护全序列 cache 而大幅缩短。配合 chunked prefill 与 PD 分离 这类调度手段,长上下文服务的成本结构被整个改写。
YOCO 与 CLA 的关系可以这样理解:CLA 是「局部结对」,共享因子 s 通常 2~4,超了就掉点;YOCO 是「全局共享 + 结构补偿」——它敢让全局 KV 只算一次,是因为前半段的窗口注意力把局部细节已经消化掉了,后半段只需要在全局台账上做粗粒度检索。共享越激进,就越需要架构本身补偿信息损失,这是两条路线的本质差异:CLA 不改架构、代价是共享浅,YOCO 改架构、换来了极致共享。
四、质量边界:共享到哪一层开始掉点
跨层共享的收益清晰,真正的问题只有一个:质量什么时候扛不住。把社区实测和各家论文的数据拉在一起,边界大致是下面这张表。
| 方案 | KV 压缩倍率(相对 MHA) | 质量表现 | 备注 |
|---|---|---|---|
| GQA(8:1) | 8× | 几乎无损 | 层内基线,业界默认 |
| CLA s=2 + GQA | 16× | 基本无损,perplexity 微升 | 最稳的跨层档位 |
| CLA s=4 + GQA | 32× | 短任务可,长程检索任务可见下滑 | 共享跨度是敏感旋钮 |
| YOCO | ~L× 全局部分 + 常数局部 | 3B 内对标 Transformer 持平 | 需从头训练,改架构 |
| CLA + MLA 叠加 | 视配置 50× 以上 | 数据有限,趋势乐观 | 正交叠加区 |
从表里能读出三条规律。第一,s=2 是甜区:cache 减半换的质量损失在多数评测里测不出来,超过 s=4 之后,需要跨层精细追踪的任务(长程检索、多跳推理、needle-in-haystack 式测试)开始稳定掉分——这些任务恰恰依赖中间层各自维护稍有差异的注意力视角,全共享等于把视角抹平。第二,位置敏感:底层(约前 1/4)和顶层(约最后 1~2 层)共享的代价比中间层高得多,因为它们承载的表示最独特。第三,从头训练比事后改造稳:CLA、YOCO 的论文结果都建立在预训练阶段就启用共享的前提上;拿一个已经训好的 MHA 模型事后嫁接跨层共享,掉点明显更大,通常需要继续训练几百亿 token 才能找补回来。
上图概括了质量边界的走向:不改架构时 s=2 几乎免费、s=4 是悬崖边缘,再往上就必须像 YOCO 那样用结构换空间。这给工程选型一个清晰的分界线——存量模型改造用 CLA s=2,新模型预训练可以认真考虑 YOCO 式结构。
评测口径上还有一个坑要提醒:常规的 perplexity 和 MMLU 这类短上下文榜单对跨层共享非常不敏感,s=4 都能刷出「无损」的假象;真正把共享打回原形的是长程检索类测试——大海捞针(needle-in-haystack)、多文档多跳问答、长代码库跨文件引用。选共享因子时必须用自己的目标场景长度做验证,拿 4K 上下文的评测结论外推 128K 部署,是这条路线上线事故里最常见的剧本。另外,共享层的位置选择也可以用数据说话:先跑一遍全量 cache 的基线,逐对计算相邻层 K、V 的余弦相似度,相似度最高的层对优先结对,比按固定顺序机械两两分组更稳。
五、工程落地:和层内压缩、量化怎么叠,cache 布局怎么变
跨层共享不是孤立开关,它落在 serving 系统里要回答三个工程问题。
第一个问题是叠加顺序。正确的姿势是每个因子各压一刀:GQA 把 h 压到 4~8,跨层共享把 L 折半,INT4 KV 量化 把 b_bytes 从 2 字节压到 0.5 字节。三刀叠完,总压缩倍率是三者乘积,80 层 GQA 模型配 s=2 和 INT4,cache 能压到原始 MHA FP16 的 1/64 上下。注意叠加时误差也叠加,压完要重新跑一次质量回归,不能拿单项的无损结论直接外推。
第二个问题是 cache 的内存布局。共享之后,多个逻辑层指向同一份物理 KV,PagedAttention 与 vLLM serving 的块表(block table)天然支持这种「多虚指一实」——让结对层共享同一组物理块号即可,refcount 管理现成的。麻烦出在 prefix caching(前缀缓存,多请求共享 system prompt 的 KV)和 KV offload(见 KV cache CPU 混合 offload):共享层的 KV 生命周期被多个层绑定,驱逐和换出要以「组」为单位,不能单层单独踢。
第三个问题是和 PD 分离的协同。YOCO 这类结构里前半段是窗口注意力、后半段是全局注意力,两段的 prefill 算力特征差异很大(前者近似线性、后者平方),在 prefill/decode 分离部署的集群上,分段放不同资源池是自然的延伸,调度器需要感知这个非对称结构。
上图展示了「多虚指一实」的映射关系:逻辑层数不变,物理 cache 份数减半,块表层的改动很小,主要工作量在生命周期管理。这也是为什么跨层共享在推理框架侧的落地速度比 MLA 快——MLA 要改 kernel(低秩投影、吸收矩阵乘法),CLA 只要调块表。
这一篇在知识体系里的位置
本篇是 KV cache 压缩谱系里「砍层数」的那一支:上游是 KV cache 推理显存(总量公式与显存压力的来源,本篇所有收益都建立在那个公式上);同层三支压缩路线互为对照——GQA 与 MQA 的 KV 节省 压头数、MLA 多头潜在注意力 压单层的表示维度、本篇压层数;横向协同的有 KV cache 量化(压字节数)、PagedAttention 与 vLLM serving(共享落地的块表机制)、chunked prefill 与 PD 分离(非对称结构的调度背景)。
落地建议一句话:存量模型、serving 侧求稳,用 CLA s=2 中间层结对,配 GQA 和量化三刀叠满;新模型从零训练且主打长上下文,YOCO 式「窗口层加一次性全局 KV」值得认真评估,它的显存曲线对百万级 token 是质变。
总结
跨层注意力 KV 共享是 KV cache 压缩谱系里唯一砍「层数」的路线:GQA 压头数、MLA 压单层维度,而 CLA 让相邻层两两结对共用一份 KV(s=2 时 cache 减半且质量基本无损,s=4 起长程任务掉分),YOCO 则更激进地用「窗口注意力前半段 + 全局 KV 只缓存一次」的改架构方案把随序列长度增长的 cache 压到一份——质量边界在共享因子和共享位置上(头尾层不能共享、中间层最皮实),工程上与 GQA、KV 量化正交叠加、靠 PagedAttention 块表「多虚指一实」落地,存量模型选 CLA s=2、新模型冲长上下文选 YOCO 式结构,是本篇给出的选型结论。