AXI 独占原子访问:从 AxLOCK 锁定移除到 ExOkay 两段式独占读写
更新时间:2026-09-25。多核 CPU、DMA、NPU 同处一条总线时,「读出—判断—写回」三步必须原子完成,否则两个核会同时拿到同一把锁。AXI4 的答案是独占事务。阅读本文前建议先看 AXI4 总线基础 了解五个通道,软件侧的背景见 硬件信号量与自旋锁 与 原子操作原理。
本文要回答的问题
- AXI3 的 AxLOCK 锁定事务为什么在 AXI4 被删掉?
- 独占读、独占写两段式握手怎么走,EXOKAY 和 OKAY 分别代表什么?
- 本地独占监控器(local exclusive monitor)标记什么、在什么条件下清除标记?
- 总线上别的主设备抢先写了同一地址,从机怎么发现、软件怎么重试?
- CPU 的 LDREX/STREX 如何映射成 AXI 独占事务,自旋锁代码长什么样?
一、AXI3 锁定事务:从机被「霸占」的旧办法
先看被淘汰的方案。AXI3 的 AxLOCK 是两位信号,编码如下:
| AxLOCK[1:0](AXI3) | 含义 |
|---|---|
| 00 | 普通事务 |
| 01 | 独占事务 |
| 10 | 锁定事务(locked) |
| 11 | 保留 |
锁定事务的语义是:主设备发起一笔锁定突发后,互连必须把通往目标从机的路径一直占住,后续事务全部视为同一原子序列,其他主设备一律不得插入,直到主设备发来一笔解锁(普通)事务。它确实保证了原子性,代价却很沉重。
第一,互连里的仲裁器、多路器必须维护「锁定通道」状态,Crossbar 在锁定期间退化成分用总线,其他主设备哪怕访问的是另一个从机也可能被牵连阻塞。第二,锁定可以持续很多拍,恶意或出错的主设备能长期霸占从机,服务质量(QoS)无从谈起。第三,锁定状态穿过多级互连时实现复杂,一旦中途出现异常响应,解锁点很难界定。
AXI4 直接把锁定事务删掉,AxLOCK 压缩成一位:0 是普通事务,1 是独占事务。需要的原子性改由「独占读 + 独占写」两段式完成——从机不再被霸占,互连在两次访问之间照常服务其他主设备,冲突由从机侧的监控器判定。
这张对比图点出了设计哲学的转变:原子性的保证点从「通路互斥」移到了「从机记账」。总线是自由的,只有从机内部那一小块监控逻辑知道有一笔未完成的原子序列。
二、两段式独占:独占读登记,独占写验收
AXI 独占原子访问由一对事务组成,中间可以隔任意多拍,主设备甚至可以先去做别的计算。
第一段:独占读(exclusive read)。 主设备在 AR 通道把 ARLOCK=1,带上 ARID、地址、突发长度与大小。支持独占的从机收到后并不锁总线,只是把这笔访问登记到独占监控器里,然后在 R 通道返回数据,RRESP=EXOKAY(独占正常),表示「我记下了,你可以来试写」。
第二段:独占写(exclusive write)。 主设备完成本地计算后,在 AW 通道发起 AWLOCK=1 的写,要求 AWID 与独占读的 ARID 相同,地址、大小、突发类型也必须一致。从机查监控器:
- 自独占读以来,没有任何写碰过被监控的地址区域——写入正常执行,B 通道回
BRESP=EXOKAY; - 期间有别的写改过该区域——写入被拒绝,存储内容原样不动,B 通道回
BRESP=OKAY(普通正常),这就是失败信号。
注意一个反直觉的细节:独占成功回的是 EXOKAY,失败回的反而是 OKAY。OKAY 本身不是错误响应,它在独占语境下的含义是「写没执行,请重试」。这与总线错误(SLVERR/DECERR)要区分开,错误处理见 AXI 错误响应与总线超时。
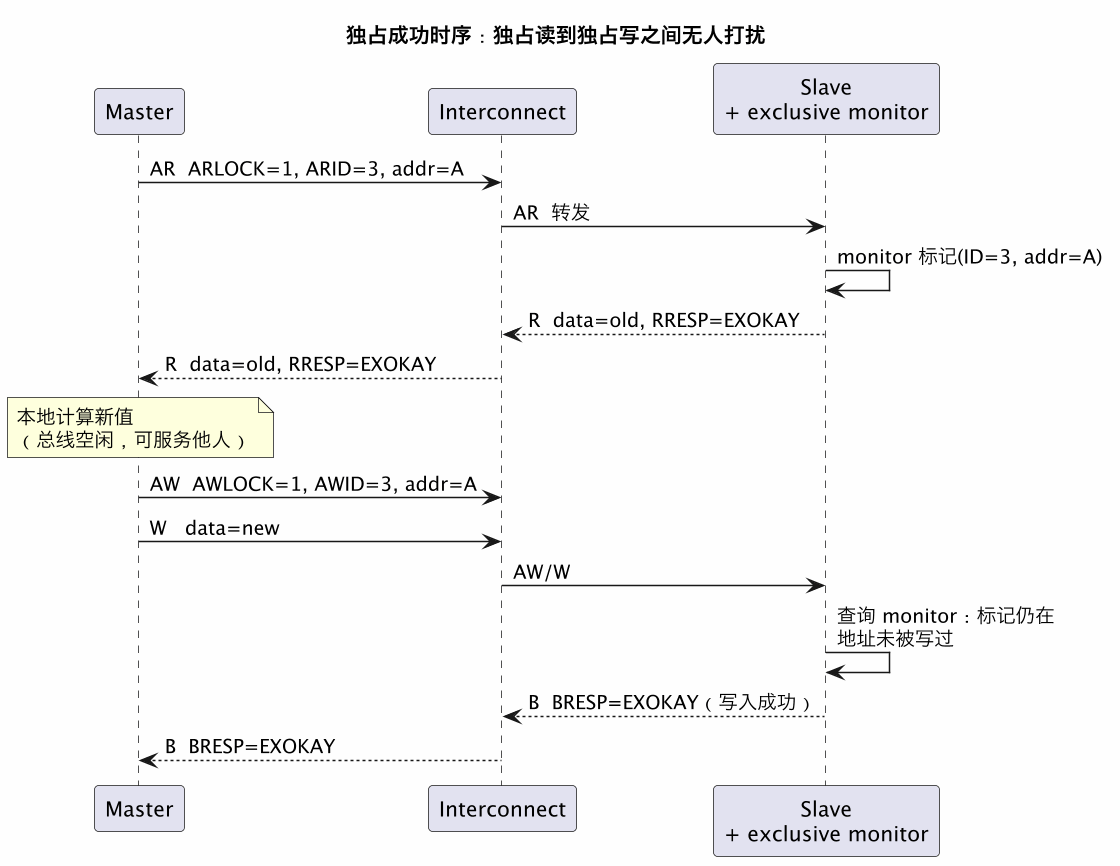
读图抓三个要点:独占读完成后监控器里留下一条标记;中间段总线完全空闲,没有任何锁定动作;独占写命中标记后才真正落盘,并回 EXOKAY。对主设备来说,这就是一次「带条件的写」——条件是自上次读取后无人改过。
还有一种退化情形要知道:如果从机不支持独占,独占读会直接回 RRESP=OKAY。此时协议保证后续独占写也只会当普通写处理(写入必然执行并回 OKAY),主设备必须明白这把「锁」并没有互斥效果,软件通常应避免对这类从机使用锁,或在系统集成时保证其只被单主设备访问。此外,独占突发只允许 INCR 类型,长度必须是 2 的幂(1、2、4、8、16),首地址按突发总字节数对齐——这些约束让监控器只需对齐记录高位地址,不必为任意长度的非对齐序列维护复杂状态。
协议对纯写从机(write-only slave,无法先被读)还有一条专门规定:这类从机收到独占写时可以直接执行写入并回 EXOKAY,因为它本就无从建立「读后是否被改」的语义,调用方必须在更高层自行保证正确性。普通可读写存储(SRAM、DDR 控制器)则严格遵循前面的两段式流程。
三、本地独占监控器:标记什么,何时清除
独占机制的全部硬件核心,就是从机接口里这块面积很小的监控器。它至少为每个未完成的独占序列记录三项内容:
| 记录项 | 来源 | 作用 |
|---|---|---|
| 主设备标识 | AxID | 区分不同主设备的独占序列 |
| 地址(区域) | AxADDR | 判定后续写是否落在监控范围 |
| 字节选通/访问大小 | AxSIZE、AxLEN | 支持小于总线宽度的独占访问 |
监控资源是有限的,一个从机接口通常只有几个表项。新的独占读可以覆盖旧表项;表项耗尽时,从机有权让后来的独占写直接失败(回 OKAY)——协议允许监控器「因为任何原因」使独占写失败,因为失败的代价只是软件重试一次,不会损坏数据。
标记的清除条件是验证和设计中最容易写错的地方,共有四类:
| 清除条件 | 说明 |
|---|---|
| 该地址被任何写命中 | 任何主设备(含发起独占读的主设备自己的普通写)写到监控区域,标记立即失效 |
| 完成一次独占写 | 无论成功(EXOKAY)还是失败(OKAY),写响应发出后标记即被清除 |
| 复位 | 接口复位清空全部表项 |
| 表项被覆盖/淘汰 | 监控器资源有限,新独占读占用表项可挤掉旧标记 |
这张状态图把从机的行为压缩成四个状态:空闲、已标记、命中、失效。两个出口(命中与失效)最后都回到空闲,区别只在于写数据是否落盘、响应是 EXOKAY 还是 OKAY。需要强调,「任何写」不区分来源——这正是它能发现并发竞争的原因:第三个主设备哪怕完全不知道独占序列的存在,它的普通写也会把标记顶掉。
实际实现中,监控器很少逐比特记录地址,而是按一个对齐的保留粒度(reservation granule,例如一个缓存行大小的若干分之一)记录高位地址,低位译码出区间。这意味着两个不同但同区间的地址也可能互相干扰,使本可成功的独占写失败——这属于允许的「假失败」,软件重试即可,不影响正确性。
顺带区分两个容易混淆的概念。挂在从机接口上的这块表叫本地监控器(local monitor),它只能看到抵达该从机的事务。当多个 CPU 集群经过各自缓存访问同一内存时,集群之间还需要全局监控器(global monitor)配合一致性消息工作:一个集群的缓存把监控行改脏,即使没有写事务真正落到内存控制器,全局监控器也要让另一个集群的独占写失败。验证独占访问时必须先确认系统里的监控器放在哪一级,单从机 testbench 测通不代表多核场景行为正确。
四、竞争波形:别人抢先写了之后
把有竞争的时序完整走一遍,这也是 testbench 里必测的场景。
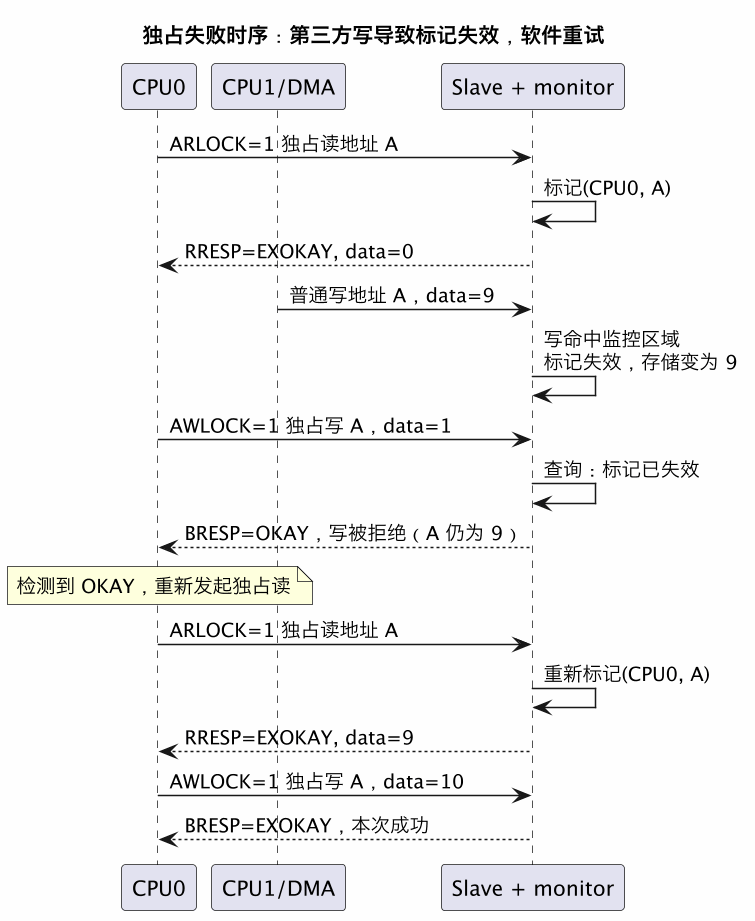
时序里有两个关键观察点。其一,CPU1 的普通写正常完成、数据落盘,总线自始至终没有停顿,CPU0 甚至在收到 BRESP 之前都不知道竞争发生过。其二,重试不是只重发写,而是从独占读整段重来:因为内存已经变成新值 9,CPU0 必须基于新值重新计算(新结果 10 是在 9 的基础上算的),否则会用陈旧数据覆盖他人的更新。
这也回答了为什么必须是两段式而不是单条原子指令:从机无法替主设备完成「基于读出的值做任意计算」这件事,它能做的只是在写回时验证「你读到的世界还在不在」。这与 MESI 缓存一致性 解决的问题互补——一致性保证缓存副本有序传播,独占事务保证多拍读改写序列不被穿插。
五、软件视角:LDREX/STREX 与自旋锁
ARM 程序里几乎不会有人手算 AxLOCK,CPU 的独占加载/独占存储指令直接映射到总线:LDREX 触发 ARLOCK=1 的独占读,STREX 触发 AWLOCK=1 的独占写,并把从机的成败转成一个状态位(成功写回为 0,失败为 1)。RISC-V 的 LR/SC 指令语义相同。底层映射关系如下:
| 软件动作 | 总线事务 | 失败信号 |
|---|---|---|
| LDREX/LR | ARLOCK=1 独占读,RRESP=EXOKAY | —— |
| 独占区间内本地计算 | 无总线活动 | —— |
| STREX/SC | AWLOCK=1 独占写 | BRESP=OKAY → 状态寄存器置 1 |
用它实现一把自旋锁的典型流程如下,分支节点全部是软件的条件判断:
对应的 C 风格伪码大致是:
while (ldrex(&lock) != FREE)       // 独占读:锁忙就重读
    wfe();                         // 可选:等事件,降低总线争抢
if (strex(&lock, TAKEN) != 0)      // 独占写:返回 0 才成功
    goto retry;                    // OKAY 响应 -> 整段重试
dmb();                             // 获取锁后的内存屏障
// ---- 临界区 ----
释放锁时执行屏障后把锁变量写回 FREE(普通写即可),并可用 SEV 唤醒自旋中的核。无锁信号量(计数初值大于 1)只是把「判断空闲」换成「判断计数大于零」、把置位换成「计数减一」,独占骨架完全相同。相比 邮箱与门铃 这类专门的 IPC 硬件,独占锁不需要额外 IP,只要内存支持独占访问就能工作,因此成为多核操作系统的默认同步原语,相关内存序要求见 写缓冲与内存屏障。
写这类软件有三个纪律:独占区间尽量短,不要在 LDREX 与 STREX 之间放访存、分支预测失败或异常返回(它们可能清空本地监控);失败必须从独占读重试,不能只重发写;竞争激烈时配合 WFE/退避,避免所有核把总线打成重试风暴。
六、验证与设计中的常见坑
- 独占读写的 ID 不一致:AWID 与 ARID 不同,从机查不到表项,独占写必然失败。跨 Crossbar 互连 时还要确认互连不会改写 ID。
- 地址/大小/突发参数不对齐:独占突发要求长度为 2 的幂、按突发总字节数对齐,读写两段参数必须一致,否则行为不可预测。
- 忘记四种清除条件:只考虑了第三方写,漏了「自己的普通写」「复位」「表项覆盖」,监控器状态机会在异常序列后残留脏标记。
- 把 OKAY 当成功或当错误:独占写返回 OKAY 表示失败需重试,既不是成功也不是 SLVERR;验证平台要按响应场景区分断言。
- 软件只重试写不重读:基于陈旧值重发写会覆盖竞争方的更新,必须整段重来。
- 监控粒度理解错误:相邻地址的写可能造成「假失败」,testbench 应覆盖同区间干扰,并断言数据正确性而非「不许失败」。
这一篇在知识体系里的位置
总线基础见 AXI4 Full 基础,简化子集见 AXI4-Lite 从机设计,突发类型与缓存属性见 AXI4 突发与 Cache,在途事务与 ID 保序见 outstanding 与 ID 排序。软件侧延伸阅读 硬件信号量与自旋锁、原子操作原理、MESI 缓存一致性 与 写缓冲与内存屏障。
总结
AXI 独占原子访问用「ARLOCK=1 独占读登记标记、AWLOCK=1 独占写验收」的两段式取代了 AXI3 霸占互连的锁定事务:本地独占监控器记录 ID 与地址区域,任何写命中、复位或表项覆盖都会使标记失效,失效后独占写拒绝执行并返回 OKAY,软件从独占读整段重试;LDREX/STREX 直接映射这一机制,以此实现不依赖额外硬件的无锁信号量与自旋锁。