FPGA 进阶 17:高速收发器使用——GTP/GTX/GTH、8b/10b 与 Aurora 入门
本文是
fpga/进阶层第 21 篇。链路速率到 几 Gbps 甚至几十 Gbps(光纤 SFP/SFP+、PCIe、SATA、JESD204 ADC、万兆网、背板互联)时,LVDS 源同步 那种「数据 + 随路时钟」的并行方式走不远、也凑不齐时钟,必须动用 FPGA 里的专用高速串行收发器(SerDes / Transceiver):Xilinx 7 系列按速率分 GTP / GTX / GTH / GTY,Intel(Altera)叫 GX transceiver / Tile。这篇讲清收发器的内部结构、8b/10b 编码、时钟换算,以及怎么用 Transceiver Wizard 和 Aurora 把一条高速链路快速跑起来。深水区(CDR 细节、预加重/均衡调参、64b/66b、眼图扫描)在专家层展开。
本文要回答的问题
- SerDes 和 LVDS 源同步本质区别是什么?为什么几 Gbps 必须用收发器?
- 收发器内部 PMA / PCS 各做什么?CDR 怎么在没有随路时钟时恢复时钟?
- 8b/10b 编码解决哪三件事?K 字符/comma 怎么用来做字节对齐?
- line rate、参考时钟(MGTREFCLK)、用户时钟(usrclk)怎么换算?
- 怎么用 Transceiver Wizard / Aurora IP 生成一条链路?复位初始化要注意什么?
- 上板怎么 bring-up、怎么测误码率和看眼图?
一、为什么需要 SerDes:内嵌时钟取代随路时钟
LVDS 源同步 的前提是「数据 + 一根随路时钟」一起走线、等长、同相位。速率继续往上走时这条路走不通:
- 每加一位数据就要多一对差分线,32 位就是 32 对 + 1 对时钟,PCB/连接器/光纤根本放不下;
- 几 Gbps 时 bit 间隔只有几百 ps,随路时钟和数据在走线/背板上的偏斜(skew)无法控制到一个 bit 以内;
- 光纤、变压器耦合、长背板没法传一个独立的低频时钟。
SerDes(Serializer/Deserializer)的核心思想:把时钟嵌进数据里。 发送端把并行字并成一路高速串行流,通过编码/加扰保证数据流里有足够多的跳变沿;接收端用 CDR(Clock Data Recovery,时钟数据恢复) 从这些跳变沿里「再生」出采样时钟,不再需要随路时钟。于是一对差分线就能传几 G~几十 Gbps。
| 对比 | LVDS 源同步(ISERDESE) | 高速收发器 SerDes |
|---|---|---|
| 时钟 | 随路时钟(BUFIO/BUFR 采) | 内嵌,接收端 CDR 恢复 |
| 线速率 | 几百 Mbps ~ ~1.5Gbps | 1Gbps ~ 几十 Gbps/lane |
| 走线 | 数据+时钟等长,多位多对线 | 一对差分线,可交流耦合/光纤 |
| 编码 | 无(或自定义训练字) | 硬件 8b/10b 或 64b/66b + 加扰 |
| 字对齐 | bitslip + 训练字 | comma(K 字符)自动对齐 |
| 信号调理 | IDELAY 调相位 | 发送预加重 + 接收均衡(DFE/CTLE) |
| 典型用途 | ADC、CMOS 摄像头、LCD | PCIe、SATA、SFP/光纤、JESD204、万兆网、Aurora 背板 |
经验分界线:单 lane 速率 ≳ 1.5~2Gbps、走光纤/背板/连接器、或要跑标准高速协议,就上 GTP/GTX/GTH;再快的 LVDS 也顶不住。
Xilinx 7 系列收发器按最高线速率分档(选型时查数据手册):GTP(Artix-7,约 3.2G,部分 6.6G)、GTX(Kintex-7,约 12.5G)、GTH(Kintex/Virtex 高规格,约 13.1G)、GTY(UltraScale,16~25G+)。
二、收发器内部结构:PMA 与 PCS
一个 lane(通道)分两大子层,理解这条分层就理解了所有信号从哪来:
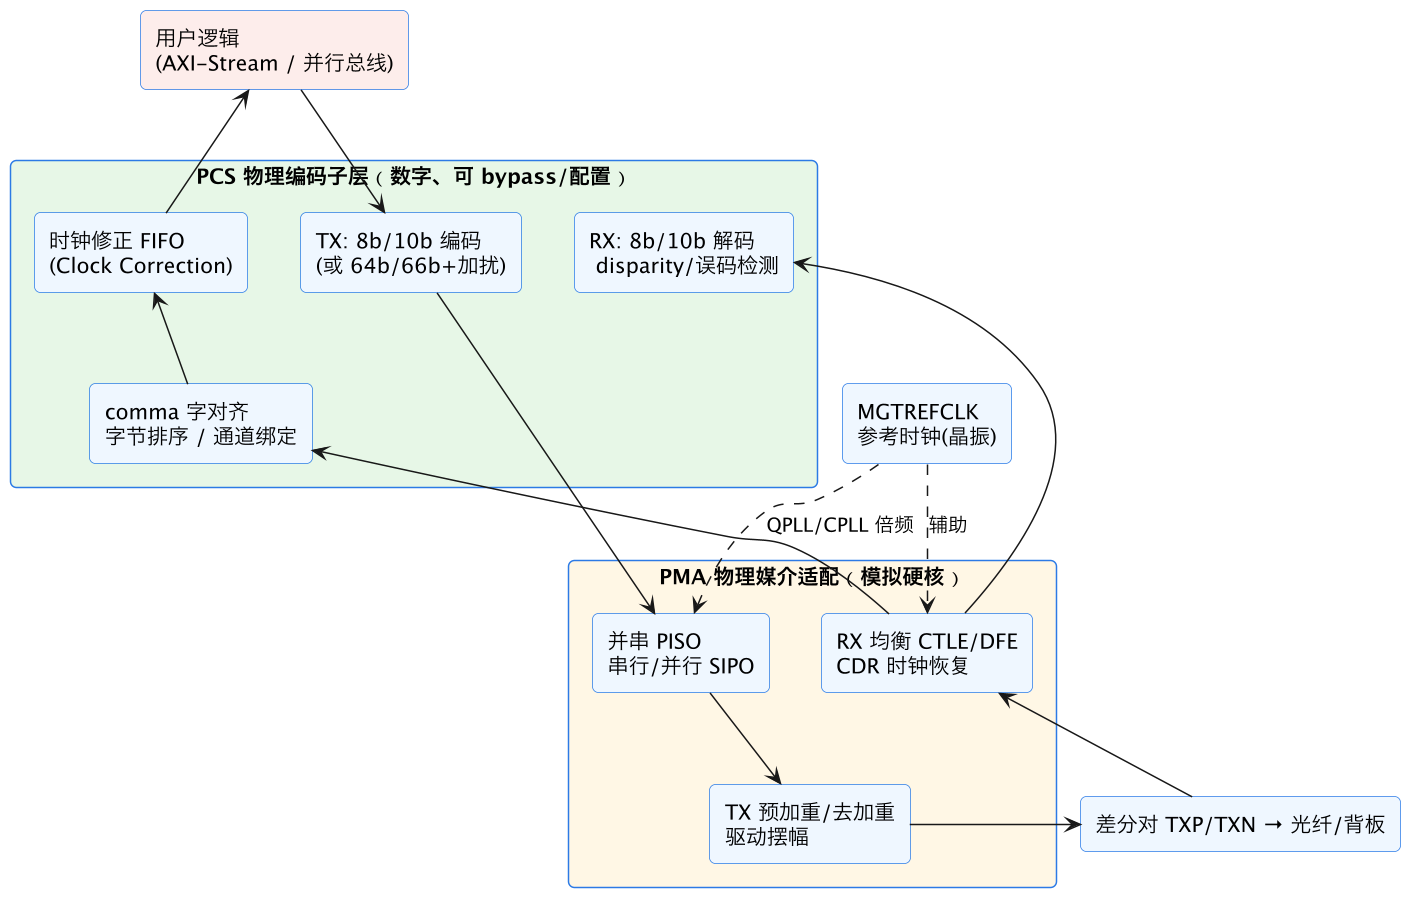
PMA(Physical Medium Attachment,模拟硬核) 负责「电信号 ↔ 串行比特」:
- PISO / SIPO:发送并串转换、接收串并转换(硬核,跑到线速率);
- CDR:接收端从数据跳变沿恢复出采样时钟,在眼图中心采样——这是「不用随路时钟」的关键;
- TX 预加重/去加重(pre-emphasis/de-emphasis)+ RX 均衡(CTLE/DFE):补偿高频损耗。背板/光纤对高频衰减大,发送端故意把跳变沿的高频分量加重、接收端再把高频抬回来并判决,把闭合的眼图重新打开;
- 差分驱动器/接收器:TXP/TXN、RXP/RXN,可交流耦合(隔直电容)。
PCS(Physical Coding Sublayer,数字、可配置甚至可 bypass) 负责「比特 ↔ 字节/协议」:
- 8b/10b 编解码(或 64b/66b + 加扰);
- comma 对齐:在串行比特流里找 K 字符(如 K28.5 =
0011111010,含独一无二的0011111比特图案),滑动字边界直到对齐,等价于 LVDS 那篇的 bitslip,但硬件自动做; - 字节排序 / 通道绑定(byte bonding):多 lane 传更宽总线时,把几条 lane 的字对齐到同一拍;
- 时钟修正 FIFO(Clock Correction FIFO):收发器恢复时钟和本地用户时钟频率有微小 ppm 偏差,靠双方周期性发的空闲字符(skip / K28.5)增删来吸收,防止 FIFO 溢出/抽空——这就是为什么链路空闲时线上也一直在跳变。
用户逻辑只碰到 PCS 外侧的并行接口(几十~几百 MHz),所有线速率的模拟/串行部分都被硬核和 PCS 挡住了。
三、8b/10b 编码:直流平衡、跳变密度、comma 对齐
直接把原始字节串行发出去有三个致命问题,8b/10b 一次解决:
- 直流平衡:数据可能连续一大串 0 或 1。交流耦合(隔直电容/变压器,光纤和背板必备)下基线会漂移、判决门限乱跑。8b/10b 把每 8bit 映射成 10bit,使 0/1 数量基本相等(运行差异 disparity 控制在 ±1),信号无直流分量;
- 保证跳变密度:CDR 靠跳变沿恢复时钟,长时间无跳变(如连发
0xFF)时钟就丢了。8b/10b 保证最长连 0/连 1 不超过 5 位,时钟始终能锁住; - 逗号对齐:编码空间里留出一批正常数据永远不会出现的 K 控制字符(如 K28.5),它含独一无二的比特图案,接收端在比特流里搜到它就确定了字节边界——硬件 comma detect 自动完成字对齐。
代价是 20% 开销(10bit 传 8bit 有效数据)。更高速率(≥10G)普遍改用 64b/66b(66bit 传 64bit,开销仅 ~3%),直流平衡和跳变改靠加扰(scrambling) 保证,帧边界靠 2bit 同步头,这属于专家层深水区。
四、时钟体系:line rate、参考时钟、usrclk
收发器有三套时钟,别混:
- line rate(线速率):串行差分对上的波特率,如
3.125 Gbps(Aurora/PCIe Gen1 常见)、10.3125 Gbps(万兆/10G Aurora); - MGTREFCLK(参考时钟):板上晶振给收发器的低抖动差分时钟,常见 125 / 156.25 / 200 MHz,经专用 MGTREFCLK 引脚进 QPLL/CPLL(收发器内部 PLL)倍频到线速率。参考时钟抖动直接决定链路质量,必须用低抖动晶振、走专用时钟引脚;
- usrclk(用户时钟 / 并行时钟):PCS 并行侧给用户逻辑的时钟,频率 = line rate ÷ 内部位宽。
换算(8b/10b、20bit 内部宽度为例):
line rate            = 3.125 Gbps
内部并行位宽(20bit)  → txusrclk = 3.125G / 20 = 156.25 MHz
有效数据(16bit/拍)   → 有效带宽 = 3.125G × (8/10) = 2.5 Gbps
Wizard 会按你填的 line rate 和数据宽度自动算出 usrclk 频率、并例化对应的 MMCM/PLL 给你这个时钟,用户只需把它接给 FIFO/数据通路逻辑,不要自己另设。用户侧数据通常再经异步 FIFO 跨到系统时钟域(CDC)。
五、怎么用起来:Transceiver Wizard 与 Aurora
实战中几乎没人手写收发器原语,都是调 IP。两条路线:
路线 A:裸收发器 —— Transceiver Wizard(Xilinx)/ Transceiver PHY(Intel)
适合要跑标准协议(自己接 PCIe、以太网、JESD204、SATA 控制器)或需要完全自定义。Wizard 让你选:line rate、参考时钟频率、编码(8b/10b / 64b/66b / raw)、数据位宽、逗号字符、是否用时钟修正/通道绑定、预加重与均衡初值。生成后给你的是一对并行 TX/RX 接口加一堆状态/控制信号,编解码、comma 对齐、CDR 都在 IP 内,你只需提供参考时钟、复位、并读回状态。
路线 B:Aurora —— 开箱即用的轻量串行链路协议(推荐做板间数据搬运)
Aurora 是 Xilinx 免费的链路层协议,直接跑在收发器上,把初始化、lane 上线、时钟修正、字对齐、多 lane 绑定、流控(NFC/UFC)、帧/流封装全包了,对外就是标准 AXI4-Stream 的 TX/RX:
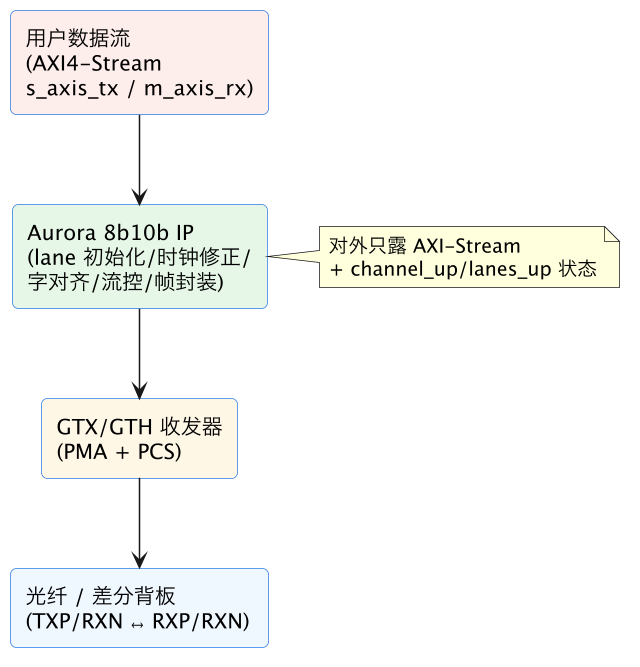
典型用法(两块 FPGA 通过光纤/背板传数据):
// Aurora 8b10b 用户侧(简化,AXI4-Stream 发送)
// tx 侧:s_axi_tx_tvalid/tready/tdata;rx 侧:m_axi_rx_tvalid/tdata
assign s_axi_tx_tvalid = tx_fifo_empty ? 1'b0    : 1'b1;  // FIFO 有数据就发
assign s_axi_tx_tdata  = tx_fifo_dout;
assign tx_fifo_rd_en   = s_axi_tx_tvalid & s_axi_tx_tready; // 握手才弹

// 链路就绪判断:channel_up=1 且 lane_up=1 才能收发
//   channel_up : 整条逻辑通道(含所有 lane)已对齐、可传数据
//   lane_up    : 各物理 lane 的 CDR 已锁定、字已对齐
always @(posedge user_clk) begin
  if (!channel_up) begin
    // 链路没好:丢数/复位本地 FIFO,别往里灌数据
    link_ok <= 1'b0;
  end else begin
    link_ok <= 1'b1;   // 上线后再放行数据流
  end
end
选型建议:
| 场景 | 选什么 |
|---|---|
| 两块 FPGA / FPGA↔ASIC 板间、背板、光纤搬数据,无标准协议约束 | Aurora 8b10b(≤~6G)或 Aurora 64b66b(更高速率) |
| 连电脑/交换机、走标准生态 | PCIe(进阶 19)/ 以太网 IP |
| 接高速 ADC/DAC(JESD204B/C) | JESD204 IP(内部也是收发器 + 8b10b/64b66b) |
| 需要自定义帧/自研协议 | Transceiver Wizard 裸 PHY,自己写链路层 |
收发器引脚是专用的:TXP/TXN、RXP/RXN 和 MGTREFCLK 只能绑定到器件的收发器 bank(GTH/GTX Quad),管脚必须在支持的引脚上,原理图和 XDC 要按收发器引脚约束,不能随便分配到普通 IO。
六、复位、初始化与状态信号
收发器上电后要经历一串硬件初始化顺序,复位时序不对是「链路起不来」的头号原因。Wizard/Aurora 已内置状态机,但你要理解并正确接复位:
- 参考时钟稳定 → 复位收发器(
gt_reset/reset); - 内部 PLL(QPLL/CPLL)锁定 →
qpll_lock/cpll_lock拉高; - 收发器释放复位、CDR 开始锁定、发 comma 做字对齐;
- 接收侧 CDR 锁定 + comma 对齐 →
lane_up(或rx_resetdone/tx_resetdone) 拉高; - 所有 lane 绑定/时钟修正就绪 →
channel_up拉高,此时才能收发数据。
要点:
- 复位要按 IP 给的复位方案接(Wizard 自带复位模块,照着 example design 连),不要自己用全局复位一把乱拉;
gt_reset一般要在参考时钟稳定后断言、保持足够宽度; channel_up变低(链路断)时必须停发/缓冲数据,恢复后重新对齐,期间数据会丢——上层要能容忍重传或清空 FIFO;- DRP(Dynamic Reconfiguration Port):收发器参数(线速率、预加重、均衡、极性)可在运行时通过 DRP 接口读写寄存器动态改,常用于速率切换、极性翻转(TXP/N 接反时
txpdrupireverse类设置)和眼图扫描; - 常见状态信号:
pll_lock、tx_resetdone/rx_resetdone、lane_up/channel_up、rxbyteisaligned(字已对齐)、rxdisperr/rxnotintable(8b/10b 解码错误,误码指示)。
七、上板 bring-up 与误码率/眼图调试清单
高速链路「通不通」最终看误码率(BER)和眼图,按下面顺序逐项点亮:
- 管脚/时钟:TXP/RXN 差分对在收发器引脚、MGTREFCLK 是低抖动晶振且频率与 Wizard 设定一致(先用 ILA/计数器测参考时钟频率);交流耦合电容、SFP 模块/光模块供电与 LOS 信号正常;
- PLL 锁定:
qpll_lock/cpll_lock拉高(不锁 → 参考时钟频率/引脚/抖动问题); - 复位完成:
tx_resetdone、rx_resetdone拉高; - 本端环回(loopback):先设收发器近段环回(near-end PMA loopback),自发自收,验证本端 PCS/PMA 和逻辑——环回能通说明 FPGA 侧基本没问题;
- 对端环回/对接:插光纤/背板对接,看
rxbyteisaligned→lane_up→channel_up依次拉高(卡在字对齐 → 查线速率/参考时钟/8b10b 设置/极性;channel_up不高 → 查时钟修正、多 lane 绑定); - 误码率测试:发 PRBS(收发器内置 PRBS 生成/校验,或发已知递增/随机数据),对端校验,跑几分钟到几小时统计误码。验收标准通常 BER < 1e-12(高速链路常见目标),长流量零误码;
- 眼图扫描:用收发器内置 IBERT(Integrated Bit Error Ratio Test)IP 或 DRP 眼图扫描,画出接收眼图——眼张开越大、裕量越足。眼图闭合/很窄 → 调 TX 预加重/摆幅 和 RX 均衡(CTLE/DFE),或查走线/连接器/光模块损耗;
- 拉偏验证:温度、电压拉偏复测,确认裕量不是刚好卡线。
IBERT 是专门用来测收发器的 IP:例化后可通过 JTAG 实时改线速率/预加重/均衡、跑 PRBS、扫眼图,bring-up 高速链路时第一个该例化的就是它,比直接上业务逻辑省大量时间。
八、链路预算与信号完整性:为什么「速率够」不代表「能通」
学会用 Wizard 生成收发器只是第一步,真正决定一条几 G~几十 Gbps 链路通不通的,是发端、通道、收端三者构成的链路预算(link budget)。低速并行设计里可以不太在意的损耗和抖动,在 SerDes 速率下都会变成实打实的误码。
先看通道损耗从哪来。高频信号在 PCB 走线、过孔、连接器、电容(交流耦合)和光纤/电缆上传播时,损耗随频率升高而增大,主要来自介质损耗、导体趋肤效应、过孔残桩(via stub)和阻抗不连续点的反射。一个 10Gbps 信号的有效频率成分到 5GHz 以上,普通 FR-4 板材走十几英寸可能衰减到收端无法判决。因此硬件选型阶段就要按目标线速率算预算:用插损(insertion loss)曲线确认整个通道在奈奎斯特频率处的 dB 损耗落在收发器能力之内,必要时换低损耗板材(Megtron 类)、做背钻(back-drill)去掉过孔残桩、优化连接器和 AC 耦合电容封装。这些是硬件工程师的活,但 FPGA 工程师必须看得懂结论,否则会把硬件通道不足导致的误码误判成逻辑 bug。
再看发端的预加重/去加重与收端的均衡。信号经过有损通道,高频分量比低频衰得更厉害,波形在收端变得又钝又晃。发端用预加重(pre-cursor)和去加重(post-cursor/de-emphasis)提前把跳变沿的高频能量加大,「预补偿」通道的频率相关损耗;收端则用连续时间线性均衡(CTLE)、判决反馈均衡(DFE)等把被压扁的高频成分抬回来。这些参数(摆幅 swing、预/后级 tap 系数)需要按具体通道调,Wizard 给的是通用默认值,余量不足时要结合 IBIS-AMI 仿真或上板眼图扫描微调。调参方向有规律:通道越损、速率越高,通常需要更强的均衡,但均衡过强又会放大噪声和串扰,存在最优点而非越大越好。
抖动(jitter)是另一条主线。 总抖动分为确定性抖动(来自码间干扰 ISI、周期性干扰如开关电源和邻近通道串扰、占空比失真)和随机抖动(器件热噪声等无界分量)。CDR 恢复出的时钟要在每个比特周期的最佳判决点采样,当抖动大到使采样点落入模糊区就产生误码。参考时钟质量(phase noise、jitter 指标)直接设进链路预算——用一颗廉价晶振跑 10G+,可能把预算里分配给时钟的那部分吃光。工程上要按收发器手册要求选满足指定 RMS/相位噪声指标的参考时钟,并注意电源噪声(尤其收发器供电)对抖动的贡献。
用工具把不可见的余量变成可见数字。 现代收发器提供片上眼图扫描(如 IBERT/眼图测量)、PRBS 误码测试、DRP 可读的均衡/锁定状态。bring-up 的标准做法是:先不接用户逻辑,用 IBERT 把两端配成 PRBS 互发互收,扫描得到眼图开度(眼宽、眼高)和误码率(BER)。眼图睁得开、长时间(按目标 BER,1e-12 需要海量比特)误码为零,再叠加用户协议。这样能把「物理层是否健康」与「上层逻辑是否正确」彻底解耦——直接在用户数据上调试,一旦出错,你根本分不清是 8b/10b、组帧、缓冲还是物理通道的问题。
记住那条铁律:SerDes 是模拟/混合信号电路,数字逻辑里「连上就能通」的直觉在这里失效。线速率标称值只说明收发器「能力上限」,实际能跑多少由通道、时钟、电源、均衡共同决定。在高速设计中尽早和硬件工程师一起做链路预算、预留 IBERT 调试阶段,能避免项目后期最昂贵的那类返工。
九、协议分层与 bring-up 实战:从裸收发器到稳定数据流
裸收发器只负责「把并行数据变成串行比特、在对端再变回并行」,它不懂帧、不懂包、不保证字节边界天然对齐。要让它承载真正的业务,需要在 PCS 之上逐层搭协议,并按固定顺序 bring-up。这一节给出一条可复用的分层与调试路线。
第一层:物理与复位。 确认参考时钟频率/质量、线速率、PLL 类型(CPLL 还是 QPLL,多 lane 共享时谁提供时钟)符合 Wizard 配置,按手册的复位序列处理——收发器不是上电即用,通常需要等待 PLL 锁定(qpll_lock/cplllock)、收发器复位(GTTXRESET/GTRXRESET)、再等待 TX/RX 复位完成(tx_resetdone/rx_resetdone)。复位时序写错,现象往往是链路时好时坏或完全不锁。多 lane 还要保证复位和初始化顺序一致,避免部分 lane 已工作、部分还在复位的竞态。
第二层:字节边界与对齐。 8b/10b 模式下,收端靠 comma(K28.5 等控制字符)在连续比特流中找到字节边界(byte alignment/word align),发端必须周期性发送对齐字符(如空闲时发 K28.5)。没对齐时收到的数据看似「有信号但全是乱码」,这是 bring-up 最常见的首道坎。多 lane 绑定时还要做 lane 去偏斜(bonding/channel bonding):各 lane 走线长度不等、延迟不同,同一个并行字在不同 lane 上到达有先后,协议用对齐字符(如 Aurora 的 /A/、/K/)让收端测量并补偿 lane 间偏斜,把多 lane 重新对齐成一个宽总线。若跳过 bonding,宽数据会在 lane 之间错位。
第三层:时钟修正(clock correction)。 收发两端各自有独立参考时钟,哪怕都标称 156.25MHz,实际也有 ppm 级差异,长期运行会导致收端缓冲慢慢溢出或读空。标准解法是在 PCS 里放一个弹性缓冲(elastic buffer),协议周期性发特殊的时钟修正字符(skip/Aurora 的 /R/),收端在缓冲将满/将空时插入或删除这些字符,把两边速率「拉平」。时钟修正配置错误(缓冲深度、修正字符间隔不匹配 ppm 差)会表现为链路跑一段时间后周期性报错或丢字节——短测正常、长测翻车,是它的典型特征。
第四层:链路与字符级协议。 在字节流之上定义控制字符与帧:K 字符区分数据与控制(如帧头、帧尾、流控),加校验/CRC 检错,定义空闲字符保证跳变密度和对齐维持。自研简单协议可直接用这些原语;更常见的是直接用 Aurora——它已把初始化、对齐、bonding、时钟修正、流控、单/多 lane、帧/流接口都做好,你只需面对一个类似 AXI-Stream 的用户接口,把精力放在业务上。再往上跑标准协议(PCIe、以太网、JESD204、SATA、Interlaken)时,通常用对应协议的专用核而非裸 8b/10b,但底层收发器的复位、时钟、均衡概念完全通用。
bring-up 的黄金顺序是自底向上、逐层锁死。 一,IBERT PRBS 验证物理层眼图和误码(不含任何协议);二,回环测试(near-end PMA loopback、near-end PCS loopback、far-end loopback)逐级定位是本侧收发器、本侧 PCS 逻辑还是对端/通道问题——回环能通而对接不通,多半是通道、时钟或两端配置不一致;三,确认 comma 对齐、字节序正确(注意字节/比特序,MSB/LSB 搞反会得到「有规律的错数据」);四,确认 bonding 和时钟修正长时间稳定(做 soak 测试,监控缓冲水位与复位/错误状态);五,最后才挂用户数据通路,先用简单递增图案/自环帧验证帧完整性和 CRC,再换真实业务。每一层都有明确的状态信号和错误计数(disparity error、not-in-table、CRC、buf error),把这些接进你的调试寄存器(参见 Debug IP 寄存器访问一篇),出问题时看「第一个报错出现在哪一层」,就能顺着协议栈快速定位,而不是对着乱码无从下手。
走完这条路线你会发现,高速串行开发的核心能力不是「会点 Wizard」,而是建立清晰的分层心智,并用每层自带的可观测信号把巨大的故障空间切成一段段可二分的小问题——这套自底向上、逐层去风险的方法,在 PCIe、以太网等更复杂协议的 bring-up 中同样适用。
十、从单链路到协议系统:PCIe / 以太网 / JESD204 的落地差异
掌握了裸收发器和通用分层方法之后,真实项目里几乎不会长期停在自研 8b/10b 协议,而是落到某个标准协议核上。这一节对比三类最常见协议在 FPGA 侧的落地形态,让你知道「SerDes 知识」如何映射到具体生态。
PCI Express:配置空间与协议复杂度最高的一类。 它不是简单的串行流,而是带枚举的总线:主机上电要进行链路训练(LTSSM 状态机)、枚举设备、分配 BAR 地址空间,FPGA 端的 PCIe 核暴露的是事务层接口(TLP,通常再经 XDMA/QDMA 转为 AXI-MM/AXI-Stream)。bring-up 的层级是:先确认链路训练成功(link up、协商到几代速率、x1/x4/x8 宽度),再确认主机能枚举出设备和 BAR(操作系统能否看到设备、驱动是否加载),然后才谈 DMA 数据传输。典型坑包括参考时钟架构(Common Clock 与否、SRIS)、复位(PERST#)时序、核的 IP 版本与驱动匹配、以及中断(MSI-X)配置。它的收益也最大——一条 Gen3 x8 就是双向十几 GB 级且复用主机生态,是加速卡和高速 trace 导出的首选。调试时善用核提供的调试状态、链路误码计数和 ILA 抓事务层接口,而不是一上来怀疑物理层。
以太网:分层最标准、调试工具最丰富。 1/10/25G 以太网的典型数据通路是「用户逻辑→MAC→PCS/PMA(收发器)」,MAC 负责帧、CRC、前导码,PCS 负责 64b/66b(10G 起替代 8b/10b,开销仅 3%)、块对齐和扰码。bring-up 顺序:物理层锁定后,先用 IBERT/PRBS 确认通道,再验证 PCS 块锁定(block lock)和链路,然后用环回帧或对接交换机的端口状态确认 MAC 层,最后才跑协议栈。以太网相对友好的一点是生态工具齐全——交换机端口计数、光模块 DDM 信息、抓包工具都能帮你区分是 FPGA 侧、光纤/铜缆还是对端设备问题。常见坑集中在参考时钟频点(156.25MHz)、光模块与线速率匹配、TX 极性/引脚以及 IP license。
JESD204B/C:确定性延迟和子类是核心。 这是 ADC/DAC 与 FPGA 之间的高速串行接口(数 G 到十几 Gbps 每 lane,多 lane 传输采样数据),最大特点是强调确定性延迟(deterministic latency)——每次上电、每次同步,数据经过链路的延迟必须相同,多片转换器和多 lane 之间还要严格对齐,因此引入了子类(Subclass 1 用 SYSREF 做确定性时序基准)、LMFC(本地多帧时钟)、同步字符和复杂的初始化序列(代码组同步→ILAS 初始通道对齐序列→用户数据)。落地时 bring-up 的关键不是眼图(那只是前提),而是 SYSREF/设备时钟的时序关系、LMFC 边界对齐、lane 间偏斜校正和延迟测量重复上电的一致性。这类接口通常必须严格照转换器厂商给出的参考设计和时钟芯片方案搭建,自由发挥空间小,但理解了 PCS、对齐、时钟修正这些通用概念后,手册里的每一步你都知道在解决哪个物理问题。
三者的共性与差异可以收束成一句话。 共性是底层都跑在同一类收发器硬件上,物理层的链路预算、参考时钟、复位锁定、眼图方法完全通用;差异在协议栈重心——PCIe 重在枚举/配置/DMA 等系统软件接口,以太网重在标准化帧与现成网络生态,JESD204 重在确定性延迟与多器件同步。选择策略上,板间/芯片间自定义数据搬运优先看 Aurora(省事),要进主机和服务器生态用 PCIe,要联网用以太网,接高速 ADC/DAC 用 JESD204。无论哪条路,自底向上、每层锁死再向上、用每层自带状态和计数做可观测性的 bring-up 纪律都不变。
常见坑对照
| 坑 | 后果 | 正确做法 |
|---|---|---|
| MGTREFCLK 用普通晶振/引脚不对 | PLL 不锁、抖动大、误码 | 低抖动晶振 + 专用 MGTREFCLK 引脚,频率与 IP 一致 |
| 线速率/参考时钟两端不一致 | 字对不齐、lane_up 不起 | 两端 line rate、refclk、编码、位宽完全一致 |
channel_up 没高就灌数据 | 丢数、FIFO 乱 | 等 channel_up/lane_up 拉高再放行 |
| TXP/N 或 RXP/N 接反/接错 lane | 链路死、错位 | 查原理图;可用 DRP 极性翻转/ lane 映射补救 |
| 复位没按 IP 方案接 | 时好时坏、起不来 | 照 example design 的复位模块接,时钟稳定后复位 |
| 预加重/均衡不调 | 背板/长光纤眼图闭合、误码 | IBERT 扫眼图调 TX 摆幅/预加重 + RX 均衡 |
| 收发器引脚当普通 IO 约束 | 实现报错/不过 | 只用收发器 bank 引脚,按 IP 约束 |
| 8b/10b 带宽按 line rate 满算 | 实际带宽差 20% | 有效带宽 = line rate × 8/10(64b66b 更高) |
相关与延伸
前置/配套:LVDS 源同步(源同步并行、bitslip,是理解 comma 对齐的基础)、CDC 与异步 FIFO(usrclk 跨到系统时钟域)、PCIe XDMA(跑在收发器上的标准协议)、千兆以太网 RGMII(更低速的并行源同步对照)。 深水区见专家层规划:收发器深水区(CDR/64b66b/预加重均衡调参)、Aurora 与高速串行协议、PCIe/以太网深水区。
一句话总结
几 Gbps 以上必须用 FPGA 专用高速收发器(GTP/GTX/GTH):它把时钟嵌进数据流、靠 CDR 恢复时钟,一对差分线跑几十 Gbps;内部分 PMA(并串转换、CDR、发送预加重/接收均衡)和 PCS(8b/10b 编解码、comma 自动字对齐、时钟修正 FIFO、多 lane 绑定)。8b/10b 同时解决直流平衡(交流耦合)、跳变密度(喂 CDR)、comma 字对齐三件事,代价是 20% 开销(更高速用 64b/66b)。时钟上分清 line rate(线速率)、MGTREFCLK(低抖动参考时钟经 QPLL/CPLL 倍频)、usrclk(=line rate÷位宽,给用户逻辑)。工程上板间搬数据首选 Aurora 8b10b/64b66b(对外就是 AXI4-Stream,初始化/对齐/流控全包),标准互通才用 PCIe/以太网;复位照 IP 方案、等 lane_up→channel_up 才放行数据。bring-up 顺序:参考时钟/PLL 锁 → 环回 → 对接字对齐 → PRBS 测误码(目标 BER<1e-12、长流量零误码)→ IBERT 扫眼图调预加重/均衡留足裕量。