存算一体(PIM)
一、一句话回答
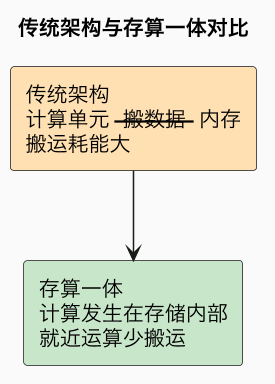
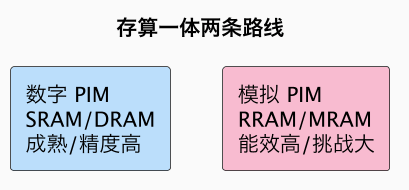
存算一体(PIM,Processing-in-Memory,也称近存计算/存内计算)是一类试图从架构上绕开「内存墙」的芯片思路。现代 AI 芯片在做大量计算时,一个越来越突出的矛盾是:真正花在运算上的能耗和时间,往往不如把数据在处理器与内存之间来回搬运来得多——算力越来越强,但供数跟不上,这就是所谓的内存墙(memory wall)。存算一体的核心想法是:既然数据就在存储里,干脆把计算单元直接放到存储阵列内部或紧邻存储的位置,让数据不用长途搬运就完成运算。深度学习最主要的计算是大规模矩阵乘加(大量乘法与加法的累加),而存储阵列天然适合并行完成这类运算,因此 PIM 在理论上能带来很高的能效比。它大致有两条技术路线:一条是基于 SRAM、DRAM 等成熟存储器的数字式近存/存内计算,工程上相对可控,例如三星曾在 HBM 内部集成 AI 计算引擎提出 HBM-PIM;另一条是利用 RRAM(阻变存储)、MRAM 等新型非易失器件做模拟存内计算,直接利用存储单元的物理特性(如欧姆定律、电荷累加)完成乘加,能效潜力大但精度、器件一致性和量产挑战也更大。代表玩家包括海外的 Mythic(模拟存算)、三星,以及中国的知存科技、后摩智能、千芯科技等。总体上,PIM 在特定的低功耗、边缘推理场景已有早期商用,但在精度保证、编程模型、工具链和大规模落地、与主流 GPU 生态竞争等方面仍有明显挑战。
为什么 PIM 值得关注。当制程红利变贵、内存墙成为主要瓶颈,改变「计算与存储分离」的传统架构,是提升 AI 能效可能的一条换道路线。
二、内存墙与两条技术路线
理解 PIM 要先理解内存墙。处理器与内存长期按「摩尔定律」各自演进,但二者速度提升并不同步,加上算力需求暴涨,系统越来越多时间和能量消耗在数据搬运与等待上。对矩阵运算密集的神经网络,这一矛盾尤其尖锐。PIM 把计算下沉,正是对这一架构瓶颈的回应。
| 路线 | 载体 | 特点 |
|---|---|---|
| 数字近存/存内 | SRAM/DRAM | 工艺成熟、精度可控、工程风险较低 |
| 模拟存内 | RRAM/MRAM 等新器件 | 借物理定律做乘加、能效高、精度与一致性难 |
模拟存内计算的原理很巧妙:让存储单元的电导表示权重,用输入电压表示激励,根据欧姆定律和基尔霍夫定律,在阵列上一次性完成大量乘法和电流累加,等效于一次矩阵向量乘。但模拟计算会受到器件波动、噪声、温度和量化精度影响,要把计算结果做到神经网络可接受的准确度,并保证大规模阵列里每个器件行为一致,工程难度很高。
三、玩家、场景与落地挑战
PIM 当前最现实的落点是能效比极其敏感、算力规模适中的边缘推理:例如智能传感器、可穿戴、电池供电设备、语音/视觉唤醒与轻量推理等场景,用较低功耗完成固定神经网络任务。而在数据中心,主流仍是 GPU 及高带宽内存方案,PIM 多以研究、小规模集成或特定加速模块的形式探索。
- 国际玩家:三星推进 HBM-PIM,在内存中加入计算能力;Mythic 等创业公司走模拟存算路线(该类公司商业化波动较大)。
- 中国力量:知存科技(RISC-V 存算一体 SoC)、后摩智能(智能驾驶/大模型端侧)、千芯科技等,是国内存算一体创业的代表。
- 核心挑战:计算精度与可重复性、对不同模型的灵活可编程性、编译器与软件工具链、新型存储器件量产良率,以及如何与成熟 GPU/加速器生态竞争。
节点速览:技术 / 玩家 / 成熟度 / 预期
数据截止 2026-09。标尺说明见 AI 产业链总览。
| 象限 | 要点 |
|---|---|
| 关键技术 | ① 数字近存计算(TRL-3)② RRAM 模拟存内计算(TRL-2~3)③ HBM 内集成计算(TRL-2) |
| 主要玩家 | 三星、Mythic;中国:知存科技、后摩智能、千芯科技等 |
| 做到什么程度 | 边缘低功耗场景早期商用,数据中心仍处探索,生态未成规模 |
| 后续预期 | 6 个月:边缘存算芯片继续小批量落地(中);18 个月:特定端侧大模型场景扩大(中);36 个月:能否进入主流仍不确定(低) |
常见误区
- 把存算一体当成又一种 GPU:它是架构范式创新,强在能效而非通用算力。
- 以为能效高就一定能普及:精度、可编程性和工具链、生态同样决定成败。
- 忽视模拟器件的一致性难题:物理计算虽优雅,但量产稳定性是硬挑战。
- 认为它会很快替代主流数据中心芯片:短期现实空间主要在边缘和特定加速。
总结
存算一体把计算单元放进存储内部或近旁,用减少数据搬运的方式正面回应 AI 芯片的内存墙,在矩阵乘加上具备突出的能效潜力;它分基于 SRAM/DRAM 的数字路线和基于 RRAM 等新器件的模拟路线,三星、Mythic 以及知存、后摩、千芯等在推进,目前主要在低功耗边缘场景早期商用;精度、可编程性、工具链和量产一致性仍制约其走向主流——它代表了在制程红利趋贵背景下,从计算架构本身寻找效率突破的一条值得关注、但尚未定型的路线。