Agent Loop 解剖:从 ReAct 到现代 coding agent 的消息生命周期
在 AI 编程工具的讨论里,「agent」这个词已经被用得几乎失去信息量。判断一个东西是不是 coding agent,不看它会不会说「我来帮你」,而看它内部有没有一个自己会转的循环:模型根据当前信息决定动作,动作的结果回到上下文,模型再决定下一步,直到任务收敛。这个循环就是 agent loop。
本篇是 coding agent 原理系列的第一篇,承担枢纽角色:先把 agent loop 讲到消息粒度,再用一个只用 Python 标准库、核心约 50 行的真实工程 mini-agent M1 把它跑出来。理解了这一层,后面的工具系统、上下文压缩、子代理编排都只是在 loop 的不同位置加机制。
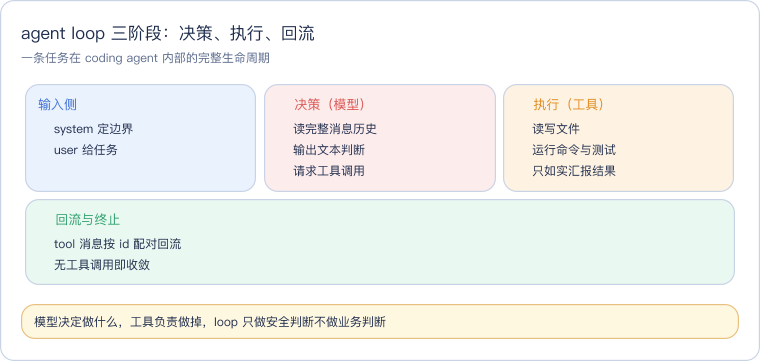
这张概念卡是全篇的骨架:输入侧的两类消息点火,之后决策、执行、回流三阶段不是并列模块,而是一个带终止条件的环。读这张图抓住一个判据——模型若不再发出工具调用,环就停了。
本文要回答的问题
- 为什么说「有没有循环」是 agent 和普通聊天机器人的分界线?
- ReAct 提出的 Thought-Action-Observation 循环,和今天的 function calling 机制是什么关系?
- 一轮 loop 中流转的消息有哪些角色,工具结果怎么回到上下文?
- 现代 coding agent 的 harness(运行外壳)相对朴素循环多承担了什么?
- 能否用不依赖任何外部 API 的方式,把这个循环真实地跑一轮并逐条追踪消息?
一、分析:ReAct 循环,以及「会自己转」到底意味着什么
Agent loop 的思想源头通常追溯到 2022 年的 ReAct 论文。它的观察很朴素:大模型在推理题上会一错到底,在行动任务上又常常乱动;如果让模型把「推理(Thought)→ 行动(Action)→ 观察(Observation)」交替生成,推理为行动提供依据,观察为下一轮推理提供新事实,两者都明显变好。
论文里的样例是纯文本协议:模型用固定格式输出 Thought: 我需要查X、Action: Search[X],外壳程序用正则把 Action 抠出来、执行搜索、把结果以 Observation: ... 拼回 prompt,再让模型继续。换句话说,模型从头到尾只在做文本补全,循环靠外部程序驱动。这一点直到今天都没有变,变的只是协议从脆弱的正则解析换成了结构化的 function calling。
这件事值得单独强调,因为它是 coding agent 原理的第一性结论:
- 大模型本身是无状态的函数调用——给一段上下文,返回一段文本,调用结束它就「失忆」;
- agent 不是一个更大的模型,而是模型外面套的一个 while 循环加状态管理;
- 所谓「模型在使用工具」,机制上是模型输出结构化的调用请求,外部程序替它执行后把结果喂回去。模型碰不到你的文件系统,是 harness 碰得到。
如果没有这个环,模型对一个任务只能一次性作答:你要求「修 bug 并验证」,它可以把修改后的完整代码贴出来,但无法真的运行测试、看到失败、再改一次。能否根据真实执行的反馈继续决策,正是 chat 模式和 agent 模式的分界线。这也解释了为什么提示工程层面的技巧(参见 提示工程指南)替代不了 harness:prompt 影响模型这一步怎么想,loop 决定模型有没有下一步。
朴素 ReAct 协议还有一个经常被忽略的脆弱点值得记住:Action 是夹在自然语言里的,模型一旦换了措辞、少个括号,正则就解析失败,整个循环当场死掉。现代 function calling 把「说什么语言」和「调用什么动作」在 API 层分离——文本走 content,动作走带 schema 的结构化字段——解析事故因此被消灭在模型输出层。理解这条演化线,就不会把 function calling 误读成「模型变强了」:模型的能力边界没有根本变化,变化的是循环两端的接口纪律。
二、设计:四种消息角色与一轮 loop 的时序
把 loop 拆到消息粒度,需要的角色只有四种。
| 消息角色 | 谁产生 | 内容 | 在 loop 中的作用 |
|---|---|---|---|
system | harness | 行为边界与工具说明 | 每轮都在上下文里,约束模型风格与权限 |
user | 用户 | 任务描述 | 环的输入,通常只有第一条 |
assistant | 模型 | 文本判断 + 可选 tool_calls | 决策载体;tool_calls 的有无决定循环继续或终止 |
tool | harness/工具 | 执行结果与退出信息 | 通过 tool_call_id 与调用配对,为下一轮决策提供事实 |
关键的配对关系是 assistant.tool_calls[].id 与 tool.tool_call_id:模型一次可以请求多个工具调用(并行调用),harness 必须让每条结果都带回自己归属的 id,模型下一轮才能分清哪段输出对应哪个请求。这套结构是 MCP 协议 出现之前就由 chat completion API 定下的事实标准,MCP 解决的是工具怎么发现、怎么跨进程提供,消息层的形状没有改变。
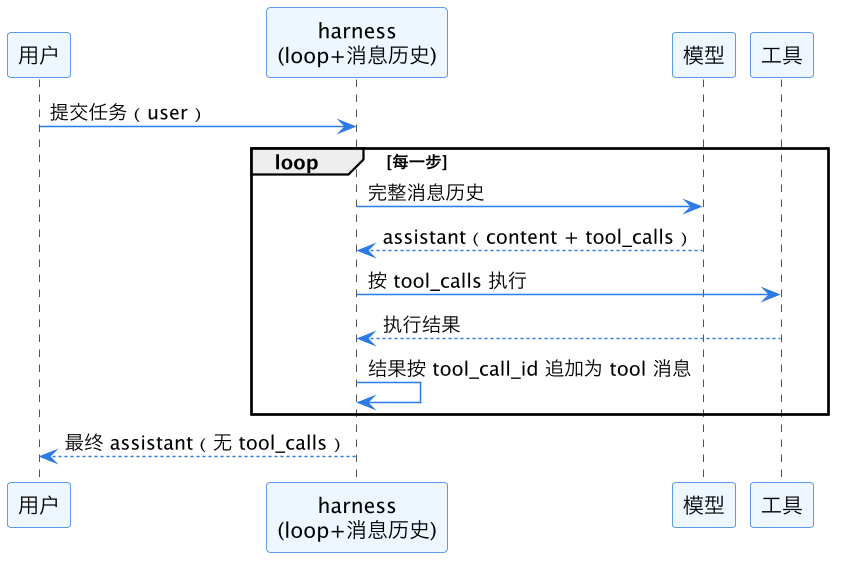
读这张时序图抓住两条线:竖向上消息历史只增不减,每经过一轮循环,assistant 和 tool 消息成对追加;横向上模型看到的永远是完整历史,它不靠任何会话外的记忆工作。循环的退出也发生在模型侧——不是工具告诉 harness「我干完了」,而是模型看完最后一条 tool 结果后,返回了一条不带 tool_calls 的 assistant 消息。把终止判断权放在模型这里,是因为「任务是否真的完成」(比如测试是否通过)恰恰需要语义理解。
再补两个消息层的细节。第一,tool 消息的内容本质上是一段字符串,即使是结构化的退出码也被拍平成文本(mini-agent 里约定首行写 EXIT 0 或 EXIT 非零),模型靠阅读理解成败,没有专门的布尔通道。这也是工具错误不能用异常直接炸穿循环、而要返回 ERROR: ... 文本的原因:崩溃发生在 harness 里,模型反而得不到信息。第二,一条 assistant 消息可以同时带多个 tool_calls,harness 并行执行后按 id 分别回流;M1 的脚本每步只调用一个工具,是为了让时序保持单线清晰,并行语义留给后续子代理篇展开。
三、对比:从朴素 ReAct 到现代 harness,多出来的机制
ReAct 的朴素循环只有「拼字符串、解析动作、执行、拼回」四件事。今天一个严肃的 coding agent 在这四件事之外还多了一整层 harness 职责,它们几乎全部是被真实软件环境逼出来的。
| 维度 | 朴素 ReAct 循环 | 现代 coding agent harness |
|---|---|---|
| 动作协议 | 自由文本 + 正则解析,格式漂一点就解析失败 | 结构化 function calling,参数带 JSON schema |
| 工具面 | 单一搜索类动作 | read/edit/run、bash、MCP 工具,按目录动态增减 |
| 权限 | 默认全部放行 | 分级审批,写文件/联网/执行命令可独立拦截 |
| 上下文 | 朴素全拼接,超长即崩 | 截断、摘要、工具结果老化等压缩策略 |
| 执行组织 | 单线程单动作 | 并行工具调用、子代理 fork 与结果回收 |
| 可观测性 | 打印到屏幕 | 结构化 trace、审计日志、消息回放 |
| 副作用控制 | 无 | 路径约束、沙箱、编辑前唯一匹配校验 |
怎么读这张架构图:蓝框是环本身,灰框是可替换的模型入口(M1 在这里放的是确定性脚本适配器,换成真实 API 时 loop 一行不改),紫框是横切在每次调用上的检查与记录,橙框和绿框是动作与真实世界。这五层就是后续整个系列的展开顺序:工具系统讲橙框,权限与沙箱讲紫框的一半,hooks 讲拦截点,上下文压缩讲消息历史自己的维护,子代理讲多个环如何协作。
一个容易被忽略的设计要点:harness 不做业务判断,但必须做安全判断。「测试失败要不要换个方案」归模型;「这条路径是否逃出工作区」「这次写入要不要先问用户」归 harness。前者需要语义,后者需要纪律。
表中这些机制没有一条是「agent」定义的必要条件,但真实软件环境会把它们逐个逼出来:没有权限控制,一次失控的 rm 或网络请求代价不可逆;没有上下文管理,长任务必然撞窗口;没有 trace,agent 改坏了代码之后你无法回答「它到底在哪一步、依据哪条输出做的决定」。所以判断一个 coding agent 产品的成熟度,问模型参数往往不得要领,应该顺着这张图问:调用前有谁拦、超长时怎么压、出事了回放什么。这也是本系列后续各篇都坚持用可运行实验而不是参数表说话的原因。
四、实现:mini-agent M1,约 50 行核心把环跑真
光讲结构不过瘾,也无法证明这个环真的能闭环。mini-agent 是为本系列建立的持续增量工程(目录与公开仓的对应见文末代码获取),M1 的目标是用最少的代码跑通真实的「读文件 → 改代码 → 跑测试」。它有三个刻意的工程决定:
- 模型用脚本化适配器
ScriptedModel:按步数返回预先写好的确定性回复,不访问任何外部 API。同一条任务跑十次,消息序列逐字节一致,这让 trace 可以对拍、实验可以复现。它与未来真实模型适配器实现的是同一个complete(messages)接口。 - 工具都是真的:
read_file真的读盘,edit_file做精确字符串替换且要求唯一命中(命中 0 处或多处都返回错误,拒绝猜着改),run_test真的起子进程跑python3 -m unittest。 - 消息全程落 trace:每条 assistant、tool 消息和生命周期事件写一行 JSON,存成 JSONL。
主循环全部核心如下:
def run_loop(model, tools, messages, tracer, max_steps=8):
    tracer.event("session_start", max_steps=max_steps)
    for step in range(max_steps):
        tracer.event("step_begin", step=step)
        reply = model.complete(messages)       # ① 模型决策
        messages.append(reply)
        tracer.message(reply)

        calls = reply.get("tool_calls")
        if not calls:                          # ② 无工具调用:终止
            tracer.event("session_end", reason="final_answer", steps=step + 1)
            return reply["content"]

        for call in calls:                     # ③ 执行工具,结果回流
            tracer.event("tool_call", id=call["id"], name=call["name"])
            result = tools.dispatch(call["name"], call["arguments"])
            messages.append({
                "role": "tool",
                "content": result.content,
                "tool_call_id": call["id"],
            })
            tracer.message(messages[-1])
            tracer.event("tool_result", id=call["id"], ok=result.ok)

    raise RuntimeError("超过最大步数 %d 仍未结束" % max_steps)
对照第二节的时序图读这段代码:循环只认消息,没有任何 if 去判断「bug 修好没」——那是模型读完 run_test 输出后自己决定的。另外注意 max_steps 兜底:真实模型可能陷入反复调用工具的怪圈,没有步数上限的 agent 循环在工程上是不可接受的,它是这个环的保险丝。
被测工程也被刻意安排成有故事的形态。工作区里 calculator.py 的 square 函数错写成 return n + n,测试断言 square(4) == 16。脚本化模型的四步回复对应:读文件确认缺陷、编辑把加号换成乘号、跑测试验证、给出最终结论。真实运行的终端输出如下。
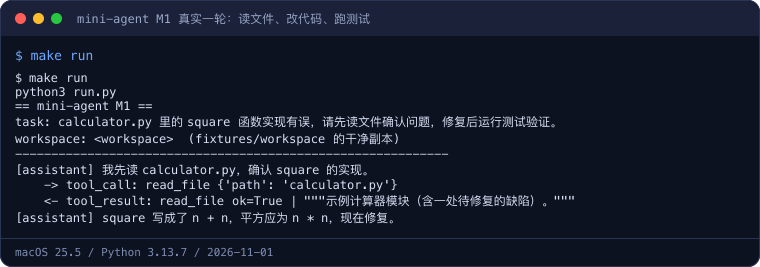
终端卡逐行展开了 loop 的四步:每条 [assistant] 是模型的判断,缩进的 -> tool_call 行给出工具名和参数(注意 edit_file 的参数里带着完整的 old/new 字符串),<- tool_result 行给出工具名、ok 布尔和结果首行——read_file 的首行是源码的 docstring,edit_file 报告替换一处,run_test 给出 EXIT 0。末尾 model calls: 4 对应三次带工具调用的决策加一次最终答复。这张卡证明的是「环真的转完了」,而每步消息的完整内容要看 trace。
trace 是 JSONL,每行一个事件。下面摘录首尾关键行:第一次工具调用的 assistant 请求、它的 tool 结果,以及最终终止事件。
{"type": "message", "message": {"role": "assistant", "content": "我先读 calculator.py,确认 square 的实现。", "tool_calls": [{"id": "call_1", "name": "read_file", "arguments": {"path": "calculator.py"}}]}, "seq": 3}
{"type": "message", "message": {"role": "tool", "content": "\"\"\"示例计算器模块(含一处待修复的缺陷)。\"\"\"\n\n\ndef square(n):\n    # BUG:误用加法,平方应为乘法\n    return n + n\n", "tool_call_id": "call_1"}, "seq": 5}
{"type": "event", "event": "tool_result", "payload": {"id": "call_3", "ok": true}, "seq": 16}
{"type": "event", "event": "session_end", "payload": {"reason": "final_answer", "steps": 4}, "seq": 19}
读这段 trace 抓住配对与终止两个细节:seq 3 的调用 id 是 call_1,seq 5 的结果带着同一个 id 回流;最后 session_end 的原因是 final_answer 而不是步数耗尽,说明环是模型主动停的。完整 trace 共 19 行:3 条带工具调用的 assistant、3 条 tool 结果、1 条最终 assistant,其余是生命周期事件。
工具实现里有两处纪律值得单独说。edit_file 拒绝多命中替换,是为了防止模型拿着一段常见代码(比如单独一个 n)误改到不相干的位置——主流 coding agent 的编辑工具都采用同样的唯一匹配语义,宁可让模型多读一次、把上下文写全,也不替它猜改哪处。read_file 带字节数上限、run_test 带超时,则是防止 agent 被一个超大文件或一条死循环测试永久卡住。另外工作区每次运行前都从 fixtures/ 干净复制:实验的前提是初始状态可重建,否则同一脚本跑两轮结果不同,trace 的可复现性就只是口号。
五、测试:headless 断言,让结构可回归
M1 不只要能跑,还要让「循环结构没被改坏」可以自动验证。测试不走 TTY、不 mock 工具——在临时目录里复制一份干净工作区,真跑 run_loop,然后对消息历史、文件内容和 trace 分别断言。五个用例覆盖:
| 用例 | 断言内容 |
|---|---|
test_loop_completes_without_tool_calls | 模型恰好被调用 4 次,最后一条消息无 tool_calls,最终答复包含测试结论 |
test_file_really_fixed | 运行后磁盘上的源码含 return n * n 且不再含 return n + n |
test_trace_has_all_messages | trace 恰好 7 条消息,角色序列为 assistant/tool 交替三次后接最终 assistant |
test_edit_rejects_non_unique | 替换文本多处命中时返回错误且文件不动 |
test_read_rejects_path_escape | ../../etc/hosts 这类越界路径被拒绝 |
test_edit_rejects_non_unique (test_loop.LoopM1Test.test_edit_rejects_non_unique) ... ok
test_file_really_fixed (test_loop.LoopM1Test.test_file_really_fixed) ... ok
test_loop_completes_without_tool_calls (test_loop.LoopM1Test.test_loop_completes_without_tool_calls) ... ok
test_read_rejects_path_escape (test_loop.LoopM1Test.test_read_rejects_path_escape) ... ok
test_trace_has_all_messages (test_loop.LoopM1Test.test_trace_has_all_messages) ... ok

----------------------------------------------------------------------
Ran 5 tests in 0.260s

OK
这组测试的存在本身也是一条方法论:agent 系统看似是「跑起来看效果」的东西,但它的骨架——消息怎么配对、循环何时终止、工具错误怎么回传——全是可以机械断言的。后续每个里程碑加新机制时,先保住 M1 这五个绿灯,环的基本盘就不会在迭代中悄悄散架。开发过程中实测到一个真实小坑:路径校验最初直接抛 ValueError,而分发层只捕获了参数类型错误,导致「工具应返回错误结果」变成「进程崩溃」,这正是错误必须以消息形式回流、而不是靠异常炸穿循环的原因,修复后测试才全绿。
最后交代 M1 刻意不做的事,它们划出后续增量的边界:脚本里的四步回复是写死的,模型不会根据工具返回的真实内容临场应变——这是确定性实验的代价,未来接入真实模型适配器后决策才变成开放问题;工具注册表只认三个固定名字,没有 schema 声明和发现机制;权限检查只做了路径约束这一条。读者动手扩展时,推荐的第一个练习不是加功能,而是把 m1_task.json 里的缺陷换成别的形态(比如多文件、测试先红后绿两轮修复),观察消息序列如何随之变长——环的结构不变,变的只是它转几圈。
实验环境
- 机器/系统:Mac mini / macOS 25.5(Darwin 25.5.0)
- 工具版本:Python 3.13.7(仅标准库,无第三方依赖)
- 日期:2026-11-01
- 完整命令:
cd demos/mini-agent
make run    # 重置 workspace,真跑一轮读文件、改代码、跑测试,trace 落 traces/trace.jsonl
make test   # 5 个 headless 用例
代码获取
mini-agent M1 的全部源码、测试与任务脚本已同步到公开仓库,检出后无需安装任何依赖:
- 仓库地址:https://github.com/derekzhuo/geek-doc.cn
- 目录:mini-agent/
- 复现方式:进入
mini-agent/目录执行make run查看完整一轮,执行make test跑全部 headless 用例;修改scripts/m1_task.json可以替换任务与脚本化回复。
这一篇在知识体系里的位置
本篇是「coding agent 原理」系列的枢纽,回答「agent 为什么会自己转、消息怎么流转」。向下游展开:function calling 工具系统 继续拆解工具注册、schema 校验、只读并发与错误回流;消息历史超限时的维护进入上下文压缩篇,多个循环的协作进入子代理篇,harness 的拦截与隔离分别由 hooks、权限沙箱两篇承担。横向参考:coding agent 全景 给出工具版图,mini-vim 架构总览 展示同样的「核心定边界、外壳做 IO」分层思想在另一个工程里的形态;想先理解模型侧技巧,可读 提示工程指南;想理解工具跨进程供给,可读 MCP 协议。
总结
coding agent 原理可以浓缩成一句话:agent 是模型外面一个带终止条件的 while 循环,模型用结构化的工具调用做决策,harness 替它执行并把结果按 id 回流,模型不再请求工具时环停转;mini-agent M1 用约 50 行真实核心和可复现的 trace 证明,读文件、改代码、跑测试的完整闭环不需要任何神秘成分,现代 harness 相对 ReAct 多出来的权限、压缩、编排与审计,则是这个朴素循环在真实软件环境里必须长出的保护层。