function calling 工具系统:从 JSON Schema 校验到并发与错误回流
上一篇 Agent Loop 解剖 把模型决策、工具执行、结果回流串成了一个闭环。不过,只有 read_file、edit_file、run_test 三个函数的注册表还称不上可靠的工具系统:参数错了在哪里拦,一条 assistant 消息请求多个动作时能否同时执行,文件不存在该抛异常还是告诉模型,这些才决定 function calling 能否进入真实工程。
本篇在同一个 mini-agent 工程上完成 M2,保留 M1 的消息格式和默认演示,再增加 list_files、search_text、read_lines 三个只读工具。所有代码仍只使用 Python 3 标准库;模型仍是确定性脚本,因此并发、错误与恢复都能重复观察,而不是依赖一次在线模型的偶然输出。
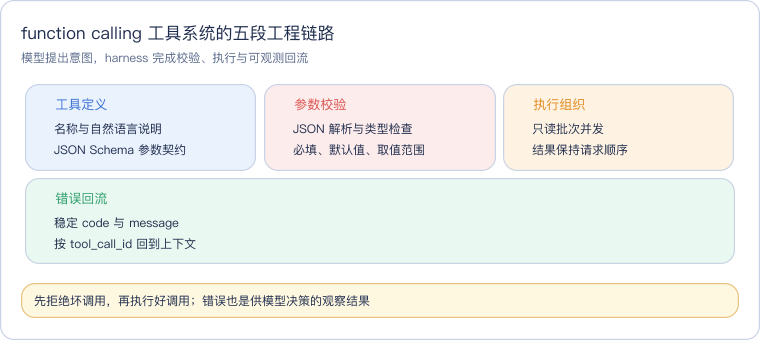
这张概念卡按一次调用的生命周期排列。工具定义不是附属于实现的文档,而是模型与 harness 的共同契约;校验在执行之前,错误回流在执行之后。中间是否并发属于调度优化,不能改变结果配对和消息顺序。
本文要回答的问题
- function calling 的工具声明为什么必须同时给人和模型读?
- JSON 能解析成功,为什么仍要过 JSON Schema 与跨字段校验?
- 哪些工具调用适合并发,结果顺序与实际完成顺序又该如何处理?
- 工具错误怎样结构化回传,才能让模型修正参数而不是让 loop 崩溃?
- mini-agent M2 如何用真实运行和 headless 测试证明这条链路?
一、分析:函数名之外,工具系统还缺哪三层
Function calling 常译作「函数调用」,但它并不是模型直接取得一个 Python 函数指针并执行。模型返回的是一段 JSON 意图:调用哪个名字、带什么参数。真正接触磁盘和进程的是 harness。这个边界带来一个直接结论:工具参数是不可信输入,即使它来自能力很强的模型,也不能跳过校验。
只把函数塞进字典会产生三类典型故障。第一类是传输故障,例如 arguments 实际是一串 JSON,调用方却直接对它做 **arguments;第二类是契约故障,JSON 明明合法,却缺少 path、把 max_entries 写成字符串,或夹带工具没声明的字段;第三类是执行故障,例如行号区间倒置、路径不存在、子进程超时。三类的处理位置不同,不该全部变成同一个 ERROR。
M2 新增的三个工具分别补足常见的信息获取方式。
| 工具 | 参数契约的教学点 | 真实用途 | 是否只读 |
|---|---|---|---|
list_files | path 与 max_entries 有默认值,后者限制 1–200 | 先看目录,不靠模型猜文件名 | 是 |
search_text | query 必填且非空,目录与单文件共用入口 | 返回文件、行号、原文,定位符号 | 是 |
read_lines | 一基行号、可选闭区间,另查 end_line >= start_line | 只取相关片段,控制回流体积 | 是 |
只读不等于毫无副作用:读文件可能更新操作系统访问时间,测试进程也可能生成缓存。因此这里的「只读」是工具契约层面的分类——不主动修改工作区内容、不写文件、不启动测试。run_test 被明确排除在并发集合之外,即使它本次没有修改源代码,也不能和 edit_file 抢同一个工作区。
二、设计:声明、校验、调度与回流的单向数据流
mini-agent 把每个工具描述为同一个结构:name、description、readonly、parameters。前两项会交给模型帮助选型,第三项给调度器判断能否并行,最后一项是 JSON Schema 子集。M2 实现 type、properties、required、additionalProperties、default、数值上下界和最小字符串长度;这是工具所需子集,不冒充通用校验库。
读这张图要抓住一条短路:校验失败从蓝框直接到灰框,不会经过调度器和真实工具。因此缺参数的请求没有机会碰磁盘。正常路径中,紫框是声明来源,橙框只组织执行,绿框才产生真实世界的结果;两条路径最终统一成 tool 消息,模型下一轮看到的是事实而不是 harness 的异常堆栈。
声明和执行放在一起还有维护上的好处。新增工具时,不能只写处理函数却忘记 schema,也不能把 readonly 标在另一份容易过期的配置里。definitions() 返回防御性副本,调用方即使修改返回的声明,也不会污染注册表。完整 JSON Schema 生态支持远程引用、组合关键字等复杂能力,这里有意不做:教学工程要让校验路径可逐行跟踪,真实产品则可替换成熟库而保持边界不变。
并发只改变等待方式,不改变消息契约
一条 assistant 消息可以包含多个 tool_calls。M2 仅在「调用数大于 1 且全部只读」时建立 ThreadPoolExecutor,每个 future 对应一个 dispatch;随后按原调用列表顺序取结果、追加消息。文件读取和文本搜索主要等待 IO,标准库线程池足以表达这种并发,不需要引入异步框架。
这张调用时序图把并发与回流分开看:三个工具的执行区间相互重叠,但回流不是谁先结束就立即把谁的消息插进历史,而是这一批收齐后按 call_1、call_2、call_3 排列。实际函数可以在不同时间完成,消息协议却保持确定性。若一批里混入 edit_file 或 run_test,M2 整批退回顺序执行,这是保守但清楚的初版策略;更细的分组调度可以以后增加,不能靠猜测判断依赖关系。
三、对比:错误字符串、异常与结构化结果
工具失败最容易走两个极端:只返回一句自然语言,模型难以稳定区分错误类别;或者让异常穿过 loop,整个任务直接中止。更合理的方式是双通道:content 保留模型容易阅读的文本,error 给程序做分类、审计和指标统计。
| 方案 | 模型能否看到 | 程序能否稳定分类 | loop 是否存活 | 适用位置 |
|---|---|---|---|---|
| 仅返回错误字符串 | 能 | 只能靠匹配文本 | 能 | 最小原型,不适合做自动化统计 |
| 异常直接向外抛 | 通常不能 | 能看异常类型 | 若无顶层捕获则中止 | harness 自身缺陷,不是普通工具失败 |
content + error | 能 | 读稳定 code | 能 | 参数、路径、执行等可恢复失败 |
run_test 非零退出 | 能看到完整输出 | 读退出码 | 能 | 工具正常执行,但被测任务失败 |
M2 的错误对象固定含 code、message、tool,例如 invalid_json 表示传输文本根本不是 JSON,schema_validation 表示字段契约不满足,invalid_range 表示字段各自合法、组合关系不合法,unknown_tool 表示名称未注册。路径越界、文件不存在、执行异常也各有分类。这个分类不是替模型做决定,而是让监控能回答「本周失败主要来自模型写错参数,还是工作区环境异常」。
特别需要区分 ok=False 的两种语义。read_lines 的倒置区间是调用失败,带 error;测试断言失败则不代表 run_test 坏掉,它成功运行了测试并忠实带回非零退出码,因此不需要伪造一个工具异常。前者通常应修正参数,后者通常应修改代码,混为一谈会让模型采取错误动作。
四、实现:从 schema 到错误恢复的完整 M2 链路
参数入口先兼容 dict 与 JSON 字符串,因为主流 API 常把 arguments 放在字符串字段里。解析后复制输入,补默认值,再检查必填项、额外字段和每个字段的类型与范围。核心结构如下。
if isinstance(arguments, str):
    try:
        arguments = json.loads(arguments)
    except json.JSONDecodeError as exc:
        raise SchemaError("invalid_json", "arguments 不是合法 JSON: %s" % exc.msg)
if not isinstance(arguments, dict):
    raise SchemaError("schema_validation", "arguments 必须是 JSON object")

values = copy.deepcopy(arguments)
for key, spec in properties.items():
    if key not in values and "default" in spec:
        values[key] = copy.deepcopy(spec["default"])
# 随后检查 required、additionalProperties、类型和上下界
dispatch 把校验错误变成 ToolResult,处理函数不再各自解析 JSON。跨字段规则仍留在具体工具中:end_line < start_line 需要两个字段一起看,不属于当前 schema 子集。这里保持分层而不是硬塞一个庞大的校验器。
results = tools.dispatch_many(calls)
for call, result in zip(calls, results):
    message = {
        "role": "tool",
        "content": result.content,
        "tool_call_id": call["id"],
    }
    if result.error is not None:
        message["error"] = result.error
    messages.append(message)
这段回流代码是 M1 的增量而不是替换:成功消息仍是原来的三个字段,只有失败时附加 error;单工具任务与原有 trace 的角色顺序不变。dispatch_many 返回列表与调用列表等长,所以 zip 不会把较慢调用的结果配到另一个 id 上。真实实现不能用「完成一个就向字典塞一个」再依赖完成顺序,否则消息虽都到了,语义却错位。
实际 M2 演示先并发调用 read_file、list_files、search_text,随后故意以 JSON 字符串请求第 6 到第 2 行。模型读到 invalid_range 后改为第 4 到第 6 行,再执行唯一匹配编辑与测试。
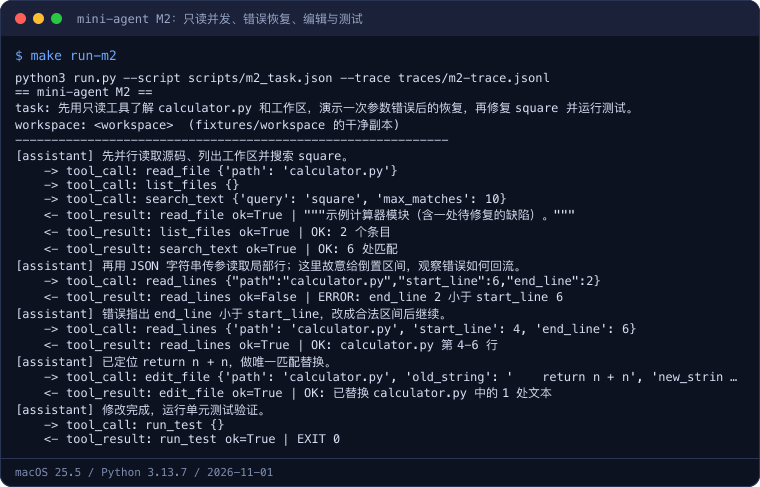
终端卡开头连续出现三个请求,结果仍以 read_file、list_files、search_text 的顺序排列;中间 read_lines ok=False 没有终止任务,下一条 assistant 明确依据错误修改了区间。最终 run_test 返回 EXIT 0,六次模型决策中共有七次工具调用。
实录里还能直接看到两种参数形态:前三项是 dict,倒置区间那一项是 JSON 字符串。后者成功通过 JSON 解析,却被跨字段检查拒绝,这正好说明「合法 JSON」与「合法调用」不是同义词。
trace 进一步给出终端摘要没有展示的错误对象。
{"type": "event", "event": "tool_batch", "payload": {"mode": "parallel", "size": 3}, "seq": 4}
{"type": "message", "message": {"role": "tool", "content": "ERROR: end_line 2 小于 start_line 6", "tool_call_id": "call_4", "error": {"code": "invalid_range", "message": "end_line 2 小于 start_line 6", "tool": "read_lines"}}, "seq": 17}
{"type": "message", "message": {"role": "assistant", "content": "错误指出 end_line 小于 start_line,改成合法区间后继续。", "tool_calls": [{"id": "call_5", "name": "read_lines", "arguments": {"path": "calculator.py", "start_line": 4, "end_line": 6}}]}, "seq": 20}
{"type": "event", "event": "session_end", "payload": {"reason": "final_answer", "steps": 6}, "seq": 36}
seq 4 记录批次确实走了并发分支;seq 17 的 call_4 同时带人类可读内容与机器可读错误;seq 20 是修正后的新调用,不复用旧 id。整份 trace 共 36 行,以 final_answer 正常收尾,而不是步数耗尽或异常退出。
五、测试:17 个 headless 用例固定工具边界
M2 新增 12 个用例,连同 M1 的 5 个共 17 个。声明数量、默认参数、必填与额外字段、错误类型、数值范围、非法 JSON、JSON 字符串、局部读取、搜索、未知工具、只读并发以及完整错误恢复都有覆盖。
并发测试不靠容易抖动的耗时阈值。测试注册表记录同时处于 read_file 的线程数,三次调用各真实等待 50 毫秒,断言峰值恰好为 3,并检查结果数量与成功状态。完整 loop 测试则断言 7 条 tool 消息中第 4 条带 invalid_range,trace 存在 tool_batch(mode=parallel),最终源码已经变成 return n * n。
test_m2_loop_recovers_from_error_and_finishes ... ok
test_three_readonly_calls_overlap_and_keep_order ... ok
test_defaults_are_applied ... ok
test_invalid_json_is_distinguished_from_schema_error ... ok
test_missing_required_argument_is_structured_error ... ok
test_read_lines_rejects_inverted_range_without_crashing ... ok

----------------------------------------------------------------------
Ran 17 tests in 0.570s

OK
M1 五个旧用例继续全绿同样重要。工具系统升级不能只证明新功能能跑,还要证明原有循环终止、消息数量、唯一匹配编辑和路径约束没有回归。当前未覆盖的是多进程隔离、写工具之间的依赖推断以及完整 JSON Schema 标准;它们不应被这 17 个绿灯暗示为已经解决。
实验环境
- 机器/系统:Mac mini / macOS 25.5(Darwin 25.5.0)
- 工具版本:Python 3.13.7(仅标准库,无第三方依赖)
- 日期:2026-11-01
- 完整命令:
cd demos/mini-agent
make run-m2   # 重置工作区,录制并发、错误恢复、编辑和测试;写 traces/m2-trace.jsonl
make test     # 运行 M1 + M2 共 17 个 headless 用例
代码获取
mini-agent M2 的六个工具、schema 校验器、任务脚本与全部测试已同步到公开仓库:
- 仓库地址:https://github.com/derekzhuo/geek-doc.cn
- 目录:mini-agent/
- 复现方式:进入
mini-agent/,执行make run-m2查看本篇完整调用序列;make test跑回归;make run仍保留上一篇的 M1 演示。修改scripts/m2_task.json可替换工具调用与错误场景。
这一篇在知识体系里的位置
本篇承接 Agent Loop 解剖 中的「执行与回流」阶段,把 function calling 工具系统落实到声明、校验、并发和错误四种机制。宏观工具版图见 coding agent 全景;工具跨进程发现和供给则属于 MCP 协议 的层次,MCP 不替代本篇的本地参数校验与结果配对。
总结
function calling 工具系统的核心不是「给模型更多函数」,而是给每个动作建立可执行契约:工具声明让模型知道能做什么,JSON Schema 与跨字段校验在执行前拒绝坏参数,只读批次用并发减少等待但保持消息顺序,结构化错误则按 tool_call_id 回到上下文供模型恢复。mini-agent M2 用三个新工具、一次真实的倒置区间错误和 17 个 headless 用例证明,可靠 agent 的关键不在工具名字,而在这整条边界链路。