知识版图:集成电路与 EDA、AI 编程、Linux 性能剖析与全栈技术
📌 最后更新:2026-11-05
这个仓库是一份系统性的硬核技术知识库,三条主线并进:集成电路与 EDA(芯片设计全流程、数字验证、开源 EDA 实跑、FPGA、低功耗)、AI 编程(Coding Agent 原理、Claude Code 等工具实战、MCP 生态)、Linux 性能剖析与底层原理(490+ 篇,按五层知识金字塔组织),并持续扩展编程语言、后端、数据库、云原生等全栈技术域。
一句话定位:IC 部分负责"芯片怎么造"——从 RTL、验证到时序收敛与流片;AI 编程部分负责"怎么用 Agent 把活干得更快"——选型、配置、工作流;底层部分负责"程序为什么慢"——从 perf 命令一路解释到 CPU 电路、缓存一致性与 ELF 二进制;全栈部分负责"业务代码怎么写"。
快速入口
- 想搞懂芯片设计 → chip-design/(从 RTL 到流片的全流程知识地图);想做完整小项目 → 异步FIFO设计全景(支柱页 + 工程包 + 实测 + 坑点 + 面试)
- 想上手 FPGA / 仿真 → FPGA 导读 · 开源 EDA 实跑(iverilog/verilator/yosys 真实验)
- 想把 AI 编程用起来 → AI 编程工具导读(选型)· Claude Code 教程(上手)· Coding Agent 原理(懂机制)
- 想按工具查用法 → tools/(可观测工具索引,按排查维度分类)
- 想按原理查文档 → concepts/(底层原理索引,17 个子域)
- 想直接要答案 → 高频问题速查(Linux 性能与常见运维故障的简明解答和深入阅读入口)
- 想快速查命令 → Linux 命令速查(20 大命令族 460+ 高频命令速查表)
- 想 5 分钟跑通一个工具 → 5 分钟上手系列(perf/top/strace/vmstat/iostat/pidstat/htop/ss/free 三步上手)
- 想动手验证 → demos/(可跑示例)
- 想学业务开发全链路 → 全栈十域(语言/后端/数据库/云原生/AI)
- 想先看地图 → 本篇
按身份选路:先别急着翻文档
不同的身份,第一站完全不同。选一条路走,别从头读到尾:
| 你是谁 | 想解决什么 | 从哪开始 |
|---|---|---|
| IC / FPGA 工程师 | 设计流程、验证、时序约束、EDA 工具 | 芯片设计导读 → FPGA 导读 → 开源 EDA 实跑 |
| 想用 AI 提效的开发者 | 工具选型、Agent 配置、工作流避坑 | AI 编程导读 → Coding Agent 原理 → Agent 实战 |
| 运维 / 排障工程师 | 线上 CPU 高、响应慢、IO 卡 | tools/ 工具速查(按场景选工具表)→ 按场景排障路径 |
| C/C++ 开发 | 代码跑不快、多核扩展差、延迟抖动 | 缓存一致性 → CPU 微架构 → 内存序 |
| 系统学习者 | 建立完整底层体系 | 五层金字塔 → 自底向上读 L5 → L4 → L3 → L2 → L1 |
| 崩溃排查 | 进程挂了、core dump、段错误 | crash/(core-dump 全流程)→ signals |
| 架构选型 | 网络高并发、存储、容器、量化低延时 | 应用域:跨层综合场景 |
想快速定位某个症状("iowait 高""TIME-WAIT 堆积""cache miss 高")?直接去 tools/ 按场景选工具表,一行一个症状 → 工具 → 深入文档。
一、主题域一览:20 个顶层域
全仓库文档按 23 个顶层主题域组织。主线八域回答"性能与底层原理",扩展三域回答"代码怎么写、怎么组织、怎么被搜索到",全栈十域覆盖业务开发全链路(语言/后端/数据库/云原生/协议/架构/SRE/安全/工程/AI):
主线八域(性能与底层)
| 域 | 一句话 | 入口 |
|---|---|---|
| tools/ | 可观测工具:top/perf/strace/vmstat/iostat/sar,按排查维度分类 | 工具指南 |
| linux/ | Linux 命令速查:20 大命令族 460+ 高频命令,字典式速查 | 命令速查 |
| concepts/ | 底层原理:进程、内存、缓存、微架构、ELF 等 17 个子域 | 底层原理 |
| crash/ | 崩溃排查:core dump、信号、ASan/TSan/Valgrind | 崩溃排查 |
| demos/ | 可运行示例:cpu-demo 靶子程序 + 各原理实验 | perf 实验 |
| parameter/ | 内核参数速查:/proc、sysctl、sysfs 指标对照 | 内核参数 |
| projects/ | 综合实战项目:百万 QPS TCP 高并发全链路(网络 + 性能 + 架构) | 实战项目 |
| dpa/ | 芯片低功耗验证:DPA 动态功耗分析(Emulator/多 FPGA 原型采集方案 + 平台运行工程师实操 SOP) | 芯片低功耗验证 |
| chip-design/ | 芯片设计:数字芯片从 RTL、验证、综合到物理实现(布局布线/时序/功耗)的完整流程,含 EDA 工具链与流片制造 | 芯片设计 |
| eda/ | EDA 电子设计自动化:产业格局、工具全矩阵、验证工具链、核心算法、数据格式,以及开源/国产/AI 生态 | EDA 领域导读 |
| eda-lab/ | EDA 开源工具实操:iverilog/verilator/yosys/cocotb 真实实验驱动(代码在公有仓库 experiments/),仿真/综合/波形分段 | iverilog 仿真入门 · cocotb 入门 · yosys show 网表图 |
| fpga/ | FPGA 现场可编程门阵列:架构原理、Verilog 设计、IP 核、时序约束、高速接口、调试技巧、工程实践、Zynq SoC 异构与原型验证 | FPGA 领域导读 |
扩展三域(AI / 前端 / SEO)
这三个域与主线互补而非从属:主线回答"系统哪里慢、怎么跑得快",扩展域回答"代码该怎么写、页面怎么组织、怎么被搜索到"。
| 域 | 一句话 | 入口 | 核心文档 |
|---|---|---|---|
| ai-tools/ | AI 如何参与代码生产:Agent/Skill、MCP、Prompt | AI 编程工具 | 导读 · Agent vs Skill · MCP 协议 · CLAUDE.md 指南 · Prompt 方法论 · 效率量化 · Claude Code CLI · GitHub Copilot · Cursor/Windsurf · CodeGraph |
| fe/ | 前端技术演进:静态网页 → SSR → SPA → 微前端 | 前端技术 | 导读 · 演进导读 · 静态网页时代 · SSR · AJAX 与 SPA · MVC/MVVM · 前端框架全景 · 虚拟 DOM 与响应式 · 构建工具演进 · SSR/SSG 与元框架 · 微前端架构 · VitePress 专篇 |
| seo/ | 搜索引擎优化:工作原理、技术 SEO、内容 SEO | SEO 技术 | 导读 · 搜索引擎工作原理 · 技术 SEO · 核心指标与工具 · 什么是网站权重 · 内容与关键词 SEO · 前端框架与 SEO · 本站 SEO 落地实践 |
传统工具(perf/strace)回答"系统哪里慢了",AI 工具回答"代码该怎么写/改";前端技术回答"软件怎么组织",SEO 回答"怎么让页面被搜索到"——三者与主线互为补充。
全栈十域(语言 / 后端 / 数据库 / 云原生 / 协议 / 架构 / SRE / 安全 / 工程 / AI)
下方十域覆盖业务开发全链路(语言/后端/数据库/云原生/协议/架构/SRE/安全/工程/AI)。它们把站点的知识半径从"性能与底层"扩展到业务开发全链路,与主线形成互补:底层功底(缓存/锁/并发/网络)正是数据库、后端、云原生场景的性能根基。
| 域 | 一句话 | 入口 | 覆盖内容 |
|---|---|---|---|
| languages/ | 主流语言上手与进阶:OOP/C/C++/汇编/Go/Rust/Python/TS/Shell/Java/Vim | 语言教程 | 面向对象编程(封装继承 + 多态接口 + SOLID 设计原则)、Java 核心(JVM 内存模型 + 并发与 JUC + Stream 函数式)、C 语言(入门 78 篇编号文档 + 指针深入 + 编译链接与 ELF)、C++ 现代特性(入门 64 篇 + 高手 20 篇:RAII 与智能指针 + 移动语义 + 模板与泛型;专家 13 篇(含 CRTP 奇异递归模板):虚函数虚表 + 对象内存布局 + 模板实例化 + 内存序深入)、Go 实战入门(导读 + 并发模型 + 内存模型 + pprof 剖析)、Rust 快速上手(导读 + 所有权与借用 + 生命周期/trait + 错误处理与异步)、Python 进阶(导读 + 生成器/装饰器 + GIL/asyncio + 性能优化)、TypeScript 从 JS 到 TS(导读 + 类型系统 + 泛型与类型体操 + 工程配置)、Lua 嵌入式脚本(导读 + 语法与数据模型 + 与 C 互调 + 游戏/配置场景)、Shell 编程(约百个命令按七大族八篇)、Vim 编辑器(快捷键速查 + vimrc 编程) |
| backend/ | 后端开发:HTTP/gRPC、多语言框架、API 设计、鉴权、中间件 | 后端开发 | Node.js、Spring Boot、Gin、FastAPI、消息中间件、微服务 |
| database/ | 关系型/非关系型原理与优化 | 数据库 | MySQL 索引/锁/事务、Redis、PostgreSQL、分库分表 |
| cloud/ | 容器与云原生:Docker/K8s/CI/CD | 云原生 | Pod 调度、Service/Ingress、Helm、GitOps、Service Mesh |
| protocols/ | 网络协议:TCP/IP、HTTP、TLS、QUIC、DNS | 网络协议 | 抓包实战、负载均衡、WebSocket/SSE |
| architecture/ | 架构与设计:模式、DDD、CQRS、分布式 | 架构设计 | GoF 23 设计模式(六大设计原则独立成文 + 创建型5 篇/结构型7 篇/行为型11 篇每模式一篇,均含"不用 vs 用"类图对比,配套 demos/design-patterns 可运行代码)、微服务拆分、事件驱动、一致性 |
| sre/ | 可靠性工程:SLO、监控、混沌、容量 | SRE | 限流熔断降级、故障演练、高可用 |
| security/ | 安全:OWASP、加密、认证授权、密钥管理 | 安全 | Web 攻击、TLS 实践、供应链安全 |
| engineering/ | 软件工程实践:Git、测试、重构、评审 | 工程实践 | Git 操作手册(导读 + 8 篇按子命令拆分:config/init/clone · status/add/commit · log/show/blame · branch/merge · remote/fetch/pull/push · reset/revert/restore · rebase/cherry-pick/stash · tag/bisect/reflog)、测试金字塔、TDD、Code Review、文档规范 |
| data-ai/ | 数据与 AI 应用:Pandas、Prompt、RAG、Agent | 数据与 AI | 向量数据库、LLM 应用工程、ML 入门 |
| middleware/ | 开源中间件与高性能基础库(源码视角):事件循环、网络框架、缓存协调、消息队列、存储检索 | 开源中间件 | libevent/libev/libuv、Netty/muduo、Memcached/ZooKeeper/etcd、RocketMQ/Pulsar、RocksDB/ClickHouse/ES |
全栈十域与主线的衔接点:MySQL 锁竞争 ↔ 缓存一致性;Redis 延迟分析 ↔ perf 工具;K8s 资源限制 ↔ cgroup;HTTP/3 ↔ QUIC 与拥塞控制。每个全栈主题都会在合适位置回指底层原理文档。
二、知识版图:五层金字塔
把全部文档按抽象层次摞起来,是一座金字塔——越往上越贴近日常排查,越往下越接近硬件本质:
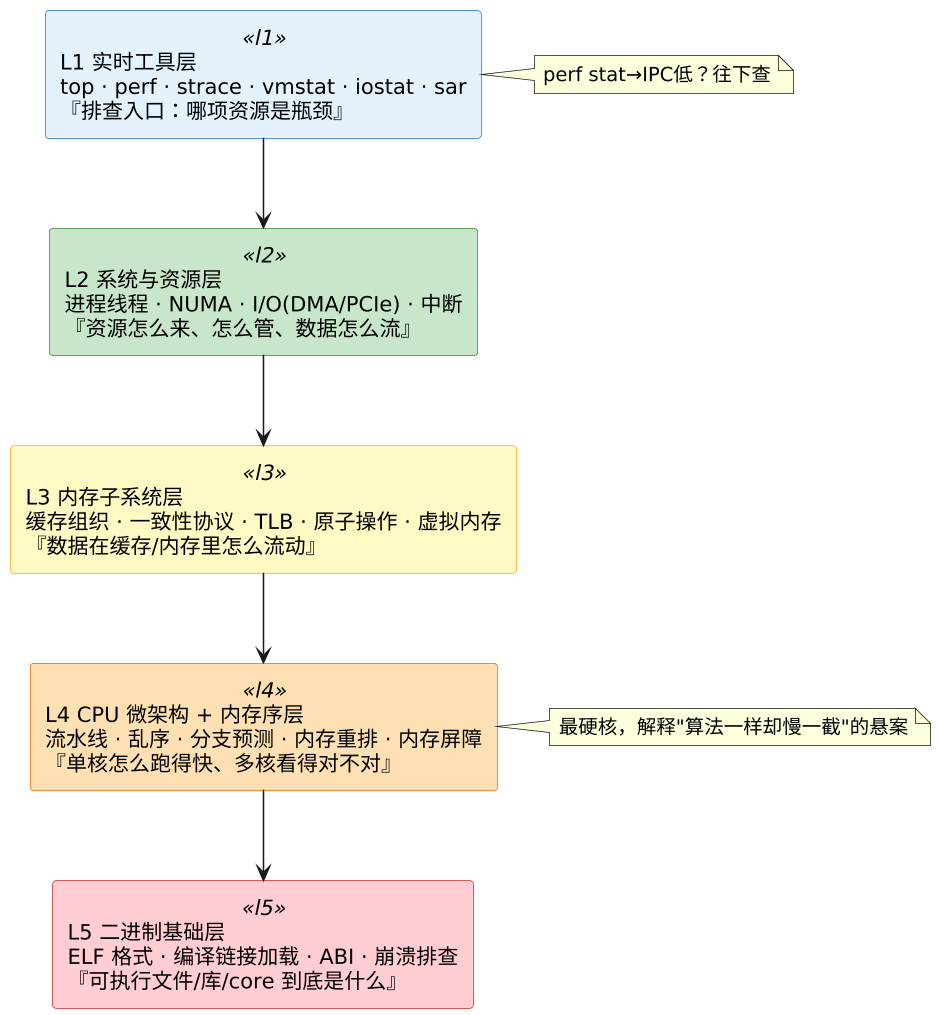
两层辅助翼(挂在金字塔两侧):
- 左侧翼:崩溃排查(crash/):core dump · 信号 · ASan · TSan · Valgrind
- 右侧翼:可跑示例(demos/):cpu-demo · 编译器重排 · 崩溃信号 · TLB 抖动
L5 是 L1-L4 的共同地基——perf 读符号、GDB 解析 core、strip 分离调试信息,本质都在操作 ELF。
三、各层文档速查
下表给出每层的骨架与代表文档(完整清单见侧边栏导航与各子目录 README)。每个链接都直达对应文档。
L1 实时工具层 —— 排查从这里开始
完整索引见 tools/;工具定位对比见 compare;深度对比与综合使用见 tool-perf-comprehensive-guide。标准流程:vmstat 定大方向 → 按维度展开。
| 维度 | 文档 | 一句话 |
|---|---|---|
| CPU / 进程 | top · pidstat · mpstat · vmstat · turbostat | 资源占用与瓶颈大方向 |
| 调度观测 | chrt · scheduling-observation | 实时优先级、调度全貌 |
| 代码级定位 | perf · perf-internals · strace · gdb | 热点函数、系统调用、崩溃还原 |
| 磁盘 | iostat · iotop | IO 吞吐与延迟 |
| 内存 | free | 内存余量与 swap |
| 网络 | ss · lsof · rdma | 连接、端口、fd |
| NUMA | numactl · numastat | 多路机内存亲和 |
| 历史复盘 | sar | 事后看历史曲线 |
| 访问流量 | GoAccess · Umami | 服务器日志 / 浏览器埋点统计 |
| 数据总枢纽 | procfs · kernel-tuning · tuned | /proc、sysctl、tuned profile |
L2 系统与资源层
进程与线程(内核视角)
导读:concepts/process/;工具速查:mpstat · pidstat · chrt · strace
| 子主题 | 文档 |
|---|---|
| 内核身份证 | task-struct(先读建立全局观)+ task-resources/ 13 篇: task-private · mm-struct · files-struct · fs-struct · signals-kernel(导读+分类·传递路径·数据结构·性能)· signals-user(导读+API·十大坑·Demo)· signals-alternatives(signalfd/eventfd/timerfd/futex 快 ~10×)· cred · namespaces-cgroups · io-context |
| VFS 绑定 | vfs-binding(进程与 VFS 挂载树、路径解析、fork 时 CoW) |
| 调度与切换 | scheduling(导读+队列·调度类与CFS·切换时机)· context-switch(导读+分类·实现·开销·实战)· thread-affinity · real-time-scheduling · linux-cpu-isolation-isolcpus-nohz(isolcpus 尾延迟实测 / NO_HZ_FULL 边界)· scheduling-interrupts |
| 创建与生命周期 | process-creation(fork/exec/CoW)· thread-creation · thread-startup · fork-and-threads · vfork |
| 陷入内核 | syscall · syscall-details · segment-management(导读+演进·GDT与特权级·观测·寻址)· interrupts(导读+分类与设计·流程·上下半部·开销)· irq-affinity |
| 信号机制 | signal-multithread |
| 进程组与回收 | process-group-and-child-reap · waitpid-kernel-internals · zombie-case |
| 内核调试 | kernel-stack-snapshot(/proc/pid/stack、sysrq、perf sched) |
| 前置知识 | x86-64-registers |
| 检查点与重启 | dmtcp(DMTCP / CRIU 对比) |
| 进程追踪 | ptrace(strace/gdb 底层、与 BPF 对比) |
NUMA / I/O / 虚拟内存 / VFS
| 子域 | 导读 | 文档 |
|---|---|---|
| I/O 入口 | concepts/io/ | 子域导航:DMA / 中断控制器 / PCIe / I/O 编址 / read-write / FPGA |
| NUMA | concepts/numa/ | numa · numa-optimization · paper(工具:numactl · numastat) |
| DMA | — | dma-8237(祖宗)· dma(Bus Mastering + SG-DMA + DDIO)· dma-cpu-interaction · dma-multi-channel |
| 中断控制器 | — | 8259(PIC 祖宗)· 投递见 irq-affinity §二 · 内核处理见 interrupts |
| PCIe | concepts/io/pcie/ | pcie · pcie-link-training · pcie-firmware-enum · pcie-pre-enumeration · pcie-enumeration · pcie-bar-activation |
| I/O 编址 | — | io-addressing(PMIO vs MMIO、Posted Write) |
| read/write 链路 | — | read-write-process · cpp-io-separation |
| FPGA 通信 | — | fpga-communication(Linux 与 FPGA 六种通信方式) |
| 虚拟内存 | — | mmap · shared-memory |
| VFS | concepts/vfs/ | vfs-overview · vfs-from-process · vfs-file-operations · vfs-and-socket · fuse · special-filesystems |
VFS 是 fd 表的下游、syscall 的下一站、read/write 的必经之路——
file->f_op->read()让 ext4/pipe/socket/procfs 共享同一套系统调用。
L3 内存子系统层
导读:concepts/cache/(四条线全景)
| 子主题 | 文档 |
|---|---|
| 缓存组织 | cache-organization(导读+寻址·映射·访问流程)· i-cache · tlb("改步长性能暴跌"之谜)· page-table-translation · memory-alignment · cache-friendly-code |
| 一致性协议族 | msi → mesi(导读+协议机制·伪共享)· mesi-variants(MOESI/MESIF/Dragon)· comparison |
| 原子与内存模型 | atomic · memory-model(导读+内存序·屏障与架构差异) |
| 编译优化 | compile-options(GCC 优化选项性能差异、汇编分析) |
L4 CPU 微架构 + 内存序层
最硬核的一层,三条正交的线:
| 线 | 子目录导读 | 文档 |
|---|---|---|
| 微架构(单核怎么跑得快) | concepts/microarch/ | cpu-microarch-overview(演进链)· cisc-risc(★CISC 壳 RISC 芯)· pipelining-superscalar(导读+流水线基础·超标量设计·IPC 瓶颈)· data-hazards(导读+RAW·访存 RAW·假依赖·miss 连锁)· cpu-out-of-order(导读+机制·重命名与顺序退休·边界)· branch-prediction · indirect-branch-prediction · 超标量部件:reservation-station · rob · lsu · register-renaming · scoreboard-vs-tomasulo-compare(动态调度两条路线) · ★uop-pipeline-walkthrough(µop 级走读,导读+µop 类型与关键机制·三条指令走读·对比·buffer) |
| 内存序(多核看得对不对) | concepts/memory-ordering/ | reordering-overview(编译器 ≠ CPU ≠ 内存重排)· compiler-reordering · memory-reordering · store-buffer · invalidate-queue · memory-order(C++ 语义) |
| 系统架构(CPU 怎么拼装、总线怎么连) | concepts/cpu/ | cpu-bus-architecture · cpu-physical-hierarchy · core-and-uncore · pmu(PMU 硬件计数器、PEBS/IBS)· on-die-interconnect(Ring/Mesh/IFOP)· off-chip-buses(DDR/PCIe/UPI)· cxl · system-diagnosis-tools(lstopo/lscpu/lspci/dmidecode)· numa-optimization |
L5 二进制基础层
导读:concepts/elf/(ELF 格式 → 加载 → 地址空间 → 工具 四块全景)
| 子主题 | 文档 |
|---|---|
| ELF 与工具 | elf-format · symbol-table · text-data-bss · plt-got · relocation · init-fini · eh-frame · meta-sections · compile-link-load · memory-layout · library-injection(LD_PRELOAD/ptrace 注入)· readelf · objdump · nm · ldd · misc |
| ABI | c-abi · c++-abi |
| 崩溃排查 | 导读 crash/: core-dump · core-dump-performance · symbol-separation · signals · double-free · asan · tsan · valgrind |
四、推荐阅读路径
不必从头读到尾,按你的目的选一条路线:
入门
- 会用工具查 CPU 问题:首页 → top → pidstat → perf
- 看地址判断内存类型:memory-layout(栈/堆/代码/库/内核/空指针速判)
- 搞懂程序怎么跑起来的:compile-link-load → elf-format → process-creation → thread-startup
进程 / 内存 / 并发
- 搞懂 fork/线程/进程创建:task-struct → process-creation → thread-creation → fork-and-threads
- 搞懂 fork 卡死与 vfork 实战:vfork(四类根因 / 根治方案)→ waitpid-kernel-internals → zombie-case
- 搞懂进程组与子进程正确回收:process-group-and-child-reap → waitpid-kernel-internals → zombie-case
- 搞懂内存怎么来的(mmap/malloc):mmap → memory-layout → process-creation(CoW)
- 搞懂系统调用到底发生了什么:syscall → syscall-details → segment-management
- 搞懂并发内存序、
std::atomic:reordering-overview → memory-order → store-buffer - 搞懂多核缓存一致性:msi → mesi → comparison
性能优化
- 搞懂"多线程反而更慢":mesi-false-sharing(伪共享)→ cache-organization → atomic
- 搞懂"算法一样却慢一截":cpu-microarch-overview → branch-prediction / indirect-branch-prediction / tlb
- 怎么写快代码(缓存友好):cache-friendly-code → memory-alignment / mesi-false-sharing(伪共享)
- 低延迟:绑核/消除抖动:scheduling → thread-affinity → numactl
硬件 / I/O
- 搞懂 CPU 内部结构、总线拓扑:cpu-bus-architecture → numa → io-addressing → pcie
- 搞懂"NVMe 带宽跑不满、PCIe 拓扑瓶颈":cpu-bus-architecture(直连 PCIe vs Chipset/DMI 瓶颈)→ pcie(带宽/Lane 详解)
- 搞懂 DMA 怎么工作:dma-8237(8237——"祖宗")→ dma(Bus Mastering + SG-DMA)→ dma-cpu-interaction → dma-multi-channel
- 搞懂中断控制器怎么进化:8259(PIC——"祖宗")→ irq-affinity §二(APIC/xAPIC/x2APIC/MSI-X)→ interrupts(导读,完整处理流程见处理流程)
网络 / 存储 / FPGA
- 搞懂网络高并发(C10K→C10M):network/overview → io-models → epoll → thread-models → kernel-tuning-net / zero-copy / tcp-flow-congestion-control
- 搞懂"网卡收包中断为什么全在 CPU0":rss → irq-affinity → mpstat
- 搞懂存储性能差异:storage-performance → direct-io-vs-pagecache → io-uring-deep → zero-copy-deep
- 搞懂容器原理 / vs 虚拟机 / 性能:namespaces-cgroups → container/overview → container-vs-vm / performance
- 搞懂低延时设计全貌:low-latency-patterns(导读)→ lockfree-deep(无锁编程)→ rcu-internals(RCU 内核)→ concurrency-benchmarking(测量方法论)
- 搞懂量化 FPGA 架构:quant-fpga-architecture(导读)→ feed-handler(行情解码)→ order-execution(订单执行)→ hardware-integration(部署运维)
调试 / 崩溃
- 进程崩了要分析 core:core-dump → elf-format → symbol-separation
- 进程为什么崩(信号/内存 bug):signals → asan / tsan / valgrind
- 深入内核调试与 panic 分析:kernel-debug → kernel-stack-snapshot → signals
完整体系
- 系统学习整个知识体系:
- 自底向上(先懂基础,再学工具):L5 → L4 → L3 → L2 → L1
- 自顶向下(先会用,再挖原理):L1 → L2 → L3 → L4 → L5
五、应用域:跨层综合场景
这些主题横跨金字塔多层,从 L1 工具 → L2 系统配置 → L3 内核机制,是"把原理用起来"的实战入口。
网络低延时与高并发
- 导读:overview(C10K→C10M)
- IO 模型:io-models(五种 IO 模型 / io_uring)· select/poll/epoll 对比(序列图深度对比 / 选型速查)· io-model-latency(量化分析)
- Epoll:epoll(红黑树+就绪链表 / LT/ET / 惊群)
- 线程模型:thread-models(Reactor/Proactor / SO_REUSEPORT)· accept-bottleneck(单点 Accept 瓶颈)
- 内核调用链:socket-kernel-internals · listen-kernel-internals · accept-kernel-internals
- 内核调优:kernel-tuning-net · kernel-stack-optimization(队列长度 / 中断绑定 / RPS/RFS)
- 零拷贝:zero-copy(sendfile/splice)· zero-copy-deep(mmap/sendfile/splice/io_uring)
- TCP 控制:tcp-flow-congestion-control(CUBIC vs BBR)· tcp-nodelay · tcp-timewait(TIME_WAIT / 端口耗尽 / tcp_tw_reuse / 连接池)· linux-tcp-connect-cost-timewait(端口耗尽实测 / tw_reuse 突发边界)
- 硬件分流:rss(Toeplitz 哈希/间接表 / RPS-RFS-XPS-FDir 全线对比)· linux-rps-rfs-xps-softirq(单队列软件分流实测 / received_rps 对账 / 8% 固定成本)
- RDMA:rdma
存储优化
- storage-performance —— HDD/SSD/NVMe 性能差异与选型、随机/顺序读写量化、IO 队列深度与 IOPS
- direct-io-vs-pagecache —— Direct IO vs 页缓存深度对比:两条 IO 路径全景、预读/回写/回收机制、性能量化、场景决策树
- io-uring-deep —— io_uring 框架深入:SQ/CQ 环形缓冲区、三种操作模式、零拷贝/buffer 注册、与 SPDK 对比
- linux-blk-mq-iodepth-scaling —— fio 实测 iodepth 1 到 32 的吞吐拐点与延迟代价,Little 定律解释队列深度怎样换 IOPS
- linux-page-cache-hit-ratio-measure —— mincore + diskstats 实测页缓存命中率:热顺序读为何仍读盘、缓冲随机读为何反输 O_DIRECT
- linux-dirty-writeback-tuning —— dirty_ratio 三档实测:过程卡顿与 fsync 尾部延迟的取舍,balance_dirty_pages 限流机制
- linux-filesystem-ext4-xfs-meta —— 同盘双 loop 2 万小文件对照:ext4 创建快 58%、删除快 40%,xfs 遍历微弱反超,含选型边界
容器
- overview —— 三大支柱 namespace/cgroup/overlayfs / runc 启动流程
- container-vs-vm —— 容器 vs 虚拟机 / KVM / Kata / gVisor
- performance —— 性能损耗:网络/存储/cgroup 限流
- 内核底座:namespaces-cgroups
低延时设计模式
- low-latency-patterns —— 导读:忙等待 vs 睡眠调度、无锁编程与 RCU 原理、高并发队列设计、量化分析
- shm-vs-network —— 共享内存 vs 本机 TCP:为什么快 2~3 个数量级(逐段拆解、量化对比表、适用边界)
- lockfree-deep —— 无锁编程深入:CAS/FAA/Michael-Scott Queue/Treiber Stack、内存回收四方案、ABA 问题
- spsc-mpsc-queue —— 消息队列四象限(SPSC/SPMC/MPSC/MPMC):无锁环形实现、SPMC 广播 fan-out、MPSC 单点 CAS、release/acquire 内存序、选型决策树
- cpp-mutex-types —— C++ 标准库互斥量类型详解:mutex/recursive/timed/shared 能力组合、底层实现、性能特征与选型决策树
- rcu-internals —— RCU 内核实现:宽限期/静默态、Tree RCU/SRCU、synchronize_rcu 开销分析
- concurrency-benchmarking —— 基准测试方法论:干扰源消除、rdtsc/HdrHistogram、Little's Law、框架设计
C++ 性能实测
- cpp-lto-thin-full-benchmark —— LTO 链接时优化三档实测:无 LTO / 全量 LTO / ThinLTO 的构建耗时、二进制体积、运行性能对照与反汇编证据
- cpp-pgo-two-stage-benchmark —— PGO 两阶段实测:插桩训练、剖面合并、引导重建全流程,同分布 1.45 倍与错位分布 1.10 倍收益对照,含 divl 退化反汇编证据
- cpp-virtual-devirtualization-conditions —— 虚函数去虚化五形态三档实测:final/LTO 不充分,PGO 猜测性去虚化的守卫比较与内联冷兜底反汇编证据
- cpp-exception-vs-error-code-cost —— 异常/错误码/Expected 三机制两路径实测:成功路径同量级,抛出路径慢约 3000 倍、单次约 6 μs,含人格 routine 与异常表段证据
- cpp-rvo-nrvo-move-noexcept —— RVO/NRVO/移动语义实测:C++17 保证复制消除边界、noexcept 决定 vector 扩容移动还是拷贝,缺 noexcept 慢约 3.8 倍
- cpp-shared-ptr-refcount-contention —— shared_ptr 四模式六档线程扫档:每任务拷贝致加速比仅 0.27–0.31 的负扩展,7 条 lock 原子指令与缓存行乒乓机理证据
- cpp-std-function-heap-alloc-threshold —— std::function SBO 阈值实测:24 字节内零堆分配、越界构造贵 2.2 倍,过对齐 3.9 倍,含对齐版 new 重载与 O2/O0 双档对照
配套工具链:
- perf 工具指南(perf 子命令系统指南:stat/top/record/report/annotate/trace/probe/c2c/lock/sched,每个子命令独立成篇)
- perf-advanced(perf 导航页:案例、方法论、最佳实践汇总)
- perf-version-evolution(perf 版本能力差异:3.10/4.x/5.x/6.x 在子命令/probe 语法/事件计数三主线差异与排查)
- perf-multithread-io-analysis(perf 三步分析法:宏观体检→拆线程→异常模式深入)→ 配套实验 mt-io-demo
- perf-probe 基础实验(uprobe/USDT 动态插桩)→ 进阶 C++ 成员函数探针实验(mangled 名 / 重载 / 模板 / 虚函数 /
this抓取 / 符号可见性) - ftrace-guide(ftrace 内核追踪:调度/中断/系统调用延迟)
- latencytop-guide(latencytop/sysstat 系统级性能工具)
- latency-measurement(精准测量延迟:tsc/rdtsc、clock_gettime)
量化交易中的 FPGA 应用架构
- quant-fpga-architecture —— 导读:tick-to-trade 延迟预算分解、CPU+FPGA 混合架构哲学、四种典型架构模式对比
- feed-handler —— 行情解码子系统:沪深 FAST/STEP 协议五级流水线、乒乓缓存、部分重配置、量化基准 380ns @200MHz
- order-execution —— 订单执行子系统:模板填充引擎、硬件化风控、PIO/CTPIO 发送、FPGA TCP 卸载
- hardware-integration —— 硬件集成与部署:板卡选型、Colocation 拓扑、PTP 时钟同步(±50ns)、双机热备、运维监控
已有基础:fpga-communication(Linux 与 FPGA 六种通信方式)· dma · pcie
调试与调优工具链
子索引:concepts/debug/
- kernel-debug —— 内核调试:sysctl 调优、内核崩溃 panic 分析
- pmu —— PMU 性能监控单元:CPU 硬件计数器架构、PEBS/IBS、vPMU
- cpp-debug —— C/C++ 高级调试:GDB 断点/观测点/汇编调试、Core dump 高级分析、内存泄漏与碎片量化
六、可运行示例与内核参数速查
demos/ —— 把原理跑起来(导读)
- cpu-demo —— 核心靶子程序:三场景 CPU 性能演示(用户态计算 / syscall 风暴 / 空闲),本仓库所有工具文档和 perf 案例的"实验对象"
- compiler-reordering —— 编译器重排:亲眼看到编译器怎么改你的代码顺序
- branch-predict —— 分支预测实验:有序 vs 随机数据 + if vs 无分支,perf stat/report/annotate 三层定位,核心发现「无分支比完美预测还快 32.5%」
- indirect-branch —— 间接分支预测实验:虚函数单态/双态/巨态、函数指针、switch 跳转表,
branch-loads/branch-load-misses对比 - crash-signals —— 崩溃信号:实际触发 SIGSEGV/abort 并分析 core dump
- tlb-thrashing —— TLB 抖动:固定迭代、增大步长,亲眼看到 L2 STLB 触顶的断崖
- cache-miss —— 缓存未命中实验:不同访问步长/行列遍历下 cache miss 与耗时对比
- false-sharing —— 伪共享实验:多线程争用同一 cache line 的性能崩塌演示
- lock-contention —— 锁竞争实验:不同锁粒度/自旋与互斥在高并发下的吞吐差异
- perf-bench-diff —— perf bench 差异实验:同一操作不同实现/不同优化级别下的测量对比
- sched-latency —— 调度延迟实验:线程优先级/调度策略对延迟的影响测量
- stall-analysis —— 停顿分析实验:阻塞点/等待链路的定位与量化
- syscall-trace —— 系统调用追踪实验:strace/perf trace 下的系统调用开销剖析
- mt-io-demo —— 多线程 I/O 实验(D14):配合 perf 三步分析法 的宏观体检→拆线程→异常模式定位
- perf-probe —— uprobe/USDT 动态插桩实验,进阶 C++ 成员函数探针(mangled 名/重载/模板/虚函数/
this抓取)
projects/ —— 综合实战项目(导读)
- echo —— 百万 QPS TCP 长连接实战项目:综合网络 + 性能 + 架构。覆盖 FD 耗尽、TCP 内核参数调优、软中断/RSS 多队列、NUMA 进程/中断绑核、百万长连接承载、TIME_WAIT/端口耗尽、分层 echo 业务设计。配套 架构设计、分析指南
parameter/ —— 内核参数速查
| 分类 | 文档 | 覆盖指标 |
|---|---|---|
| CPU | cpu-usage | %usr/%sys/%idle/%iowait/%irq/%softirq/%steal — 八类 CPU 时间 |
| loadavg | load average(1/5/15min)— R+D 态统计、EWMA 算法、常见误区 | |
| 内存 | memory-usage | MemAvailable、Swap si/so、Page Fault major/minor、OOM score |
| IO | iowait | %iowait、iodelay、cswch/s、%wait — 四大场景时序图与统计窗口 |
| disk-io | await/svctm/%util、IOPS、吞吐量、队列深度 | |
| 网络 | net-stats | 网卡丢包(rxdrop)、TCP 重传、连接状态、UDP 丢包 |
| 调度 | context-switch | cswch/s(自愿)、nvcswch/s(非自愿)、%wait、cs |
七、贯穿全仓库的一条暗线:IPC 低了,去哪查
大量"性能悬案"最终都收敛到一个问题——CPU 没被喂饱(IPC 低)。这条暗线把 L4 微架构和 L3 内存子系统串了起来:
- cache miss,等内存几百拍 → 数据布局差 / 伪共享:cache-organization · mesi
- TLB miss,走 page walk → 访问跨度大、页数超 TLB:tlb
- 分支误预测,清空流水线 → 分支方向随机:branch-prediction;间接分支目标随机:indirect-branch-prediction
- 长依赖链,ILP 不足 → 指令强依赖,喂不满超标量:cpu-out-of-order
- 跨核抢同一 cache line → 伪共享 / 原子争用:mesi · atomic
- 未对齐访存被拆分/跨 line → 数据未对齐、结构体压扁:memory-alignment
- 内存访问延迟异常高 → 跨 Socket 远程 NUMA / 跨 CCD:numa · cpu-bus-architecture
- I/O 延迟大但 CPU 不高 → PCIe/DMI 总线带宽瓶颈:cpu-bus-architecture · pcie
- 单核 %soft 100%、其他核空闲 → 网卡单队列 / RSS 未开 / 中断未分散:rss · linux-rps-rfs-xps-softirq · irq-affinity · mpstat
- 存储 IO 延迟抖动 → IO 调度器 / 队列深度 / page cache:storage-performance · read-write-process
统一观测入口:perf stat(perf)看 IPC,低了就顺着上表往下查。
八、约定
- 语言:文档正文以中文为主。
- 风格:每篇用 PlantUML 图 + 表格讲解,章节末尾常有**「一句话」总结**。
- 靶子程序:
demos/cpu-demo/main.cpp→cpu_demo(make编译,Linux 上运行,见 首页)。 - 平台:
demos/cpu-demo/main.cpp读/proc,只能在 Linux 运行(macOS 能编译不能跑)。 - 链接规范:所有 .md 文件内统一使用相对路径,兼容本地浏览与 Docsify 部署。
一句话:这个仓库是三条主线的系统学习路径——集成电路与 EDA(设计流程 → 验证 → 时序 → 流片,开源工具真跑)、AI 编程(工具选型 → Agent 原理 → 实战工作流)、底层与性能(L5 二进制基础 → L4 CPU 微架构+内存序 → L3 内存子系统 → L2 系统与资源 → L1 实时工具),外挂四大应用域(网络/存储/容器/低延时)、崩溃排查、可跑示例与内核参数速查。按 tools/ 查工具、按 concepts/ 查原理、按本篇看地图。
总结
本站以集成电路与 EDA、AI 编程工具、Linux 性能剖析为三条主线:IC 域覆盖芯片设计全流程与开源 EDA 实跑,AI 域覆盖 Coding Agent 原理与工具实战,底层域按五层金字塔组织观测工具、系统资源、内存子系统、CPU 微架构与 ELF 二进制,并扩展语言、后端、数据库、云原生等全栈域;本页是总知识地图与按身份选路入口。