导致 Crash 的信号及其根因 —— 从"进程为什么死"倒推 bug
core-dump 讲的是"进程死了以后怎么还原现场"(转储机制 + GDB);本篇讲的是进程为什么会死——哪些信号会杀死进程、每个信号背后的根本原因、以及怎么从信号反推出代码里的 bug。二者互补:先靠本篇缩小怀疑范围(是内存问题?算术问题?外部杀?),再靠 core-dump.md 挖出确切那一行。
一、信号机制速览
信号(signal)是内核发给进程的异步通知——一张"软件中断"。进程收到信号后,按该信号的默认动作处理(除非自己注册了 handler)。默认动作分四类:
| 默认动作 | 含义 | 会不会 crash |
|---|---|---|
| Term | 直接终止进程 | 会(进程没了),但不产生 core |
| Core | 终止进程并生成 core dump | 会,且留下现场 |
| Ign | 忽略,什么都不做 | 不会(如 SIGCHLD) |
| Stop | 暂停进程(不是杀死) | 不会(如 SIGSTOP/SIGTSTP) |
导致 crash 的,就是默认动作为 Term 或 Core 的那批信号。
同步信号 vs 异步信号(判案的第一刀)
这个区分决定你往哪个方向查:
| 类别 | 来源 | 触发时机 | 典型信号 | 排查方向 |
|---|---|---|---|---|
| 同步信号(synchronous) | CPU 异常,进程自己"作的" | 执行到某条出错指令的当下,精确同步 | SIGSEGV/SIGBUS/SIGFPE/SIGILL | 查自己的代码:非法内存、除零、坏指令 |
| 异步信号(asynchronous) | 外部(其他进程 / 内核 / 用户) | 任意时刻从天而降,与当前指令无关 | SIGKILL/SIGTERM/SIGQUIT/SIGINT | 查外部:谁 kill 了它?OOM?运维脚本? |
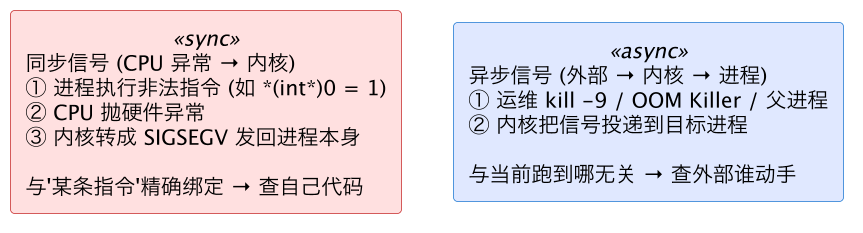
一个关键推论:同步信号的崩溃点(
rip)就是出事指令本身,所以bt通常能直接指到 bug 行;异步信号打断的是"当时正好在跑的任意一行",栈顶那行往往无辜,别被误导。
二、逐个信号 + 根因(核心)
📁 本节每种信号都有可跑的最小复现:../../demos/crash-signals/ ——
make run逐个触发、打印退出码(128+信号号)并翻译成信号名。
2.1 SIGSEGV (11) —— 段错误,最常见的 crash
本质:访问了一个非法的虚拟地址——要么这个地址没被映射(不属于任何段),要么权限不对(往只读区写、把数据当代码执行)。判断"地址落在哪个段、合不合法",靠的就是 memory-layout 的地址速判表。
常见根因:
| 根因 | 典型代码 | 崩溃地址特征 |
|---|---|---|
| 空指针解引用 | int *p = nullptr; *p = 1; | 出错地址 0x0 附近(0x0/0x8/0x10) |
| 野指针 / 未初始化指针 | int *p; *p = 1;(p 是栈上垃圾值) | 地址随机、五花八门 |
| 悬垂指针 / use-after-free | free(p); *p = 1;(p 指向已释放堆) | 地址在堆区、但内容已被复用 |
| 数组越界(写) | int a[10]; a[100000] = 1; | 地址超出该数组所在段 |
| 栈溢出(深递归 / 巨大局部数组) | 无限递归、char buf[100*1024*1024] | 撞到栈的 guard page,见 memory-layout.md 6.1 |
| 写只读内存 | char *s="hi"; s[0]='H';(改字符串字面量) | 地址落在 .rodata/.text(只读段) |
// 五种 SIGSEGV 一览
int *p1 = NULL;      *p1 = 1;              // 空指针
int *p2;             *p2 = 1;              // 野指针(p2 是栈垃圾)
int *p3 = new int;   delete p3; *p3 = 1;   // use-after-free
int  a[10];          a[1000000] = 1;       // 越界
char *s = "hello"; s[0] = 'H'; // 写只读段(字符串字面量)为什么写字符串字面量崩:
"hello"被编译器放进只读的.rodata段,页表标了不可写,一写就触发保护异常 → SIGSEGV。这也是 C++ 里char *s = "..."被废弃、要用const char *的原因。
2.2 SIGABRT (6) —— 程序主动"自尽"
本质:不是硬件异常,而是程序(或它依赖的库)主动调用 abort() 举白旗——"我发现自己状态已经烂了,与其带病继续跑,不如当场停下留个现场"。
常见根因:
| 根因 | 触发者 | 现场特征(dmesg/输出) |
|---|---|---|
| assert 失败 | assert(x>0) 不成立 | 打印 Assertion 'x>0' failed |
| C++ 未捕获异常 | throw 没人 catch → std::terminate → abort | terminate called after throwing... |
| double free | 同一块堆 free 两次 | free(): double free detected |
| free 非法指针 | free 一个非 malloc 返回的地址 | free(): invalid pointer |
| 堆元数据被踩坏 | 缓冲区溢出写坏了 malloc 的管理头 | malloc(): corrupted top size |
std::vector::at 越界 | v.at(999) 抛 out_of_range 没人接 | terminate called ... out_of_range |
// glibc 的堆检查主动 abort
char *p = malloc(8);
free(p);
free(p);          // double free → glibc 检测到 → SIGABRT
std::vector<int> v(3);
v.at(100);        // 抛 out_of_range,无 catch → std::terminate → SIGABRT
SIGSEGV vs SIGABRT 的直觉区别:SIGSEGV 是"CPU 抓现行"(硬件发现你越界了);SIGABRT 是"软件自查后自首"(glibc/assert/C++ 运行时发现内部不变量被破坏,主动喊停)。堆越界写往往先写坏元数据、当时不崩,直到下次
malloc/free时 glibc 校验才 SIGABRT——所以 SIGABRT 的崩溃点常常不是真正肇事的那行,要回溯指针生命周期。
深入:double free / 堆溢出为什么崩、崩在何处
上面表格说 double free、堆损坏会 SIGABRT,但为什么 free 两次就崩、崩点为什么不是肇事那行?得看一眼 glibc 堆分配器的底层——这也是排查堆 bug 最关键的直觉。
堆是用 chunk + 空闲链表管理的。glibc 的 malloc 把堆切成一个个 chunk(块),每块头部有元数据(大小、前后块状态)。free 一块 chunk 后不立刻还给内核,而是挂进一个空闲链表(tcache / fastbin / 普通 bin)等复用——而链表的 next 指针就借用 chunk 自身内部那段空闲空间来存(反正它空着)。
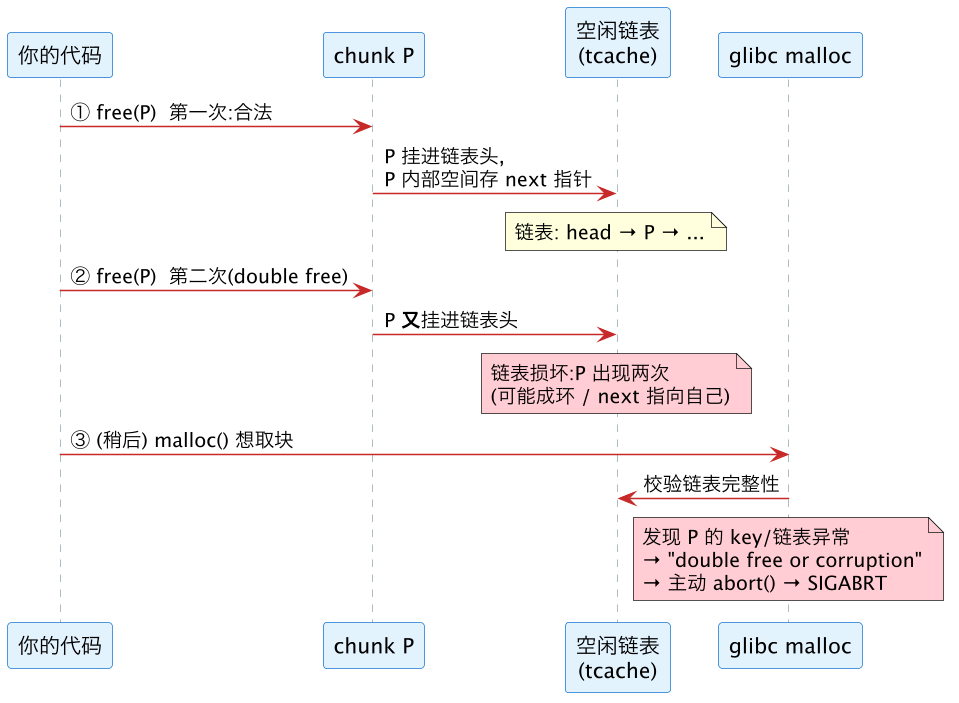
- double free 为什么崩:第二次
free(P)把同一 chunk 重复挂进链表,链表结构被破坏(P 出现两次、可能成环)。glibc 为此加了完整性检查——tcache 给每块存一个key字段,free时若发现 key 已是 tcache 标记,判为疑似 double free;fastbin 则检查"链表头是不是就是正在 free 的这块"。命中 → 打印free(): double free detected/double free or corruption→ 主动abort()→ SIGABRT。 - 堆溢出为什么也报 SIGABRT:越界写踩坏了相邻 chunk 的元数据头(size 等)。当时不崩;直到下次
malloc/free走到这块、glibc 校验 chunk 头发现大小不合法(如malloc(): corrupted top size)→ abort。 - 崩点 ≠ 肇事点(最重要的排查要点):注意上图 ③——真正崩的是"稍后那次 malloc/free 的校验",不是第二次 free 或那次越界写本身。所以 SIGABRT 的调用栈栈顶是 glibc 的
_int_malloc/_int_free,看不到真正肇事的代码。要往回追指针的生命周期(谁 free 的、谁越界写的),或直接上 asan/valgrind——它们能在肇事那一刻就抓住,而不是等 glibc 稍后自爆。 - use-after-free 为什么有时崩有时不崩:free 后那块内存可能已被重新分配成别的对象。UAF 写进去——若那块还没被复用,可能悄无声息;若已被复用,就改乱了别人的数据。不崩时是"静默数据损坏",比崩更难查——同样要靠 ASan 抓。
可运行的最小复现见 ../../demos/crash-signals/(
abrt_double_free.c/abrt_heap_overflow.c),make run直接看到 SIGABRT。
2.3 SIGFPE (8) —— 算术异常
本质:CPU 在执行算术指令时发现无法给出合法结果。名字里有 FP(浮点),但最常见的其实是整数运算。
常见根因:
| 根因 | 代码 | 说明 |
|---|---|---|
| 整数除以 0 | int a=1, b=0; a/b; | 最经典的 SIGFPE |
| 整数取模除以 0 | a % b;(b=0) | 同上 |
INT_MIN / -1 溢出 | INT_MIN / -1 | 结果 2147483648 超出 int 范围,CPU 抛异常 |
int a = 10, b = 0;
int c = a / b;              // 整数除零 → SIGFPE
int d = INT_MIN;
int e = d / -1; // 溢出 → SIGFPE(不是想当然的正常)反直觉点:浮点除零默认不触发 SIGFPE!
1.0 / 0.0按 IEEE 754 规矩返回inf(或0.0/0.0返回nan),程序照跑。只有整数除/模零、INT_MIN/-1才是硬异常。想让浮点异常也报 SIGFPE,得手动feenableexcept(FE_DIVBYZERO|FE_INVALID)。
2.4 SIGBUS (7) —— 总线错误
本质:地址本身合法(映射了、也有权限),但访问方式硬件不接受,或映射背后的物理存储出了问题。这是它和 SIGSEGV 最本质的分野。
常见根因:
| 根因 | 说明 | 关联 |
|---|---|---|
| 未对齐访问 | 在要求对齐的架构(老 ARM/MIPS/SPARC)上,int 落在非 4 倍数地址 | 见 memory-alignment 第二节 |
| mmap 文件被截断后访问 | mmap 了一个文件,之后文件被 ftruncate 缩短,再访问被砍掉的那段 | 地址在映射区内、但背后没有物理页可填 |
| 访问的物理地址无效 | 映射到不存在的设备内存等 | 硬件层面拿不到数据 |
// mmap 文件截断触发 SIGBUS 的经典场景
int fd = open("f", O_RDWR);
ftruncate(fd, 4096);
char *p = mmap(NULL, 8192, PROT_READ|PROT_WRITE, MAP_SHARED, fd, 0);
ftruncate(fd, 0);          // 把文件砍到 0
p[0] = 'x';                // 地址合法,但背后无物理页 → SIGBUS(不是 SEGV)
SIGSEGV vs SIGBUS 一句话:SEGV = 地址无效或无权限(这个地址你根本不能碰);BUS = 地址有效,但访问方式/物理后备有问题(能碰,但碰的方式不对,或碰下去发现底下是空的)。x86 上未对齐一般不崩(只是慢),所以 SIGBUS 在 x86 更多是 mmap 截断场景。
2.5 SIGILL (4) —— 非法指令
本质:CPU 取到一条无法识别或不允许执行的指令。指令流跑飞了,或跑到了不该跑的地方。
常见根因:
| 根因 | 说明 |
|---|---|
| 栈被破坏后跳到"数据"上执行 | 返回地址被越界写覆盖,ret 跳到一片数据区,把数据当指令译码 → 非法 |
| 函数指针乱飞 | 野的/被踩坏的函数指针,call 到一片非代码区 |
| CPU 不支持的指令 | 二进制用了 AVX-512,跑在不支持的老 CPU 上;或跨架构错跑 |
编译器插桩 __builtin_trap() | 编译器在"不可达"/UB 处插入非法指令主动崩溃 |
// 函数指针跑飞 → SIGILL 或 SIGSEGV
void (*fp)() = (void(*)())0xdeadbeef;
fp();                      // call 到非代码区,译码出非法指令 → SIGILL
__builtin_trap();          // 编译器插的"陷阱",主动触发非法指令
SIGILL 常和 SIGSEGV 同源:都是"控制流跑飞"(栈破坏、野指针)。区别在跑飞后落点的性质:落到没映射/无执行权限的地址 → SIGSEGV;落到能读能执行、但内容不是合法指令的地方 → SIGILL。所以栈溢出既可能报 SEGV 也可能报 ILL。
2.6 SIGTRAP (5) —— 断点 / 调试陷阱
本质:调试相关的陷阱。GDB 下断点,其实是把目标指令替换成 int3(x86 的断点指令),CPU 执行到就发 SIGTRAP,被调试器接住。程序单步、ptrace 也走它。
- 正常程序里几乎见不到——除非没在调试器下却收到了 SIGTRAP,那多半是:某些平台的
__builtin_trap()实现(如部分 ARM 上等价于断点指令)、或代码里显式int3/raise(SIGTRAP)。 - 有调试器时默认被拦截、不会杀进程;没有调试器接管时默认动作是 Core。
2.7 SIGKILL (9) / SIGTERM (15) —— 外部来杀
这两个是异步信号,和进程自己的代码无关,是"外面有人要它死"。
| SIGTERM (15) | SIGKILL (9) | |
|---|---|---|
| 语义 | "请你退出"(礼貌通知) | "立即去死"(强制) |
| 可否捕获 | 可以(注册 handler 做优雅退出:存盘、关连接) | 不可捕获、不可忽略、不可阻塞 |
| 默认动作 | Term | Term |
| 产生 core | 否 | 否 |
| 谁常用它 | kill <pid>、systemctl stop、docker stop | kill -9、OOM Killer、docker kill |
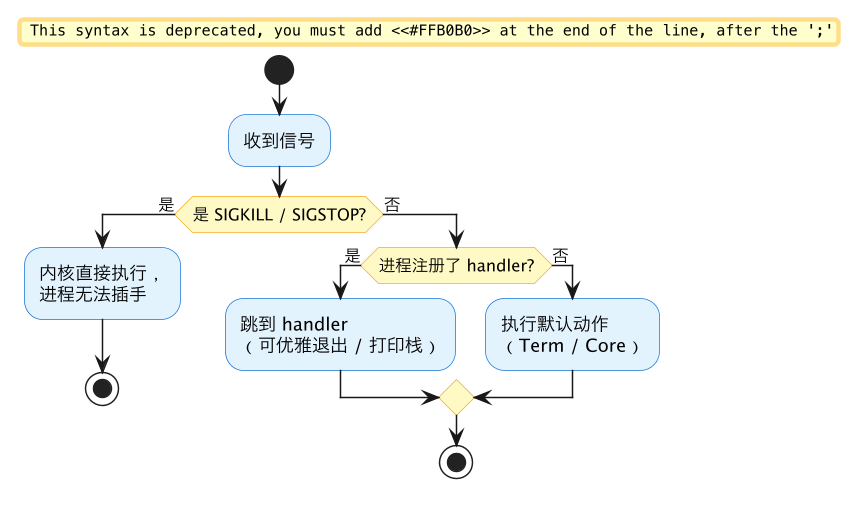
为什么 SIGKILL 不可捕获:它是内核给运维/自己保留的"最后手段"——如果进程能拦截它,那卡死/失控的进程就永远杀不掉了。代价是没有优雅退出、没有 core:进程连"写遗书"的机会都没有。所以被
kill -9或 OOM 干掉的进程,你在 GDB 里是找不到 core 的(见 core-dump.md FAQ 第 4 条)。
总表:crash 信号一览
| 信号 | 编号 | 默认动作 | 产生 core | 同步/异步 | 典型根因 |
|---|---|---|---|---|---|
SIGSEGV | 11 | Core | ✅ | 同步 | 空指针、野指针、越界、栈溢出、写只读段、UAF |
SIGABRT | 6 | Core | ✅ | (近)同步 | assert 失败、未捕获异常、double free、堆损坏 |
SIGFPE | 8 | Core | ✅ | 同步 | 整数除零、INT_MIN/-1 溢出 |
SIGBUS | 7 | Core | ✅ | 同步 | 未对齐访问、mmap 文件截断、物理地址无效 |
SIGILL | 4 | Core | ✅ | 同步 | 栈破坏后跳飞、坏函数指针、CPU 不支持的指令 |
SIGTRAP | 5 | Core | ✅ | 同步 | 断点 / 调试陷阱 / __builtin_trap |
SIGQUIT | 3 | Core | ✅ | 异步 | 键盘 Ctrl+\,主动带 core 终止 |
SIGTERM | 15 | Term | ❌ | 异步 | kill、systemctl stop(可捕获,优雅退出) |
SIGKILL | 9 | Term | ❌ | 异步 | kill -9、OOM Killer(不可捕获) |
SIGINT | 2 | Term | ❌ | 异步 | 键盘 Ctrl+C |
三、哪些信号会产生 core dump
分水岭就是默认动作是 Core 还是 Term:
- 产生 core(Core 类):
SIGSEGV、SIGABRT、SIGFPE、SIGILL、SIGBUS、SIGQUIT、SIGTRAP、SIGSYS—— 这些都留下崩溃现场,能用 GDB 复盘。 - 不产生 core(Term 类):
SIGKILL、SIGTERM、SIGINT、SIGHUP、SIGPIPE等 —— 进程直接终止,什么都不留。
转储的完整机制(内核何时决定转储、ulimit/dumpable/core_pattern 三道闸门、systemd/容器环境、GDB 分析全流程)见 core-dump,本篇不重复。这里只需记住:能不能拿到 core,第一步取决于是哪个信号——被
SIGKILL杀的再怎么配 ulimit 也没有 core。
四、怎么定位是哪个信号、为什么
4.1 退出码:128 + 信号编号
进程被信号杀死后,shell 的 $? 是 128 + signum:
./cpu_demo; echo $?
# 139  → 139-128 = 11 → SIGSEGV(段错误)
# 134  → 134-128 = 6  → SIGABRT
# 136  → 136-128 = 8  → SIGFPE
# 137  → 137-128 = 9  → SIGKILL(多半是 OOM,去查 dmesg)
4.2 dmesg / 内核日志:拿出错地址和 rip
同步信号(SEGV/BUS 等)内核会在日志里记一笔,含出错地址和出事指令地址 rip:
dmesg | tail
# cpu_demo[12345]: segfault at 0 ip 000055... sp 00007ff... error 6 in cpu_demo[...]
#                          ^^^^^^ 访问地址=0 → 空指针实锤
segfault at 0→ 访问地址是0x0,空指针;at后跟一个很大的随机值 → 野指针。error位标记读/写、是否权限问题。- 被 OOM 杀则是另一种记录:
dmesg | grep -i 'out of memory'。
4.3 GDB 加载 core:看信号 + 栈
gdb ./cpu_demo core.12345
# Program terminated with signal SIGSEGV, Segmentation fault.
# #0 0x... in foo (this=0x0) at main.cpp:42 ← 信号 + 出事行一目了然完整的符号匹配、bt full、thread apply all bt、反汇编定位栈破坏等流程,见 core-dump 第五节。
4.4 用"出错地址"反推 SIGSEGV 的子类型
同样是 SIGSEGV,是空指针、野指针还是栈溢出,靠地址落在哪个段来判——这正是 memory-layout 第四节地址速判表的用武之地:
| 出错地址 | 判断 |
|---|---|
0x0 / 0x8 / 0x10 等极小值 | 空指针(对象首地址为 0,字段偏移就是这些小值) |
| 栈范围之外、紧邻栈顶的低地址 | 栈溢出(撞 guard page) |
堆区地址、但 bt 见 _int_free | use-after-free / double free(此时多为 SIGABRT) |
落在 .text/.rodata(只读段)且是写操作 | 写只读内存 |
| 五花八门的随机地址 | 野指针 / 越界 |
五、可捕获 vs 不可捕获
5.1 能捕获的信号 → 写 crash handler
绝大多数致命信号都能用 signal() / sigaction() 注册处理函数——最典型的用途是崩溃时自己打印调用栈再退出(backtrace() + backtrace_symbols_fd()),给没配 core 的环境留个线索:
#include <execinfo.h>
#include <signal.h>
#include <unistd.h>
void crash_handler(int sig) {
    void *bt[64];
    int n = backtrace(bt, 64);           // async-signal-safe
    backtrace_symbols_fd(bt, n, STDERR_FILENO); // 打印栈到 stderr
    _exit(128 + sig);                    // 用 _exit,不是 exit
}
// main 里:signal(SIGSEGV, crash_handler); signal(SIGABRT, crash_handler);- 唯二不可捕获、不可忽略、不可阻塞的:
SIGKILL(9) 和SIGSTOP(19)。它们是内核留给系统的绝对控制手段,进程无权拦截。
5.2 handler 里只能调 async-signal-safe 函数(红线)
信号是异步打断——它可能在进程正持有 malloc 内部锁的瞬间插进来。若 handler 里又调 malloc/printf(它们也要拿同一把锁),就死锁或状态错乱。所以 handler 里只能用一份白名单函数(write、_exit、read、backtrace_symbols_fd 等,不含 malloc/printf)。
这条规则和 fork 后子进程"只能调 async-signal-safe 函数"是同一个道理——都是"在一个可能持锁的不确定时刻,只能碰不依赖全局锁的函数"。原理详解见 ../process/fork-and-threads 第三节。这也解释了为什么很多 crash handler 打出的栈是残缺的:它不敢用重型格式化,只能
write裸地址。
六、一句话总结
一句话概括:crash 信号分两路——同步信号(SEGV/BUS/FPE/ILL)是"进程自己作的",崩溃点就是出事那行指令,往自己代码里查内存越界/除零/坏指令;异步信号(KILL/TERM)是"外面来杀的",与当前代码无关,往 OOM/运维/父进程去查。128+signum 秒认信号,dmesg 拿出错地址,GDB+core 定位到行;能不能拿到 core 取决于默认动作是 Core 还是 Term,被 SIGKILL 杀的永远没有 core。