缓存一致性协议对比 —— MSI / MESI / MOESI / MESIF / Dragon
本目录讲了一族缓存一致性协议。这里横向对比,快速看清每个协议在前一个基础上加了什么、解决了什么、谁在用。
一、一句话谱系
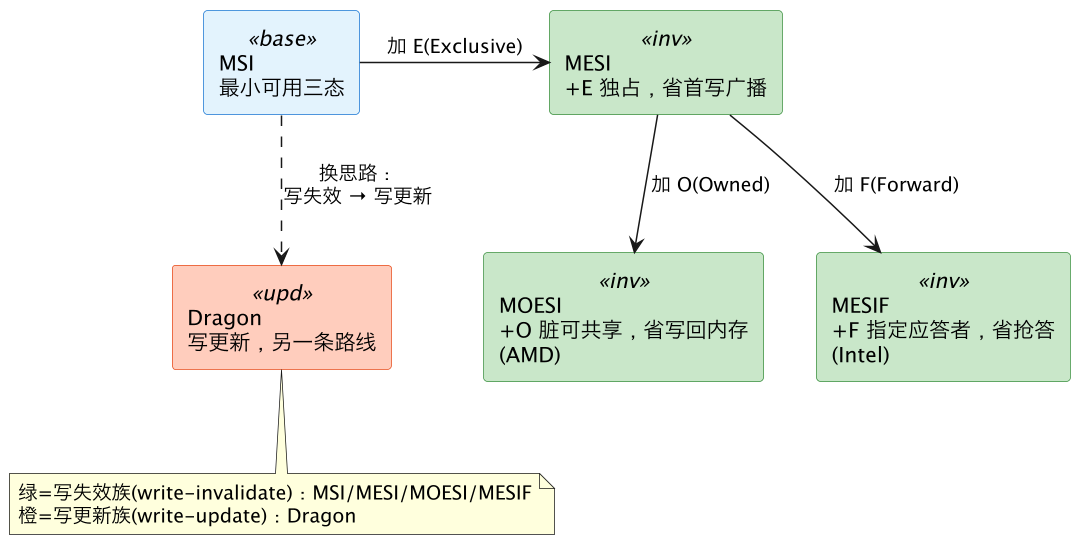
二、状态集合对比
| 协议 | 状态 | 相比 MESI 多/少了什么 |
|---|---|---|
| MSI | M S I | 少 E |
| MESI | M E S I | 基准 |
| MOESI | M O E S I | 多 Owned(脏且可共享) |
| MESIF | M E S I F | 多 Forward(共享行的指定应答者) |
| Dragon | E M Sc Sm(无 I) | 写更新路线,无 Invalid,Sm≈Owned |
三、各"第五态"解决什么(核心区别)
| 新增态 | 属于 | 状态数据是 | 解决的问题 | 省下的开销 |
|---|---|---|---|---|
| E Exclusive | MESI | 干净 | "独占干净行"首次写还要发广播 | 一次 BusUpgr 广播 |
| O Owned | MOESI | 脏 | 脏行被别人读必须先写回内存 | 一次写内存(改 cache-to-cache 转发) |
| F Forward | MESIF | 干净 | 多个 S 副本谁来应答新读者 | 冗余应答 / 读内存 |
记忆:E 省"首写广播",O 省"写回内存",F 省"应答抢答"。 三者互不冲突(理论上可组合成 MOESIF),商用上 Intel 选 MESIF、AMD 选 MOESI。
四、写失效 vs 写更新
| 写失效(MSI/MESI/MOESI/MESIF) | 写更新(Dragon/Firefly) | |
|---|---|---|
| 写共享行时 | 让别人副本失效 | 把新值广播更新给别人 |
| 写者反复写 | 第一次失效后即独占,后续无广播 | 每次写都广播(读者不看则纯浪费) |
| 读者 | 可能 miss 重取 | 总是命中 |
| 适合 | 写多读少、写后无人再读 | 写后他人立即读、更新数据小 |
| 现实采用 | ✅ 主流 | ❌ 基本仅教学 |
五、谁在用(商用现状)
| 平台 | 协议族 | 互联 |
|---|---|---|
| Intel 多核 / 多路 | MESIF | QPI → UPI |
| AMD(Opteron ~ Zen) | MOESI | HyperTransport → Infinity Fabric |
| 教科书 / 历史 | MSI、Dragon、Firefly | 概念总线 |
实际芯片的一致性实现远比教科书状态机复杂(多级缓存、目录式而非纯总线嗅探等),但对外表现出的语义仍是这几种协议的组合与增强。
六、对开发者:不管哪种,规避手段一样
这些协议差异全在硬件内部(谁供数、要不要写回、谁应答),应用层几乎感知不到:
- 伪共享都靠 cache line 对齐/填充规避(见 mesi-false-sharing)。
- 定位用
perf c2c+perf stat看 cache-misses/IPC(见 mesi-false-sharing)。 - 优先级:先解决 NUMA 跨节点,再解决节点内伪共享。
换句话说:了解 MOESI/MESIF/Dragon 的价值在于读懂硬件为何这样设计、
perf c2c里的 HITM 意味着什么;写代码时认准"变量别挤同一 cache line"就够了。
七、一致性的硬件落地:缓存层级、目录与互联
前面的状态机和时序都把"一个核"当黑盒。这里拆开黑盒,回答三个"真机上很关键、教科书状态机一笔带过"的问题:协议消息落在哪一级缓存?广播嗅探怎么扩展到多核?广播→点对点到底换了什么? 这三问对全族通用,是把逻辑协议对上真实芯片的桥。
7.1 协议消息发生在哪一级缓存之间?(L1↔L1?L2↔L2?)
时序图里画的都是"核A ↔ 总线 ↔ 核B",把每个核的私有缓存当成黑盒。但一个核里有 L1 和 L2 两级私有缓存,"嗅探""转发""失效"这些动作究竟落在 L1 还是 L2 上? 分三层说清:
(1)一致性协议只作用在"私有缓存↔私有缓存"之间,核内 L1↔L2 不归它管。
- 拓扑上 L1/L2 每核私有、L3/内存共享(见 msi 第一节)。MSI/MESI 管的是"不同核的私有缓存副本之间"的一致性——即核A 和核B 的缓存怎么协调。
- 同一个核内部,L1/L2 之间不用"一致性协议",而是更简单的包含策略 + 回填/回写(inclusion / back-invalidation):L2 通常 inclusive of L1(L1 有的行 L2 必有副本),L2 驱逐一行会反向失效(back-invalidate) L1 里对应行。这是核内部自维护,不走总线、不发嗅探。
(2)真正挂在互联上"嗅探/应答"的,是每个核最后一级私有缓存——现代 x86 上就是 L2(或它背后的 LLC 目录),不是 L1 直接对 L1。
一个核的缓存对外只暴露一个"一致性代理(coherence agent)",物理上就是私有缓存的最外层 + 它到互联的接口:
| 层级 | 是否参与跨核一致性 | 角色 |
|---|---|---|
| L1 | 否(不直接上互联) | 只和本核 L2 打交道;它的状态由本核 L2 代管、随嗅探结果被动更新 |
| L2(最后一级私有) | 是 | 本核对外的"一致性代理",在互联上嗅探/应答的就是它;需要 L1 里的脏数据时,它先向本核 L1 索要 |
| L3 / LLC | 是(作枢纽) | 共享,常兼任目录(directory)/home agent,记录"哪个核持有哪条行",是嗅探的路由中心 |
所以"cache-to-cache 转发"更准确的说法是:核A 的 L2(一致性代理)→ 互联/LLC → 核B 的 L2,不是一根线把两个 L1 直连。数据到核B 的 L2 后按逐级回填规则灌进核B 的 L1。
(3)一次跨核取脏数据的完整链路(拆开"核"黑盒看):
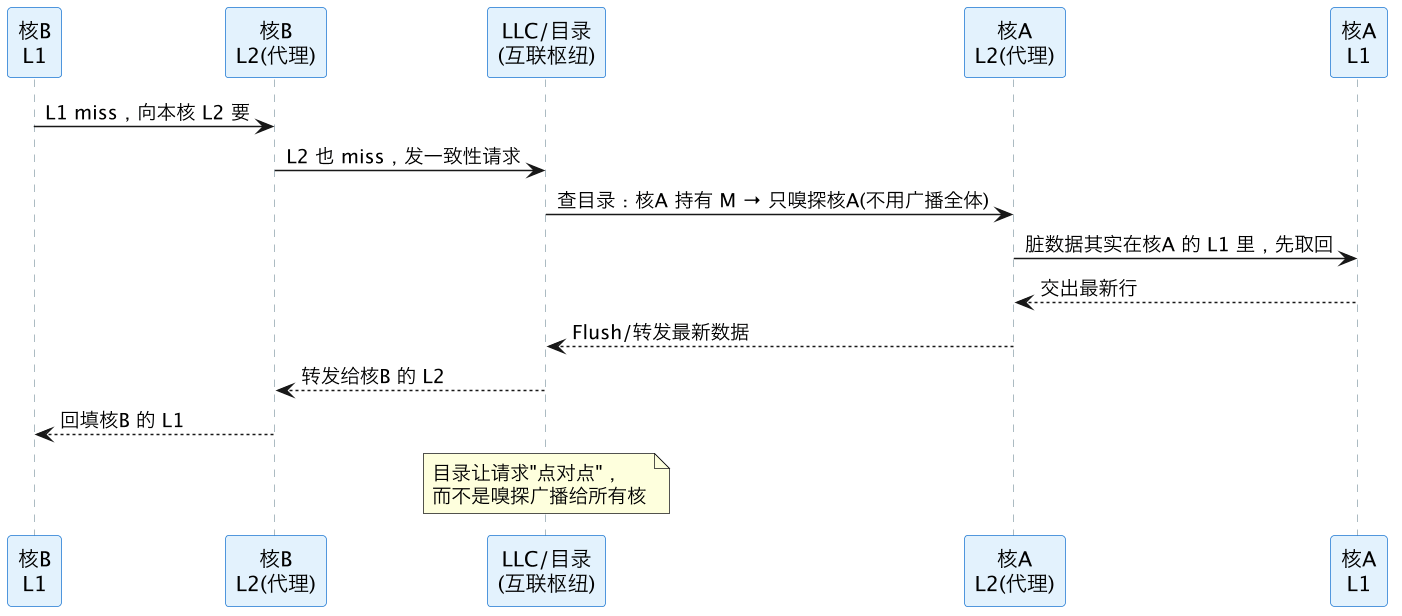
一句话记住:协议作用在"各核私有缓存之间",落地应答者是每核最后一级私有缓存(L2),LLC/目录当路由枢纽;L1 只是被自己核的 L2 代管,L1↔L1 直连是没有的。(不同微架构分级不同——有的 L2 也共享、只 L1 私有,那对外代理就是 L1;原则不变:对外一致性代理 = 私有缓存最外层。)
7.2 cache-to-cache 供数一多,互联流量就大、总线压力就重,怎么办?
cache-to-cache 快是快,但**"总线嗅探"本质是广播**——请求发给所有核、都可能应答。核数一多(几十核),广播风暴把互联带宽吃满,嗅探反成瓶颈。工业界四个方向叠加:
| 手段 | 解决什么 | 怎么做 |
|---|---|---|
| ① 目录(directory) 取代广播嗅探 | 广播流量 O(N) → 点对点 | LLC/home 维护"哪条行被哪些核持有"的目录,请求只定向发给真正持有的核,不再全体广播。大核数下主力手段 |
| ② 嗅探过滤器(snoop filter) | 无谓嗅探 | LLC/互联入口放"过滤表",记录"某行根本没任何核缓存"→ 直接跳过嗅探、回内存,不打扰任何核 |
| ③ 指定唯一转发者(F/O 状态) | 多个 S 副本抢答 | 多核都持 S 时若都应答就是重复流量。MESIF 的 F、MOESI 的 O(见 mesi-variants)指定唯一核转发,其余沉默——把 N 份应答压成 1 份 |
| ④ 分层/可扩展互联 + 局部性 | 全局流量 | 总线→ring→mesh(Intel)、CCX/CCD + Infinity Fabric(AMD);配合 sub-NUMA clustering 把数据和访问它的核关在同一簇,让 cache-to-cache 尽量走近端短链路,不横穿整片 die 或跨插槽(跨插槽就成了 NUMA 远程访问) |
把它们串起来看演进逻辑:
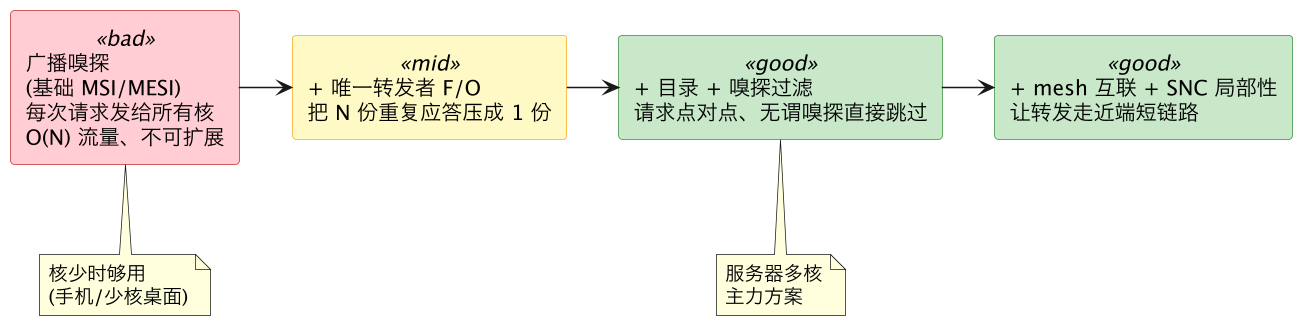
要点提炼:
- 根因:cache-to-cache 本身不贵,贵的是"为了找到该由谁转发而做的广播嗅探"。优化几乎都在减少广播、减少重复应答、缩短转发距离上做文章,而不是禁止 cache-to-cache。
- 目录是分水岭:小核数(手机、少核桌面)广播嗅探够用;一旦上到服务器几十上百核,必须转目录式,否则嗅探流量自己就把互联压垮(Intel home snoop/directory、AMD probe filter 都是这一路)。
- F/O 是"应答去重":解决的正是"多个 S 谁转发"——不指定就人人应答,指定后只一份,直接砍掉冗余流量,回扣第三节 MESIF/MOESI 存在的理由。
- 局部性是最后一道:再好的协议也怕"数据在 die 另一头、甚至另一个插槽"。把线程和它的数据绑到同一簇(SNC/NUMA-aware 调度),让 cache-to-cache 尽量近——已经和 NUMA 调优 接壤了。
一句话:广播嗅探不可扩展 → 目录做点对点 + 嗅探过滤砍无谓流量 + F/O 砍重复应答 + mesh 与局部性缩短转发距离。cache-to-cache 不是被削掉,而是被"精确制导"了。
7.3 广播 → 点对点:换总线结构 + 换协议,两者都换
这问到了本质:"广播嗅探"和"目录点对点"不是同一套东西的参数调优,而是两个不同的一致性范式,落地时互联物理结构和协议工作方式都得换:
(1)物理层:共享总线 → 点对点互联。 广播能成立,前提是有一根"所有核都听得见"的共享总线——一次发送物理上天然被所有核收到(广播介质)。但共享总线单一仲裁、频率受负载拖累、加核就变慢,本身就撑不到几十核。所以现代 CPU 早把它换成点对点片上网络:
| 共享总线(bus) | 点对点互联(ring / mesh / fabric) | |
|---|---|---|
| 拓扑 | 一根总线挂所有核 | 节点两两有链路,消息逐跳转发 |
| 天然广播? | 是(发一次全体收到) | 否(广播要发 N 份,很贵) |
| 仲裁 | 全局单一,冲突随核数暴涨 | 分布式,无全局瓶颈 |
| 扩展性 | 差(十几核到顶) | 好(几十上百核) |
| 代表 | 早期 SMP FSB | Intel ring/mesh、AMD Infinity Fabric |
关键因果:互联从共享总线变成点对点网络后,广播从"免费"变成"要付 N 份发送成本",反过来逼着协议放弃广播——不是先想优化协议,而是物理结构先变了,广播式协议在新结构上跑不动。
(2)协议层:嗅探式(snooping) → 目录式(directory)。 这是两类根本不同的一致性协议:
| 嗅探式 snooping | 目录式 directory | |
|---|---|---|
| 持有者信息在哪 | 没人记,靠广播现问现答 | 集中记在目录里(LLC/home agent 维护表:行 → 持有者位图) |
| 找持有者 | 广播给所有核自查自答 | 查目录 → 只定向发给记录中的持有者 |
| 流量 | O(N),随核数线性膨胀 | 接近 O(持有者数),通常 1~2 个 |
| 额外成本 | 无目录存储,但吃互联带宽 | 花 SRAM 存目录、多一次查表延迟 |
| 适用 | 少核 + 共享总线 | 多核 + 点对点互联 |
所以"点对点"有两重含义、缺一不可:物理上互联本就是点对点转发(没有广播介质了),逻辑上目录让一致性请求也变成点对点定向(不再问所有人)。二者配套——目录式协议正是为点对点互联量身定的,一起把"广播"这个既贵又不可扩展的动作从系统里拿掉。
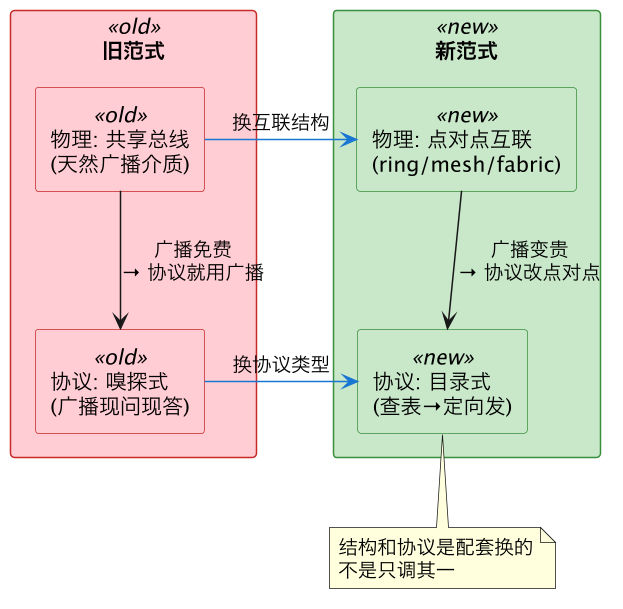
一句话:广播→点对点是"换总线结构(共享总线→点对点网络) + 换协议范式(嗅探式→目录式)"两件事一起发生:物理结构变了让广播不再免费,协议范式变了才不用广播,单换一个都不成立。 7.2 表格里的目录、F/O、mesh 都是这套新范式下的零件。
八、各文档入口
- msi —— 最基础三态,家族起点
- mesi —— 主协议:状态机、写事务时序、伪共享(本族核心)
- mesi-variants —— MOESI(+O,AMD)、MESIF(+F,Intel) 与写更新路线 Dragon
总结
缓存一致性从「广播嗅探」走向「点对点目录」是两件事配套发生:物理互联从共享总线换成 ring/mesh/fabric,协议从嗅探式换成目录式。共享总线时代广播天然免费,协议就靠总线广播现问现答;核数增多后点对点互联让广播既贵又 O(N) 不可扩展,目录式协议查表定向通知、只问相关核,把「广播」这个动作从系统里拿掉。物理结构变(广播不再免费)和协议范式变(不再需要广播)缺一不可——目录、F/O 状态、mesh 都是这套新范式下的零件。