无锁编程深入:模式、陷阱与工程实践
前置:建议先读 low-latency-patterns 的第三节(无锁编程与 RCU 原理)
一、无锁编程的概念边界
1. 分级定义
- Wait-Free:每个操作在有限步骤内完成(最强)
- Lock-Free:系统中至少有一个操作在有限步骤内完成(整体进展)
- Obstruction-Free:单线程不阻塞即可完成(最弱)
2. 无锁 ≠ 不用锁
- 原子指令(CAS、FAA、LL/SC)本身是硬件层面的"微缩锁"
- 真正的开销:缓存一致性协议(MESI 状态迁移)和内存屏障
- "无锁"解决的是调度上的阻塞,不是竞争上的开销
3. 何时需要无锁
- 临界区极短(< 100 cycles)→ 无锁更好
- 读多写少 → RCU 更好(见 rcu-internals)
- 中断上下文/信号处理中 → 必须无锁
- 实时系统要求确定性 → 必须 wait-free
二、核心原语
1. CAS 模式
cpp
// compare_exchange_weak vs strong
// weak 允许 spurious failure,适合循环
// strong 保证成功才返回,可能有额外开销- CAS 循环的退避策略(指数退避 / 随机退避)
- x86
LOCK CMPXCHGvs ARMLDXR/STXR的硬件实现差异 - CAS 的 ABA 问题(见下方)
2. FAA(Fetch-And-Add)模式
- 比 CAS 更低竞争的开销
- 适合计数器、索引分配等场景
- 配合位域打包多个变量到一个原子变量
3. 内存序选择速查表
| 操作 | 推荐 order | 原因 |
|---|---|---|
| 纯计数器 | relaxed | 不需要同步其他数据 |
| 发布数据 | release | 确保之前写入对其他线程可见 |
| 消费数据 | acquire | 确保看到发布者之前的所有写入 |
| 互斥 flag | acq_rel | 需要双向同步 |
| x86 SeqLock | seq_cst | 需要全局顺序 |
三、经典无锁数据结构剖析
1. Michael-Scott 无锁队列 (FIFO)
- 哨兵节点的作用
- enqueue 的两步 CAS(tail->next 然后更新 tail)
- dequeue 对空/单元素队列的特殊处理
- 内存回收:与队列的耦合
2. Treiber Stack (LIFO)
- 单 CAS 的 push/pop——最简单的无锁结构
- 内存泄漏问题:弹出节点何时可以 free
- HPEB / RCU 配合解决问题
3. Harris 无锁链表
- 逻辑删除标记位(偷 data 的低位 bit)
- 物理删除由后续遍历者完成(helping)
- 查找时的并发修复
4. Concurrent Hash Map 思路
- 分桶 + 每桶细粒度锁 / 无锁
- Folly
ConcurrentHashMap的microshard模式 - 无锁跳表作为替代方案
四、内存回收:无锁编程的最大挑战
1. 为什么不能直接 delete
- 线程 A CAS 拿到指针 → 被抢占 → 线程 B 删除对象 → 线程 A 醒来访问悬空指针
2. 四种回收方案
| 方案 | 原理 | 延迟 | 内存 | 复杂度 |
|---|---|---|---|---|
| Quiescent-State-Based (QSBR) | 所有线程经过静默期后回收 | 最低 | 可能堆积 | 需侵入线程 |
| Epoch-Based (EBR) | 三代 epoch 轮转回收 | 低 | epochs × 对象量 | 中 |
| Hazard Pointers (HP) | 线程声明保护哪些指针 | 中 | 低 | 低 |
| RCU | 内核级宽限期机制 | 低(读)/ 高(收) | 低 | 内核依赖 |
详细 RCU 分析见 rcu-internals
3. 各方案代码量对比
- HP: ~200 行
- EBR: ~300 行
- QSBR: ~100 行(但需要静态标记静默点)
- RCU: 1 行
rcu_read_lock()+ 1 行synchronize_rcu()
五、ABA 问题与解决方案
1. 经典场景
bash
T1: 读到 head=A;       (被抢占)
T2: pop A, pop B, push A;
T1: CAS 期望 head=A, 实际 head=A → 成功——但链表已变!
2. 解决手段
- Tagged Pointer:指针高位存储版本号,
cmpxchg16b(128位 CAS) - Hazard Pointers:A 在被"保护"期间不能被复用
- RCU:A 在整个宽限期内不释放
六、性能量化
1. 无锁 vs 有锁 单操作开销
| 操作 | std::mutex | std::atomic CAS | FAA |
|---|---|---|---|
| 无竞争 | ~25ns | ~10ns (x86) | ~5ns |
| 中度竞争 (4C) | ~150ns | ~60ns | ~30ns |
| 重度竞争 (8C) | ~500ns+ | ~200ns | ~120ns |
2. 队列吞吐量 (8 线程)
| 队列类型 | 吞吐量 (M ops/s) | P99 延迟 (ns) |
|---|---|---|
std::queue + std::mutex | 2.5 | 1200 |
boost::lockfree::queue | 18 | 800 |
| Michael-Scott + HP | 22 | 600 |
| MPMC bounded array | 35 | 400 |
七、工程建议
- 先用锁,profile 证明是瓶颈再考虑无锁
- 优先考虑成熟的库(
boost::lockfree、Intel TBB、Folly) - 考虑无锁队列替代锁竞争,而非替换所有锁
- 内存回收必须从设计阶段就考虑,不是事后补
- 测试远比写代码难:弱内存序的 ARM/POWER 上行为可能迥异
八、参考
- atomic —— 原子操作基础
- reordering-overview —— 内存序全景
- memory-model —— C/C++ 内存模型
- rcu-internals —— RCU 内核实现
总结
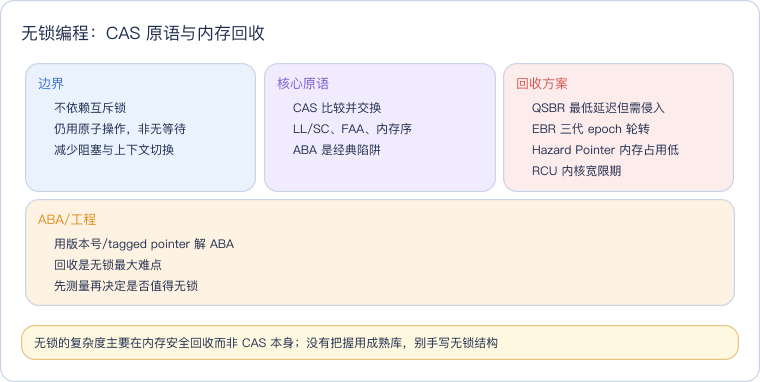
无锁靠 CAS 等原子操作消除互斥,但真正的难点是内存安全回收(QSBR/EBR/Hazard Pointer/RCU)与 ABA;性能不确定优于锁时别上,优先用成熟库。