信号的高性能替代方案 —— 为什么 fd 模型比信号快
前置阅读:signals-kernel(信号的内核路径、数据结构、性能瓶颈)。本文聚焦为什么这些替代方案比信号快——每个方案的性能来源都追溯到内核代码路径的差异。
零、一句话认知
信号 = 异步中断模型(内核主动打断用户代码)→ fd = 同步事件模型(用户代码主动轮询)。
把信号变成文件描述符的那一刻,它就从"内核有话说,必须立刻打断你"变成了"内核有话说,记下来,你什么时候方便什么时候看"。性能差距的根源就在这里——信号路径需要在内核和用户态之间强行插入一个 handler;fd 路径只是把事件挂在 epoll 队列里,等你自然轮询到。
一、信号模型的性能瓶颈回顾
先量化信号到底贵在哪。一个信号从发送到 handler 执行完毕,完整路径是:
发送者                     内核                            接收者
───────                   ────                            ──────
kill(pid, SIGUSR1)
  → syscall 陷入
    → siglock 加锁
    → __send_signal()
      → sigqueue 分配 (RT信号)          ← ① 内存分配
    → complete_signal()
      → 遍历 thread_head 找目标         ← ② O(n) 遍历 (持锁)
      → signal_wake_up()                ← ③ 唤醒/标记
    → siglock 解锁
  → 返回
                  接收者刚从内核返回用户态
                    → exit_to_user_mode_loop
                    → do_signal() → get_signal()
                      → dequeue_signal()            ← ④ 出队
                    → handle_signal()
                      → save_fpu()                  ← ⑤ FPU 保存 (~1KB+)
                      → setup_rt_frame()
                        → put_user() 写用户栈       ← ⑥ 用户态内存写
                      → siglock 修改 blocked
                    → iretq
                      → 跳到 handler
handler 执行                ← ⑦ 用户态 handler 代码
handler ret → sys_rt_sigreturn  ← ⑧ 又进内核
  → restore_sigcontext()
    → restore_fpu()                 ← ⑨ FPU 恢复 (~1KB+)
    → restore_altstack()
→ iretq → 回到原始代码每次信号的固定开销(量化):
| 开销项 | 操作 | 典型延迟 |
|---|---|---|
| siglock 加/解锁 × 2 | 自旋锁获取+释放(发送端 + 投递端) | ~50-200 cycles (无争用),争用时更高 |
| sigqueue 分配 (RT) | kmem_cache_alloc | ~200-500 cycles |
| thread_head 遍历 | O(n_threads) 链表遍历(持锁) | 每个线程 ~50-100 cycles |
| FPU 保存 | xsave / fxsave → 用户栈 | ~200-1000 cycles (取决于 XSAVE 区域大小) |
| sigframe 写用户栈 | 连续 put_user 调用 | ~500-1500 cycles |
| sigreturn 内核重入 | syscall + siglock + restore | ~500-1000 cycles |
| FPU 恢复 | xrstor / fxrstor | ~200-1000 cycles |
总计:一个 RT 信号 ~2000-5000+ cycles(约 0.5-2μs @ 3GHz),不含 handler 自身。高频场景(10 万次/秒)下,~0.5-2 亿 cycles/秒 被信号开销吃掉——约 5-20% 的单核 CPU。
下面逐个看替代方案是怎么把这些开销一项项砍掉的。
二、signalfd —— 信号变 fd,从"被中断"到"自己读"
核心思路
传统信号模型:                         signalfd 模型:
═══════════════                      ═══════════════
内核 → handler(异步打断)            内核 → pending set → fd 可读(同步通知)
      ↓                                       ↓
用户代码被中断、被迫处理              epoll_wait 返回 → read(sfd)
为什么快:每条信号路径开销的逐项对比
                   信号 handler 路径              signalfd 路径
                   ════════════════              ═════════════
发送端:
  siglock          有 (send_signal + complete)   有 (send_signal + complete)
  sigqueue 分配    有 (RT)                       有 (RT) ← 相同
  thread 遍历      有 (complete_signal)           有 (complete_signal)
接收端(关键差异在这里):
  do_signal        ★ 有                          无 —— 不进入信号处理路径
  FPU 保存         ★ 有 (save_fpu)               无 —— 不需要保存现场
  sigframe 写栈    ★ 有 (setup_rt_frame)         无 —— 不需要伪造栈帧
  iretq 到 handler ★ 有                          无 —— 不需要跳转
  handler 执行     ★ 有 (Ring 3)                 无 —— read(sfd) 在普通上下文
  sigreturn        ★ 有 (再进内核)               无 —— 不需要恢复现场
  FPU 恢复         ★ 有 (restore_fpu)            无 —— FPU 从未被破坏
signalfd 砍掉了接收端的全部信号投递开销——不是"优化",是把整个 do_signal → handle_signal → setup_rt_frame → handler → sigreturn 这条链完全跳过。
内核做了什么(和不做什么)
信号发送到 signalfd 监听的信号时:
内核发送路径 (和普通信号完全相同):
  __send_signal() → pending set 置位 → complete_signal()
差别在 signal_wake_up() 中:
  ┌──────────────────────────────────────────────────────┐
  │ 普通信号: signal_wake_up()                           │
  │   → set_tsk_thread_flag(t, TIF_SIGPENDING)          │
  │   → wake_up_state(t, TASK_INTERRUPTIBLE)             │
  │   → ★ 目标线程下次返回用户态时走 do_signal()         │
  │                                                      │
  │ signalfd: signal_wake_up()                           │
  │   → wake_up(&ctx->signalfd_wqh)                     │
  │   → ★ 唤醒等待在 signalfd 上的 epoll/poll/read     │
  │   → 仅此而已。不设 TIF_SIGPENDING, 不走 do_signal   │
  └──────────────────────────────────────────────────────┘
signalfd 的 read() 路径:
// fs/signalfd.c: signalfd_read()
static ssize_t signalfd_read(struct file *file, char __user *buf,
size_t count, loff_t *ppos)
{
struct signalfd_ctx *ctx = file->private_data;
// ① 从 pending set 中 dequeue 信号
// (走 dequeue_signal() —— 和正常信号投递用同一个函数)
// 但不调用 handle_signal,不触发 handler 路径
ret = signalfd_dequeue(ctx, count, &info);
// ② 把信号信息拷贝为 signalfd_siginfo 结构 → 用户态 buf
// 这是一次普通的 copy_to_user(),不是构造 sigframe
if (copy_to_user(buf, &info, sizeof(info)))
return -EFAULT;
// ③ 如果读完还有 pending 信号 → 保持 fd 可读
// 如果没有了 → fd 不再可读(直到新信号到来)
spin_lock_irq(¤t->sighand->siglock);
if (!signalfd_notify(current, ctx))
// 没有信号了,清 POLLIN
;
spin_unlock_irq(¤t->sighand->siglock);
return sizeof(info); // ← 普通 syscall return, 不伪造任何东西
}signalfd_read 只做三件事:dequeue → copy_to_user → return。没有 FPU、没有 sigframe、没有 sigreturn。这就是性能差异的全部秘密。
signalfd 与 epoll 的集成
// 经典模式:信号和其他 IO 事件统一处理
int sfd = signalfd(-1, &mask, SFD_NONBLOCK);
struct epoll_event ev = { .events = EPOLLIN, .data.fd = sfd };
epoll_ctl(epfd, EPOLL_CTL_ADD, sfd, &ev);
// 主循环
while (1) {
    int n = epoll_wait(epfd, events, MAX_EVENTS, -1);
    for (int i = 0; i < n; i++) {
        if (events[i].data.fd == sfd) {           // signalfd 就绪
            struct signalfd_siginfo fdsi;
            read(sfd, &fdsi, sizeof(fdsi));        // 同步读取信号详情
            handle_signal_sync(fdsi.ssi_signo);    // ★ 在普通上下文中处理!
        } else {
            handle_io(events[i].data.fd);          // 普通 IO 事件
        }
    }
}关键优势:
handle_signal_sync()运行在主循环的普通上下文中,不受 async-signal-safe 限制——可以malloc、printf、拿锁,和普通代码完全一样。而传统 handler 中调用printf就可能死锁。
为什么发送端开销一样
signalfd 不减少信号发送端的开销——信号仍然要走 send_signal → complete_signal 这条路径。signalfd 只优化了接收端。如果信号频率极高以至于发送端(siglock 争用、sigqueue 分配)成为瓶颈,需要用 eventfd。
三、eventfd —— 比 RT 信号快一个数量级的事件通知
核心思路
eventfd 完全不走信号子系统。它是一个独立的轻量级"计数器 + 等待队列"抽象:
信号模型:                                 eventfd 模型:
══════════                               ══════════════
kill() → 信号子系统                       write() → 原子加计数器
  → siglock                              → wake_up poll 队列
  → sigqueue 分配
  → pending set 位操作
  → complete_signal (遍历线程)
  → signal_wake_up
为什么快
发送路径(write(efd))只做这些:
// fs/eventfd.c: eventfd_write()
static ssize_t eventfd_write(struct file *file, const char __user *buf,
                              size_t count, loff_t *ppos)
{
    struct eventfd_ctx *ctx = file->private_data;
    __u64 ucnt;
    if (copy_from_user(&ucnt, buf, sizeof(ucnt)))
        return -EFAULT;
    spin_lock_irq(&ctx->wqh.lock);    // ← 仅仅是这个 eventfd 的等待队列锁
                                      //    不是全局 siglock!
    // 检查是否会溢出 (U64_MAX - ctx->count)
    if (ucnt > U64_MAX - ctx->count) {
        spin_unlock_irq(&ctx->wqh.lock);
        return -EAGAIN;
    }
    ctx->count += ucnt;               // ← 一次 64-bit 原子加法
    // 唤醒等待者
    if (waitqueue_active(&ctx->wqh))
        wake_up_locked_poll(&ctx->wqh, EPOLLIN);
    spin_unlock_irq(&ctx->wqh.lock);
    return sizeof(ucnt);
}没有:
- 没有 siglock(用的是
ctx->wqh.lock,只锁这一个 eventfd) - 没有 sigqueue 内存分配
- 没有 pending set 位操作
- 没有 complete_signal 线程遍历
- 没有 signal_wake_up
- 没有 TIF_SIGPENDING
- 没有 FPU 保存/恢复
- 没有 handler 跳转
- 没有 sigreturn
| RT 信号 (kill/sigqueue) | eventfd (write) | |
|---|---|---|
| 锁 | 全局 sighand->siglock(所有信号争用同一把锁) | 私有 ctx->wqh.lock(每个 eventfd 独立) |
| 内存分配 | kmem_cache_alloc(sigqueue_cachep) 每次 | 无(只做一次原子加) |
| 数据结构操作 | pending set 位操作 + 链表插入 | 无(只修改 64-bit 计数器) |
| 目标查找 | complete_signal 遍历线程组 O(n) | 无(按 fd 直接找到 eventfd_ctx) |
| 接收端 | FPU save/restore + sigframe + sigreturn | read() → 普通 syscall,读计数器 |
量化对比:eventfd write 路径 ≈ 100-300 cycles;RT 信号 kill 路径 ≈ 500-1500+ cycles。eventfd 快 5-15 倍。
eventfd 的两个特别模式
EFD_SEMAPHORE:每次 read() 只减 1,读出值固定为 1。适合"计数型信号量"场景(每次只消费一个事件)。
// 发送:每收到一个网络包
write(efd, &(uint64_t){1}, 8);  // cnt += 1
// 接收:每处理一个包
read(efd, &val, 8);             // val = 1, cnt -= 1
// EFD_SEMAPHORE 保证每次只返回 1EFD_NONBLOCK:读端用 epoll 统一调度,read() 不阻塞。标准高性能用法。
eventfd 不能替代的:信号特有的语义
eventfd 放弃了信号模型的几个独特能力:
- 不携带发送者身份(信号有
si_pid/si_uid) - 不能定向到特定线程(eventfd 谁读到归谁)
- 不能打断慢系统调用(没有 EINTR 语义)
- 不能直接杀掉进程(SIGKILL/SIGTERM 还得用真信号)
所以实际场景通常搭配使用:SIGTERM/SIGINT 用于进程生命周期管理(signalfd 或真 handler),eventfd 用于高频事件通知。
四、timerfd —— 替代 setitimer/SIGALRM,高精度 + 零信号开销
传统 setitimer 的问题
// 传统方式:每 10ms 收到一个 SIGALRM
setitimer(ITIMER_REAL, &(struct itimerval){ .it_interval = {0, 10000} }, NULL);
// → 每 10ms:
//   内核 hrtimer 触发 → 发送信号 SIGALRM → 完整的信号路径
//   → save_fpu → sigframe → handler 执行 → sigreturn → restore_fpu
//   如果 handler 没及时返回(比如里面调了非 async-safe 函数卡住),
//   下一个 SIGALRM 被合并(标准信号不排队)→ 丢定时事件
每 10ms 一次信号的开销(100 次/秒):
100 次/秒 × (~1-3μs/次) = 100-300μs/秒 ≈ 0.01-0.03% CPU单个 SIGALRM 看起来不贵,但在高频定时(1ms 间隔 = 1000 次/秒)下就显著了。
timerfd 为什么快
// timerfd 方式
int tfd = timerfd_create(CLOCK_MONOTONIC, TFD_NONBLOCK);
itimerspec its = {
    .it_interval = {0, 10000000},  // 10ms 间隔
    .it_value    = {0, 10000000},  // 首次 10ms 后
};
timerfd_settime(tfd, 0, &its, NULL);
// 加入 epoll
struct epoll_event ev = { .events = EPOLLIN, .data.fd = tfd };
epoll_ctl(epfd, EPOLL_CTL_ADD, tfd, &ev);
// epoll_wait 返回时
uint64_t expirations;
read(tfd, &expirations, 8);  // 读出到期次数(可能 > 1)
内核路径对比:
传统 setitimer/SIGALRM:                  timerfd:
═══════════════════════                  ═══════
hrtimer 触发                             hrtimer 触发
  → posix_timer_fn()                       → timerfd_tmrproc()
    → send_signal(SIGALRM)  ← 完整信号路径    → ctx->ticks++
      → siglock                              → wake_up(&ctx->wqh)  ← 仅唤醒 poll
      → sigqueue 分配                        → 结束。30-50 cycles
      → complete_signal
      → ... (后续信号投递路径)
timerfd 的定时器回调只做两件事:ctx->ticks++ + wake_up。不走任何信号代码。这是 <50 cycles 的操作,而 send_signal 单次就有几百 cycles。
timerfd 的额外优势
- 支持多个独立定时器:一个 fd 一个定时器,互不干扰。传统
setitimer每进程最多 3 个(REAL/VIRTUAL/PROF),且都复用 SIGALRM。 - 不丢事件:即使
read()不及时,read()返回的是到期次数,一次不漏。标准 SIGALRM 不排队——上一个没处理完,下一个丢失。 - 高精度:直接使用 hrtimer 框架(纳秒精度)。
setitimer也用了 hrtimer,但信号路径的延迟(等待用户态返回才投递)使实际精度受限于调度延迟。
五、共享内存 + eventfd —— 替代 RT 信号传数据
RT 信号传数据的局限
// RT 信号的"数据传递":si_value 只有 32-bit(一个 int 或指针)
union sigval value;
value.sival_int = 42;
sigqueue(pid, SIGRTMIN, value);
// 接收端
void handler(int sig, siginfo_t *info, void *ctx) {
    int data = info->si_value.sival_int;  // 只有 4 字节
}局限:
- 数据量上限:
si_value是一个union { int; void *; },最多 8 字节 - 每个数据都是一个 sigqueue 分配
- 高频场景下 RLIMIT_SIGPENDING 成为硬瓶颈
为什么共享内存 + eventfd 快
RT 信号路径:                         共享内存 + eventfd:
═══════════                          ═══════════════════
发送:                               发送:
  sigqueue(si_value)                   memcpy(shm_ptr, data, len);  ← 数据放共享内存
    → sigqueue 分配 (每次)                → wmb();  ← 内存屏障
    → pending 位操作                      → write(efd); ← 仅通知
    → complete_signal                                         ↑ 轻量操作
    → signal_wake_up
接收:                               接收:
  handler(..., siginfo)                epoll_wait → efd 可读
    → 从 si_value 读数据                 → read(efd)
    → handler 受限环境(async-safe)      → rmb();
→ sigreturn → 从 shm_ptr 读数据 ← 普通上下文数据传递的差异:
| RT 信号 | 共享内存 + eventfd | |
|---|---|---|
| 数据大小 | 最大 8 字节(si_value) | 无上限(共享内存页的容量) |
| 每次内存分配 | 有(sigqueue) | 0(共享内存在初始化时分配一次) |
| 通知开销 | ~500-1500 cycles(完整信号路径) | ~100-300 cycles(eventfd write) |
| 接收上下文 | async-signal-safe 受限 | 普通上下文,无限制 |
| 吞吐瓶颈 | RLIMIT_SIGPENDING 限制 | eventfd 计数器(64-bit,几乎无限制) |
共享内存的零拷贝特性:数据本身放在共享页中,发送方写完、接收方读——不经过内核拷贝。信号路径需要 copy_to_user 把 sigqueue 中的数据拷到 sigframe 中。共享内存路径不仅更快,数据量也无限制。
完整代码模式
// 共享内存布局
struct shm_ring {
    uint32_t write_idx;
    uint32_t read_idx;
    char     data[SHM_SIZE];  // 环形缓冲区
};
// 发送端
void send_message(struct shm_ring *ring, const void *msg, size_t len) {
    memcpy(&ring->data[ring->write_idx % SHM_SIZE], msg, len);
    __atomic_add_fetch(&ring->write_idx, 1, __ATOMIC_RELEASE);  // 写屏障
    uint64_t one = 1;
    write(efd, &one, sizeof(one));  // 通知接收端
}
// 接收端(epoll 主循环中,普通上下文)
void recv_message(struct shm_ring *ring, void *msg, size_t *len) {
    while (__atomic_load_n(&ring->read_idx, __ATOMIC_ACQUIRE) <
           __atomic_load_n(&ring->write_idx, __ATOMIC_ACQUIRE)) {
        __atomic_add_fetch(&ring->read_idx, 1, __ATOMIC_RELAXED);
        // 处理消息...
    }
}
六、futex —— 线程间同步不该用信号
pthread_kill 的滥用
// 反模式:用信号做线程同步
pthread_kill(thread_B, SIGUSR1);  // 通知线程 B
// 线程 B 的 handler 中做事...为什么这是反模式:
- 信号路径的完整开销(FPU save/restore、sigframe、sigreturn)被浪费在"通知另一个线程"这种简单需求上
- 线程 B 的 handler 中断了它正在执行的代码——不管线程 B 在干什么,必须停下来
- 被中断的线程 B 可能正持有锁 → handler 中再拿同一把锁 → 死锁
futex 为什么快
// 比 pthread_kill 快的方式:futex
pthread_mutex_lock   → futex(FUTEX_WAIT)   ← 无争用时不进内核!
pthread_cond_signal  → futex(FUTEX_WAKE)   ← 只唤醒,不走信号路径
// futex 路径(无争用 happy path):
//   userspace: atomic cmpxchg → 拿到锁 → 直接返回
//   不进内核!0 次 syscall!
//
// futex 路径(有争用):
//   sys_futex(FUTEX_WAIT) → 挂到 futex_q → schedule()
//   sys_futex(FUTEX_WAKE) → 从 futex_q 出队 → wake_up
// 比 RT 信号快 ~10x(无 sigqueue 分配、无 pending set、无 handler)| pthread_kill(SIGUSR1) | futex(FUTEX_WAKE) | |
|---|---|---|
| 无争用时 | 必须进内核(完整信号路径) | ★ 不进内核(atomic cmpxchg 在用户态完成) |
| 有争用时 | sigqueue 分配 + 信号投递 | futex_q 排队 + wake_up |
| 接收方上下文 | handler 中(async-safe 限制) | 普通上下文 |
| FIFO 保证 | 无(标准信号不排队,RT 信号排队) | 有(futex 等待队列 FIFO) |
七、性能对比总表
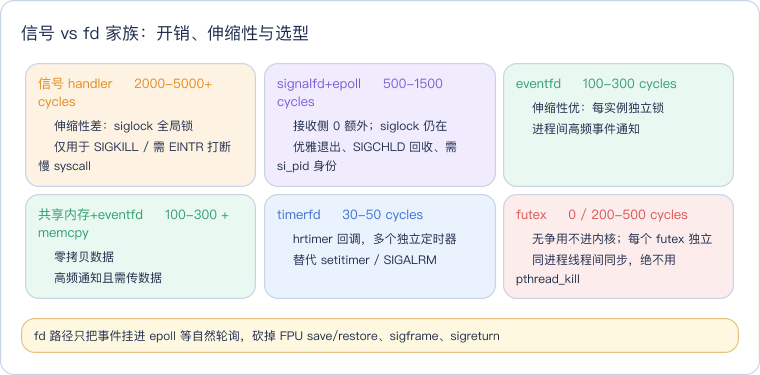
                     每事件开销 (cycles)    高并发伸缩性    编程模型
                     ──────────────────    ─────────────    ────────
信号 handler         2000-5000+            ★ 差             异步、受限
  (标准信号)          (FPU+帧+handler)      siglock 全局锁    (async-safe)
signalfd + epoll     500-1500 (发送同)     中               同步、fd 模型
                     0 额外 (接收同epoll)   siglock 仍在     无限制
eventfd              100-300               ★ 优             同步、fd 模型
                      无 siglock            每实例独立锁     无限制
共享内存+eventfd     100-300 (通知) +       ★ 优             同步、fd 模型
  (数据传递)          memcpy (数据)         零拷贝数据       无限制
timerfd              30-50 (hrtimer回调)    ★ 优             同步、fd 模型
                      无信号路径            多个独立定时器   无限制
futex                0 (无争用, 不进内核)    ★ 优             同步
                      200-500 (有争用)       每个 futex 独立   无限制
八、选择决策树
你的通知场景是?

├─ 进程间高频事件通知(每秒万次+)
│   → eventfd + 共享内存(如果需要传数据)

├─ 进程优雅退出(SIGTERM/SIGINT 响应)
│   → signalfd + epoll
│   (保留下一个 SIGTERM 的语义:最后手段)

├─ 子进程退出回收(替代 SIGCHLD)
│   → signalfd(SIGCHLD) + epoll → read(sfd) → waitpid(-1, WNOHANG)

├─ 定时器(替代 setitimer/SIGALRM)
│   → timerfd + epoll

├─ 同一进程内线程间同步
│   → futex / pthread 条件变量
│   (永远不要用 pthread_kill 做线程同步)

├─ 进程终止(SIGKILL 语义)
│   → 只能用真信号(没有 fd 替代方案)
│   (SIGKILL 不可捕获/屏蔽是设计特性,必须保留)

├─ 需要发送者身份(si_pid/si_uid)
│   → signalfd 保留身份信息
│   (eventfd 不携带发送者身份)

└─ 需要打断慢系统调用(EINTR 语义)
    → 只能用真信号
    (eventfd/signalfd 不能中断 read/write)
九、与其它文档的关系
- 内核机制:signals-kernel —— 信号的完整内核路径(数据结构 + 调用链 + 性能分析),理解"为什么信号慢"需要这篇。
- 用户态编程:signals-user —— 信号的 API 速查 + 实战 Demo,包含 signalfd + epoll 完整集成示例。
- VFS fd 模型:vfs-file-operations ——
file_operations多态分发原理,理解为什么 eventfd/signalfd/timerfd 都能通过同一个 epoll 统一调度。 - FUSE:fuse —— 用户态文件系统的代理架构,与本文的"把内核服务搬到用户态"是同一个思路的两个方向。
总结
能用 fd 就别用信号:eventfd/signalfd/timerfd 把通知变成可被 epoll 统一等待的文件描述符,避开信号 handler 的异步、不可重入与 EINTR 坑。选型按场景走——高频进程间事件通知用 eventfd(+共享内存传数据);进程优雅退出与子进程回收用 signalfd + epoll(回收子进程即 signalfd(SIGCHLD)→read→waitpid(-1, WNOHANG));定时器用 timerfd;同进程线程间同步用 futex/pthread 条件变量(绝不用 pthread_kill)。两类场景没有 fd 替代、只能用真信号:SIGKILL 终止进程(不可捕获/屏蔽是设计特性),以及需要打断慢系统调用(EINTR 语义,eventfd/signalfd 中断不了 read/write);需要发送者身份(si_pid/si_uid)时 signalfd 保留、eventfd 不携带。