间接分支预测(Indirect Branch Prediction)—— 虚函数、函数指针、跳转表为什么可能比你想象的慢
branch-prediction 讲的是直接分支(
jcc)的方向预测——CPU 只需要猜"跳还是不跳"。本篇聚焦间接分支(call *%rax/jmp *%rax):CPU 不仅要猜方向,还要猜一个任意的目标地址。虚函数调用慢不慢?函数指针有没有额外开销?switch 为什么有时用跳转表、有时用 if-else 链?这些问题的答案都藏在间接分支预测器里。
前置:建议先读 branch-prediction 建立"分支预测 + 投机执行"的基本框架(BTB / 方向预测 / 流水线 flush),本篇不再重复这些基础概念。
它是微架构演进链的"⑤分支预测+投机"环节的间接分支专题——整条链的导读见 cpu-microarch-overview。
术语速查
全文高频出现的缩写和术语,首次遇到时可回查此表:
| 缩写 | 全称 | 中文 | 一句话 |
|---|---|---|---|
| BTB | Branch Target Buffer | 分支目标缓冲 | 用指令地址查"上次跳去哪",直接/间接分支都用 |
| BHT | Branch History Table | 分支历史表 | 记录每条分支"上次走没走",管 jcc 方向预测 |
| ITTAGE | Indirect Target TAGE | 间接目标TAGE预测器 | 本文核心:IP + 全局历史联合索引,预测 call*/jmp* 的目标地址 |
| RSB | Return Stack Buffer | 返回栈缓冲 | 硬件 LIFO 栈,call 压入返回地址 / ret 弹出,≈100% 命中 |
| GHR | Global History Register | 全局分支历史寄存器 | 记录最近 N 条分支的 taken/not-taken 序列,给 ITTAGE 提供"路径上下文" |
| IP | Instruction Pointer | 指令指针 | 当前指令地址(x86 上叫 RIP),BTB/ITTAGE 的索引键之一 |
| PMU | Performance Monitoring Unit | 性能监控单元 | CPU 内置计数器,perf 事件的硬件来源 |
| ROB | Reorder Buffer | 重排序缓冲 | 乱序执行核心,暂存"已执行但未退休"的指令 |
| 缩写 | 全称 | 中文 | 一句话 |
|---|---|---|---|
| PGO | Profile-Guided Optimization | 面向剖析的优化 | 根据实际运行 profile 辅助编译器去虚拟化 |
| LTO | Link-Time Optimization | 链接时优化 | 跨编译单元优化,可发现更多去虚拟化机会 |
| CRTP | Curiously Recurring Template Pattern | 奇异递归模板模式 | C++ 编译期多态技法,用模板替代虚函数 |
| 缩写 | 全称 | 中文 | 一句话 |
|---|---|---|---|
| BTI | Branch Target Injection | 分支目标注入 | Spectre v2 攻击手段:污染间接分支预测器 |
| IBRS | Indirect Branch Restricted Speculation | 间接分支受限投机 | Spectre v2 缓解:限制间接分支投机执行 |
| STIBP | Single Thread Indirect Branch Predictors | 单线程间接分支预测器 | Spectre v2 缓解:隔离不同超线程的间接分支预测 |
前置知识:直接分支 vs 间接分支
直接分支(jcc)和间接分支在硬件眼里是两类不同的问题:
直接分支 (jcc) | 间接分支 (call */jmp *) | 返回 (ret) | |
|---|---|---|---|
| 典型指令 | je / jne / jg / jle | call *%rax / jmp *(%rdi) | ret |
| C/C++ 对应 | if / for / while | 虚函数、函数指针、switch 跳转表 | 函数调用返回 |
| 目标地址 | 编码在指令里(立即数偏移) | 运行时从寄存器/内存取 | 栈顶 |
| 要猜什么 | 只猜方向 (taken/not-taken) | 方向 + 目标地址 | 只猜目标地址 |
| 负责部件 | 方向预测器 (BHT/TAGE) | 间接分支预测器 (ITTAGE) | RSB |
| perf 事件 | branches / branch-misses | branch-loads / branch-load-misses | — |
| 误预测惩罚 | ~15~20 拍 | 更重:猜错地址还要冲刷流水线重新取指 | ~10 拍(RSB 命中率高) |
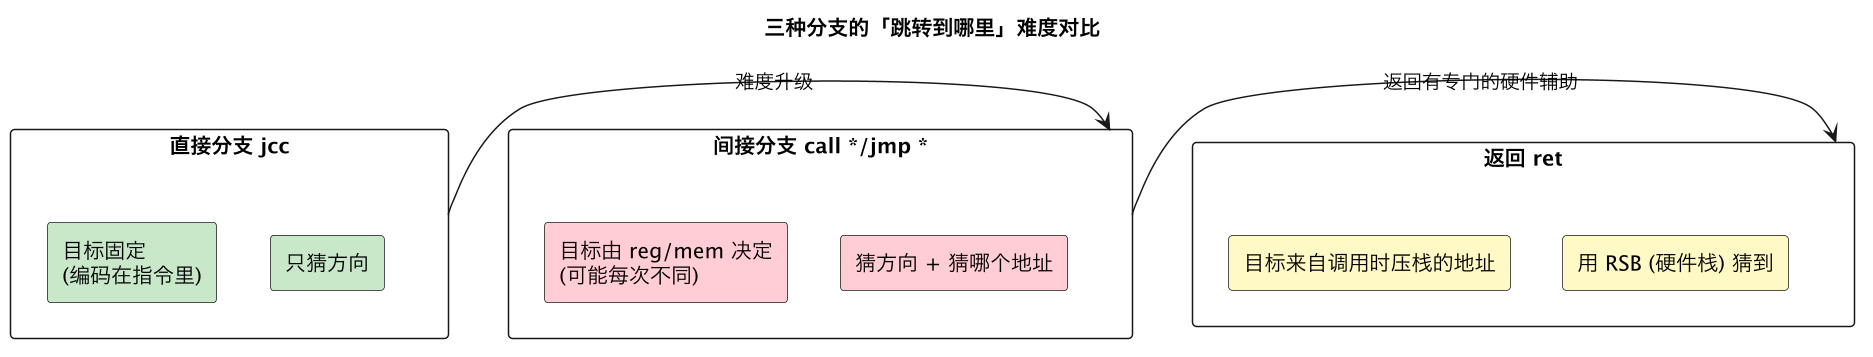
下面用一张序列图把三种分支在 CPU 前端流水线里的处理流程展开对比——同样是从 Fetch 开始,三种指令走过的路径差异巨大:
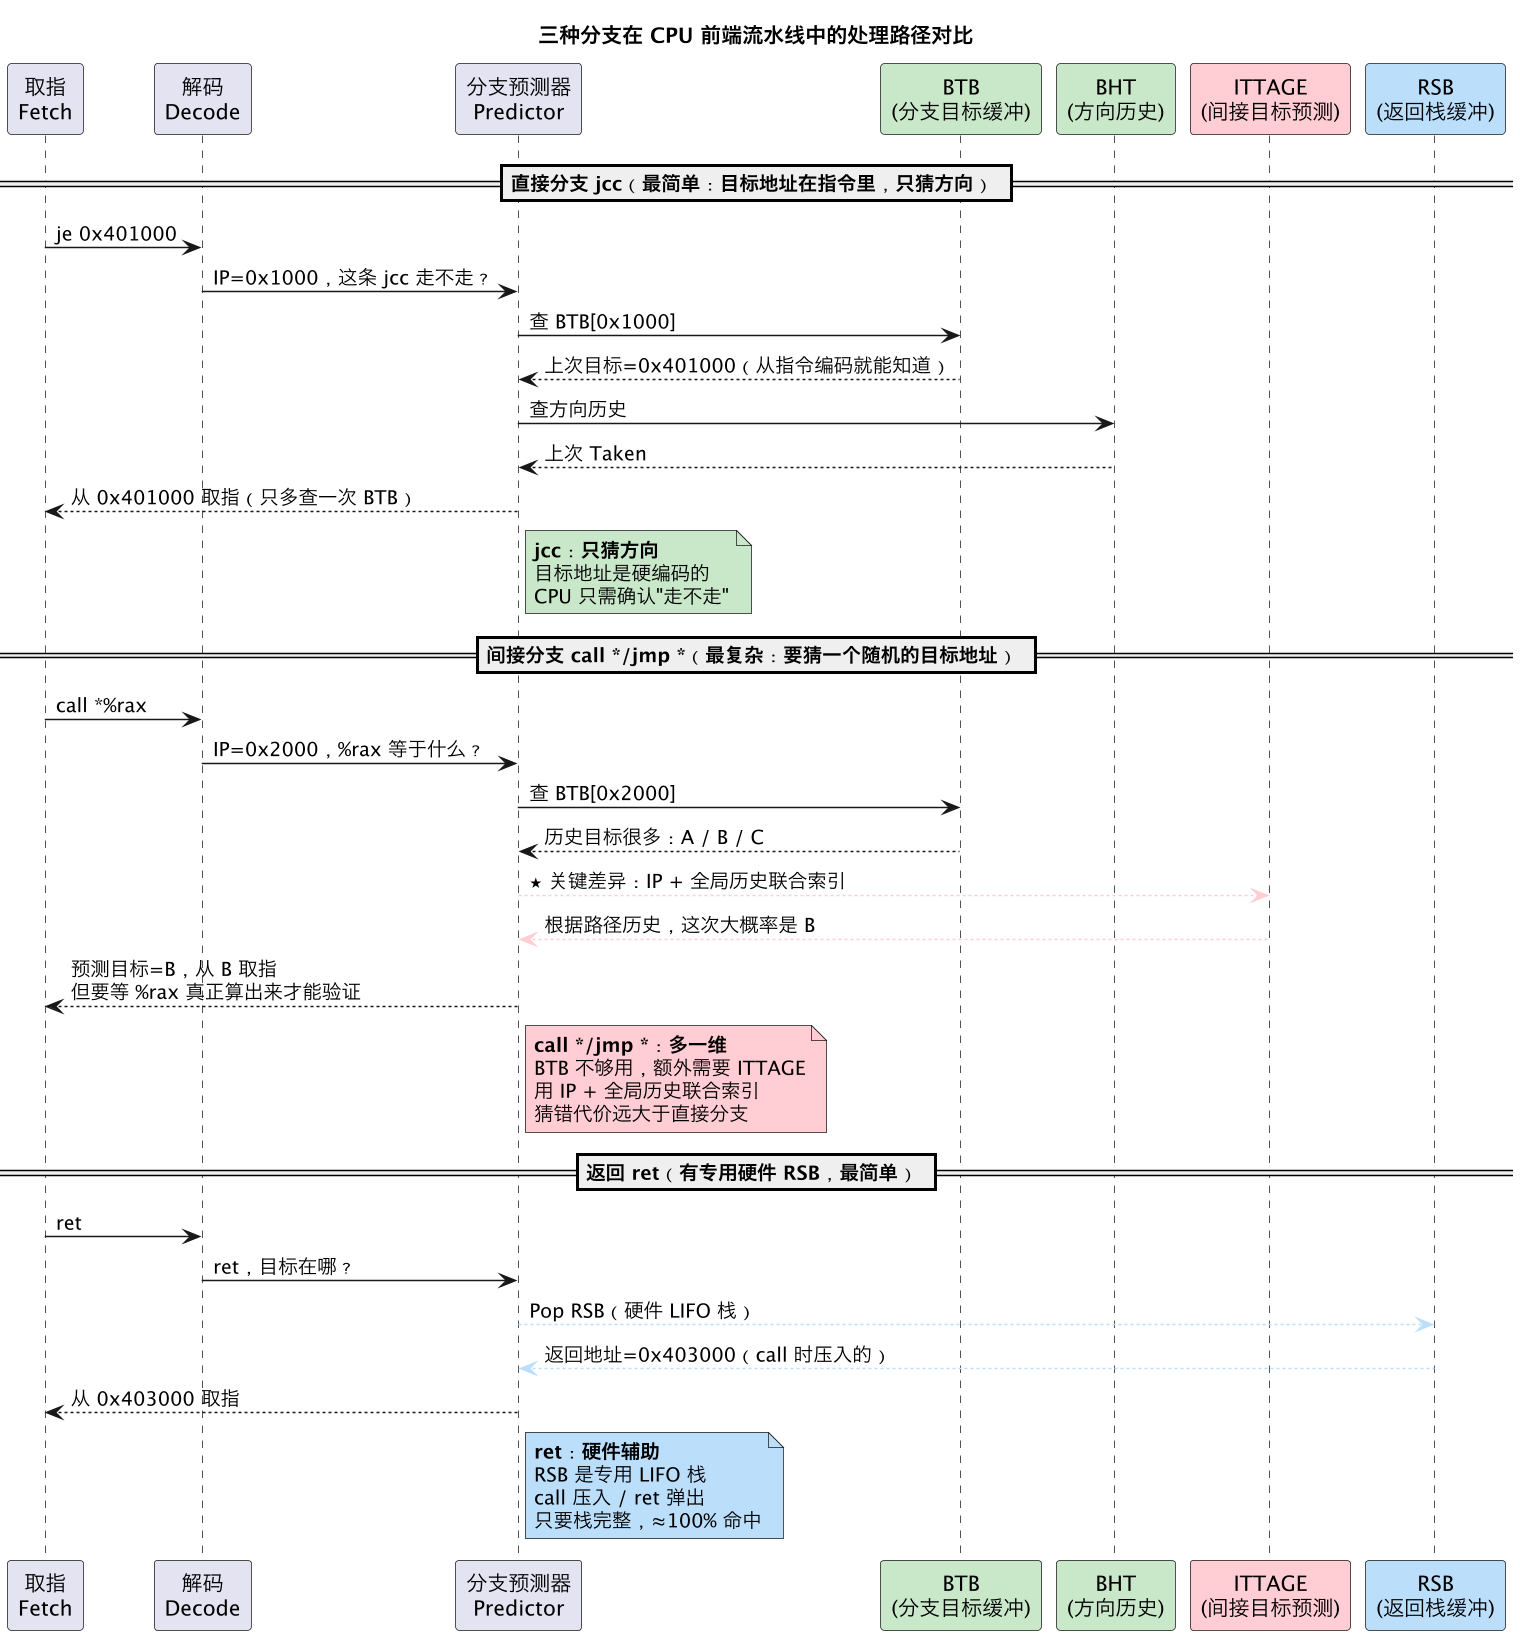
核心区别:直接分支(jcc)的目标地址是指令自带的立即数——编译器把它硬编码在机器码里,BTB 只需确认"上次跳到哪里",真正的预测任务是方向(走或不走)。而 call *%rax / jmp *%rax 的目标地址完全来自寄存器或内存——每次执行时 %rax 可能指向不同函数,BTB 只能记录"这条指令历史上去过哪些地址",却无法从指令本身知道"这次是哪个"。所以 CPU 必须引入ITTAGE(间接分支目标预测器),用 IP + 全局分支历史联合索引——本质上是在做"根据过去走到这里的路径模式,猜这次调的是哪个函数"。至于 ret,CPU 有专门的 RSB 硬件栈,call 时压入返回地址、ret 时弹出,是一个简单可靠的 LIFO 结构,几乎不需要"猜"。
一句话:间接分支比直接分支多一个维度——不仅要猜"走不走这条路",还要猜"这条路通到哪个地址"。直接分支查一张表(BHT),间接分支查两张表(BTB + ITTAGE),
ret最简单(RSB 是专用硬件栈)。这就是为什么虚函数和函数指针可能成为热点:目标地址猜不中。
一、间接分支的硬件:ITTAGE 多级目标预测器
1.1 BTB 管直接分支,间接分支预测器管 call * / jmp *
回顾 branch-prediction.md:BTB(Branch Target Buffer)用 IP(指令地址)索引,查到"这条 jcc 上次跳到了地址 A"——但这对间接分支不够用,因为同一个 call *%rax 指令,%rax 可能指向五个不同的函数。
现代 CPU 有独立的间接分支预测器(Intel 上叫 ITTAGE,AMD 上机制类似),专门处理"同一个 IP 有多个目标"的情况:
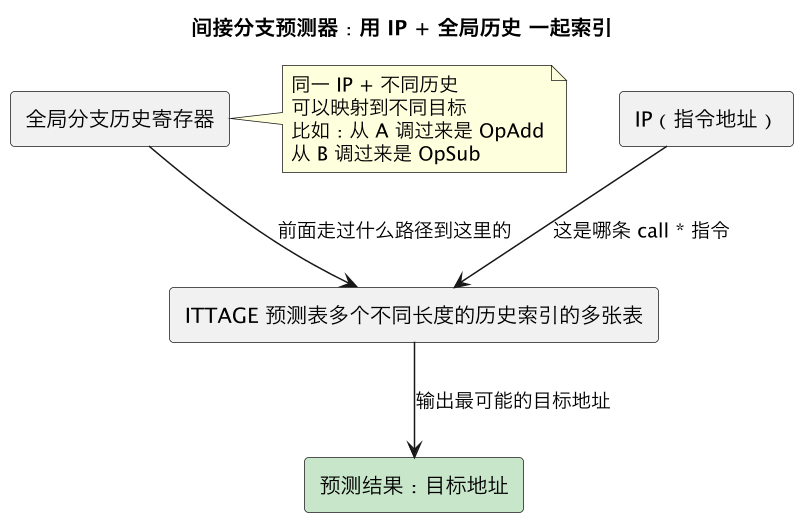
关键洞察:ITTAGE 不仅看 IP,还看"全局分支历史"——即"走到这条 call *%rax 之前,经过了哪些分支"。这让它能区分同一 IP 在不同调用上下文下的不同目标。
1.2 单态 vs 多态 vs 巨态:预测器怎么学
对间接分支预测器来说,目标地址的数量和规律决定了准确率:
| 态 | 目标数 | 举例 | 预测器行为 | 开销 |
|---|---|---|---|---|
| 单态 (monomorphic) | 1 | 90%+ 虚函数调用实际是同一种子类 | 第一次 miss 后学到,之后几乎零开销 | ~5% vs 直接调用 |
| 双态 (bimorphic) | 2 | 两种策略交替调用 | 学交替模式(类似两位计数器学 TNTN) | ~10% vs 直接调用 |
| 三态 | 3 | 三种实现轮转 | 可能学会(取决于预测表容量) | ~20% vs 直接调用 |
| 巨态 (megamorphic) | 4+ 随机 | 插件系统、回调注册表 | 无法学习,每次都是赌 | 50%+ vs 直接调用 |
1.3 RSB:专门优化 ret 的硬件栈
call 时 CPU 把返回地址压入 RSB(Return Stack Buffer,一个 16~32 项的硬件栈),ret 时弹出预测。这是一个专用的后进先出结构,和 BTB / ITTAGE 完全独立。只要调用和返回正确配对(没有 longjmp、协程切换等破坏栈平衡的操作),RSB 预测准确率接近 100%。
但 Spectre v2 攻击者会故意用间接跳转让 RSB 溢出或被污染,这是另一回事——见第七节。
二、虚函数:OOP 的性能暗面
2.1 多态的内存布局:vptr 与 vtable
在讨论"虚函数为什么会变成间接分支"之前,先看清楚编译器在内存里到底放了哪些东西。C++ 的多态依赖两张表、一个指针、一条寻址链:
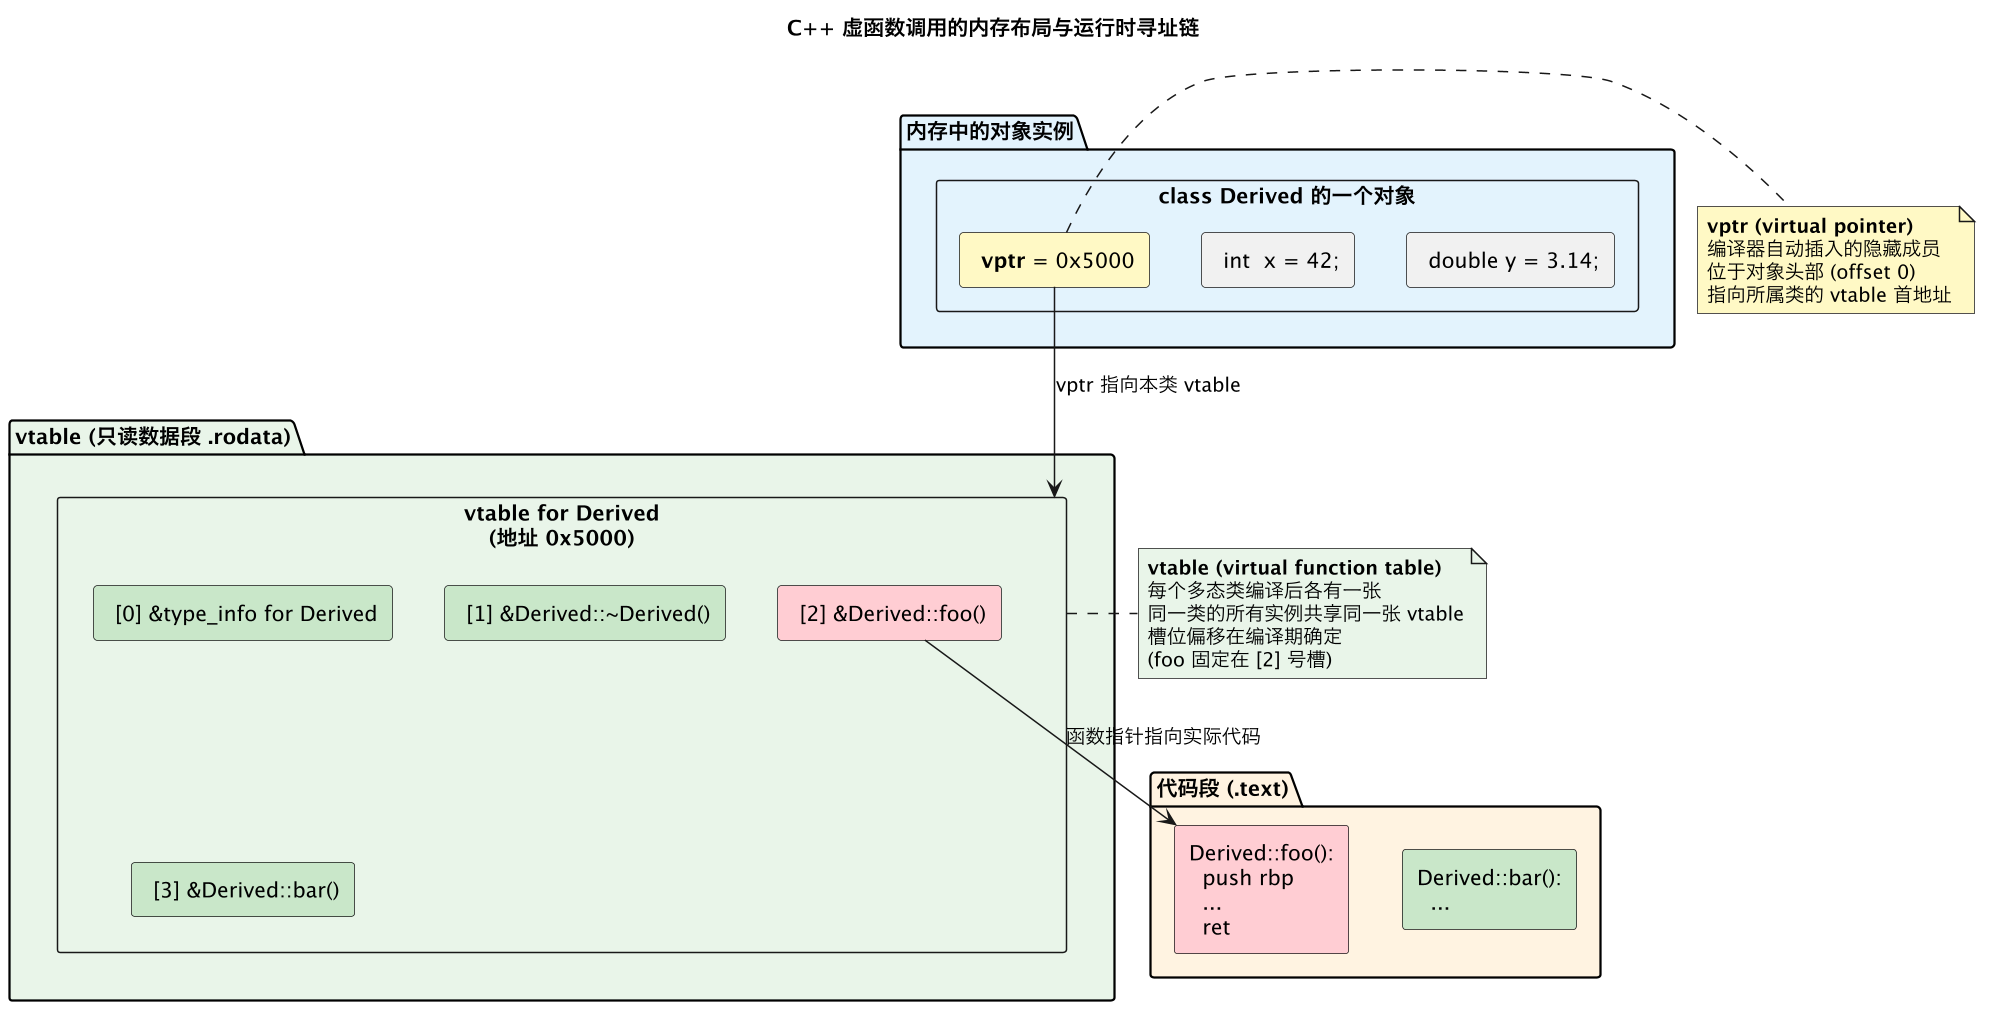
三张表/段,一条寻址链:
| 层次 | 所在内存区域 | 内容 | 谁管 |
|---|---|---|---|
| 对象实例 | 栈或堆 | 头部一个隐藏 vptr + 成员变量 | 每个对象一份 |
| vtable | 只读数据段 .rodata | 函数指针数组 [&foo, &bar, ...] | 每个类一张,所有实例共享 |
| 函数代码 | 代码段 .text | 实际的机器指令 | 全局唯一 |
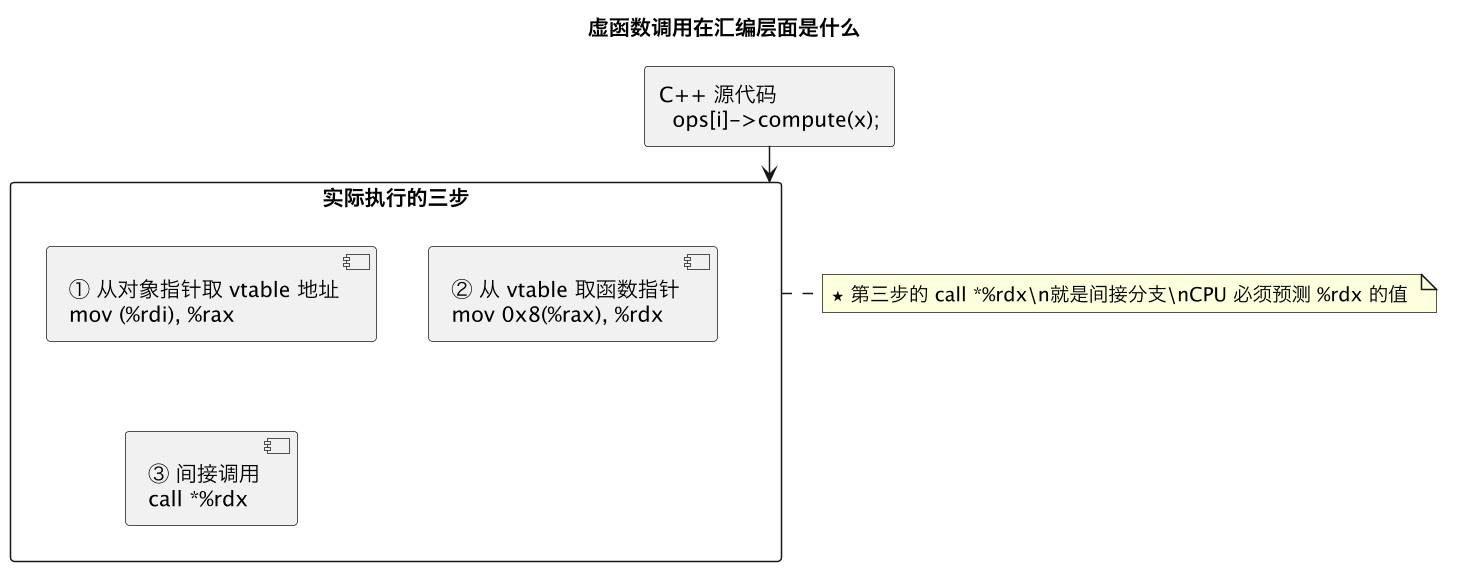
运行时分发 ptr->foo() 的过程就是顺着这条链走三步:
| 步骤 | 汇编 | 在做什么 | 访存次数 |
|---|---|---|---|
| ① 取 vptr | mov (%rdi), %rax | 从对象首地址读出 vtable 地址 | 1 次 |
| ② 取函数指针 | mov 0x10(%rax), %rdx | vtable[2] → 拿到 foo 的入口地址 | 1 次 |
| ③ 间接调用 | call *%rdx | 跳转到 %rdx 指向的代码 | 0 次(只是跳转) |
关键点:
- 步骤①②是确定性的:编译器知道
foo在 vtable 的第几个槽(比如[2]),所以偏移0x10是编译期常量。这两步只是"顺着固定路径读两次内存",没有分支。 - 步骤③才是不确定性的来源:
call *%rdx的%rdx值取决于运行时的对象类型。如果ptr实际指向Derived,%rdx=&Derived::foo;如果指向AnotherDerived,%rdx=&AnotherDerived::foo。CPU 必须预测%rdx会是什么——这就是间接分支预测要解决的问题。 - 注意 vtable 是编译期静态生成的,存放在只读段,不是运行时动态构造的。程序的"多态"就体现在:不同对象实例的
vptr指向不同的 vtable,而call *vtable[2]这条指令是固定的——同一指令,不同目标。
多继承的情形:如果
Derived继承了多个基类,对象里会有多个 vptr(每个基类子对象一个),每个基类的 vtable 槽位对应的函数指针可能指向一个 thunk(调整 this 指针的小段代码),再跳转到真正的函数。但对 CPU 来说,最终都是call *%reg,本质不变。本文以单继承为例,多继承的间接分支行为完全同理。
2.2 为什么是间接分支
虚函数调用的本质是两次间接寻址 + 一次间接 call:
; C++: base->foo()
;
; 第一步:从对象取 vtable 指针
    mov    (%rdi), %rax          ; vtable_ptr = *this
; 第二步:从 vtable 取函数指针(偏移由编译器确定)
    mov    0x10(%rax), %rdx      ; func_ptr = vtable_ptr[2]  (foo 在 vtable 的第三个槽位)
; 第三步:间接调用
    call   *%rdx                  ; ★ 间接分支!
大多数 OOP 代码中,虚函数调用是单态的——虽然语法上 base->foo() 可以指向任何子类,但运行时 90%+ 都是同一种类型。间接分支预测器学会"这个 IP 永远跳向同一个目标"后,call *%rdx 几乎和直接 call 一样快。
2.3 单态不慢,巨态才是瓶颈
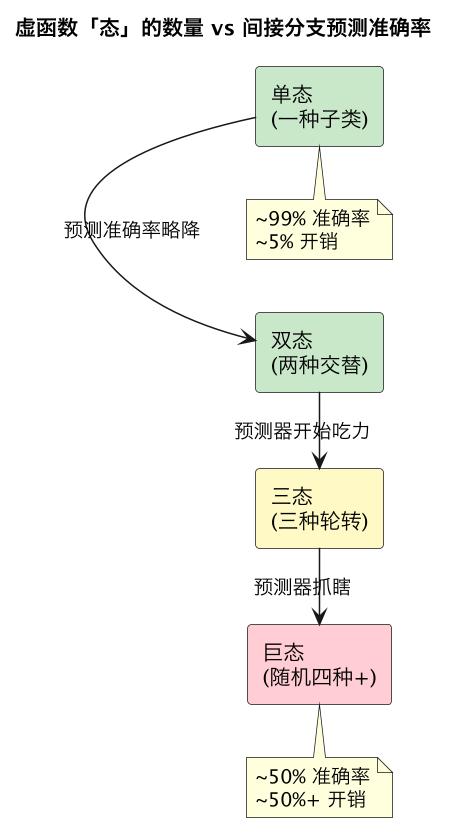
日常 OOP 代码中绝大多数虚函数调用是单态的——不必谈虚函数色变。但当你的设计走向插件系统、回调注册表、std::function 容器时,一个 call * 指令可能面对数十个目标,间接分支预测器就完全失效了。
三、函数指针:本质相同
typedef int (*op_t)(int);
op_t ops[] = { add, sub, mul, shl };

for (int i = 0; i < N; i++)
    sum += ops[i](x);      // call *%rax —— 间接分支
函数指针 call *%rax 和虚函数 call *(%rdx) 在 CPU 眼里完全一样——都是间接分支,都走 ITTAGE 预测器。区别仅在前面的寻址方式(虚函数多了取 vtable 的步骤),但间接分支本身的开销相同。
结论:函数指针的性能瓶颈不是"指针本身",而是间接分支预测。一个始终指向同一函数的函数指针,和直接调用一样快;一个在四个函数间随机的函数指针,和巨态虚函数一样慢。
四、switch 跳转表:编译器帮你转成了间接跳转
4.1 编译器如何决定:跳转表 vs if-else 链
switch (x) {
    case 0: f0(); break;
    case 1: f1(); break;
    case 2: f2(); break;
    case 3: f3(); break;
    case 4: f4(); break;
}
当 case 值密集连续时,编译器生成跳转表:
    ; x 在 %rax 中
    jmp    *.L4(,%rax,8)     ; ★ 间接跳转!jmp *disp(base, index, scale)

.L4:
    .quad  .L0               ; case 0 → 地址 0
    .quad  .L1               ; case 1 → 地址 1
    .quad  .L2               ; case 2 → 地址 2
    .quad  .L3               ; case 3 → 地址 3
.quad .L4 ; case 4 → 地址 4| case 特征 | 编译器选择 | 分支类型 | 分支预测 |
|---|---|---|---|
| 密集连续值 (0,1,2,3,4) | 跳转表 jmp *disp(,%rax,8) | 间接跳转 | 走间接分支预测器 |
| 稀疏值 (1, 100, 500) | if-else 链 cmp/je | 直接分支 | 走方向预测器 |
| 少量值 (2~3 个) | if-else 链 | 直接分支 | 走方向预测器 |
4.2 跳转表的目标地址有特殊性
跳转表的目标地址与间接调用有微妙区别:
- 虚函数:目标地址分散在各个子类的代码段,地址值相差可能很大
- 跳转表:所有目标地址连续排列在同一张表里,地址值相近
现代间接分支预测器可能利用目标地址的连续性做预测,因此 switch 跳转表对随机 case 值的容忍度通常好于巨态虚函数。
五、去虚化:怎么让间接分支变成直接分支
目标是消除 call *%reg,变成 call <fixed_addr>——省掉间接分支预测这个环节。
5.1 手段一览
| 手段 | 原理 | 运行时开销 | 适用场景 |
|---|---|---|---|
final 关键字 | 告诉编译器这个类不再被继承 → 直接 call | 零 | 叶子类 |
| CRTP | 编译期多态替代运行时多态 | 零 | 可模板化的接口 |
| PGO | 编译器根据热点数据,对单态虚函数投机去虚化:if (vptr == &OpAdd::vtable) call OpAdd::compute; else call *vtable[2] | 极低 | 有 profile 数据的构建 |
std::variant + visit | 用 switch 跳转表替代虚函数表 | 低 | 有限类型集合 |
| 分支打散 | 把巨态分发拆成多层双态分发 | 低 | 目标多但有层次结构 |
| LTO (Link-Time Optimization) | 跨编译单元发现"这个虚函数实际只有一个实现" → 直接调用 | 零 | 整个程序构建 |
| 手写分派表 | 用显式的 switch/if-else 替代虚函数 | 零 | 热路径、已知类型全集 |
5.2 PGO 投机去虚化原理(最巧妙的方案)
// 原始虚函数调用
obj->compute(x);

// PGO 优化后编译器生成
if (obj->_vptr == &OpAdd::vtable)        // 投机:先检查是不是单态
    OpAdd::compute(obj, x);              // 是 → 直接调用,零间接分支开销
else
    obj->_vptr[2](obj, x);               // 不是 → 走虚函数表(间接分支)
PGO 收集热点数据,发现 obj->compute() 在 99% 的情况下调用的是 OpAdd::compute,于是在调用前插入一个 vtable 指针比较——命中了走快速路径(直接 call),没命中走慢速路径(间接 call)。快速路径是直接分支(cmp + jne),比间接分支好预测得多。
5.3 什么时候需要去虚化
| 场景 | 决策 |
|---|---|
| 虚函数调用在非热路径上 | 不管——不热就不用优化 |
| 热路径 + 单态(perf 显示 branch-load-misses 低) | 不管——预测器已经学会了 |
| 热路径 + 巨态(perf 显示 branch-load-misses >10%) | 动手——按上表选择合适的手段 |
| 模板化接口可行 | CRTP——零开销,最彻底的方案 |
| 有限类型集合 | std::variant + visit——无需继承,语义清晰 |
口诀:先
perf stat -e branch-loads,branch-load-misses,单态不管,巨态去虚化。
六、间接分支误预测的代价
间接分支猜错的惩罚比直接分支更重:
| 直接分支 (jcc) 误预测 | 间接分支误预测 | |
|---|---|---|
| 猜错什么 | 方向 | 目标地址 |
| 后果 | 从错误方向取指 → 重定向 | 从完全不相关的地址取指 → 重定向 |
| I-cache 影响 | 可能命中(相邻代码) | 几乎必 miss(跳到了完全不相干的地方) |
| iTLB 影响 | 通常同页 | 高概率换页 → iTLB miss |
| 惩罚 | ~15~20 拍 | ~20~30 拍(连锁 I-cache miss + iTLB miss) |
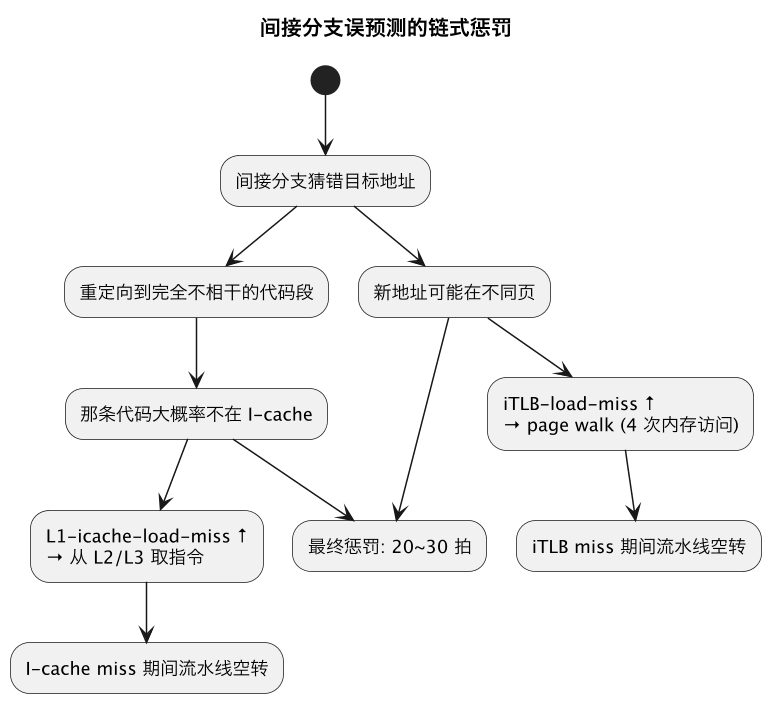
这就是为什么巨态虚函数慢得那么明显:不仅间接分支预测器猜不中目标地址,猜错后还要付 I-cache miss + iTLB miss 的连锁账单。
七、Spectre v2 (BTI):间接分支的安全暗面
branch-prediction 第七节讲了 Spectre v1(边界检查绕过,利用 jcc 方向预测的投机执行)。Spectre v2(Branch Target Injection,BTI)攻击的是间接分支预测器:
- 攻击者训练间接分支预测器,让
call *%rax或jmp *%rax在投机执行时跳转到攻击者选择的gadget(如speculation gadget) - 这个 gadget 在投机窗口内泄露数据到缓存 → 侧信道读出
缓解手段:
| 手段 | 原理 | 性能代价 |
|---|---|---|
| retpoline | 把 call *%rax 改写成 call retpoline_thunk; ... retpoline_thunk: call .L1; .L1: pause; lfence; jmp .L2; .L2: mov %rax, (%rsp); ret —— 用 ret(RSB 预测)代替间接 call(ITTAGE 预测),因为 RSB 不被 Spectre v2 污染 | 中 |
| IBRS (Indirect Branch Restricted Speculation) | 内核态设置 MSR 标志,限制间接分支的投机行为 | 中~高 |
| STIBP (Single Thread Indirect Branch Predictors) | 防止超线程间共享间接分支预测器状态 | 低~中 |
| eIBRS (Enhanced IBRS) | 硬件辅助的 IBRS,性能代价更低 | 低 |
retpoline 是最著名的手段:它把间接分支预测交给了 RSB(返回栈),而 RSB 是一个硬件栈(不是通过历史学习),不受 Spectre v2 训练攻击的影响。代价是每次间接调用多几条指令。
八、怎么观测
8.1 直接看间接分支预测
# 间接分支总数 vs 误预测数
perf stat -e branch-loads,branch-load-misses ./app

# 同时看直接和间接分支
perf stat -e cycles,instructions,\
branch-instructions,branch-misses,\
branch-loads,branch-load-misses ./app
注意 PMU 事件的两组对应关系:
| PMU 事件 | 统计对象 | 含义 |
|---|---|---|
branch-instructions | 直接分支 (jcc) | 条件/无条件直接跳转总数 |
branch-misses | 直接分支 (jcc) | 直接分支预测失败数 |
branch-loads | 间接分支 (call*/jmp*) | 间接调用/跳转总数 |
branch-load-misses | 间接分支 (call*/jmp*) | 间接分支预测失败数 |
8.2 诊断流程
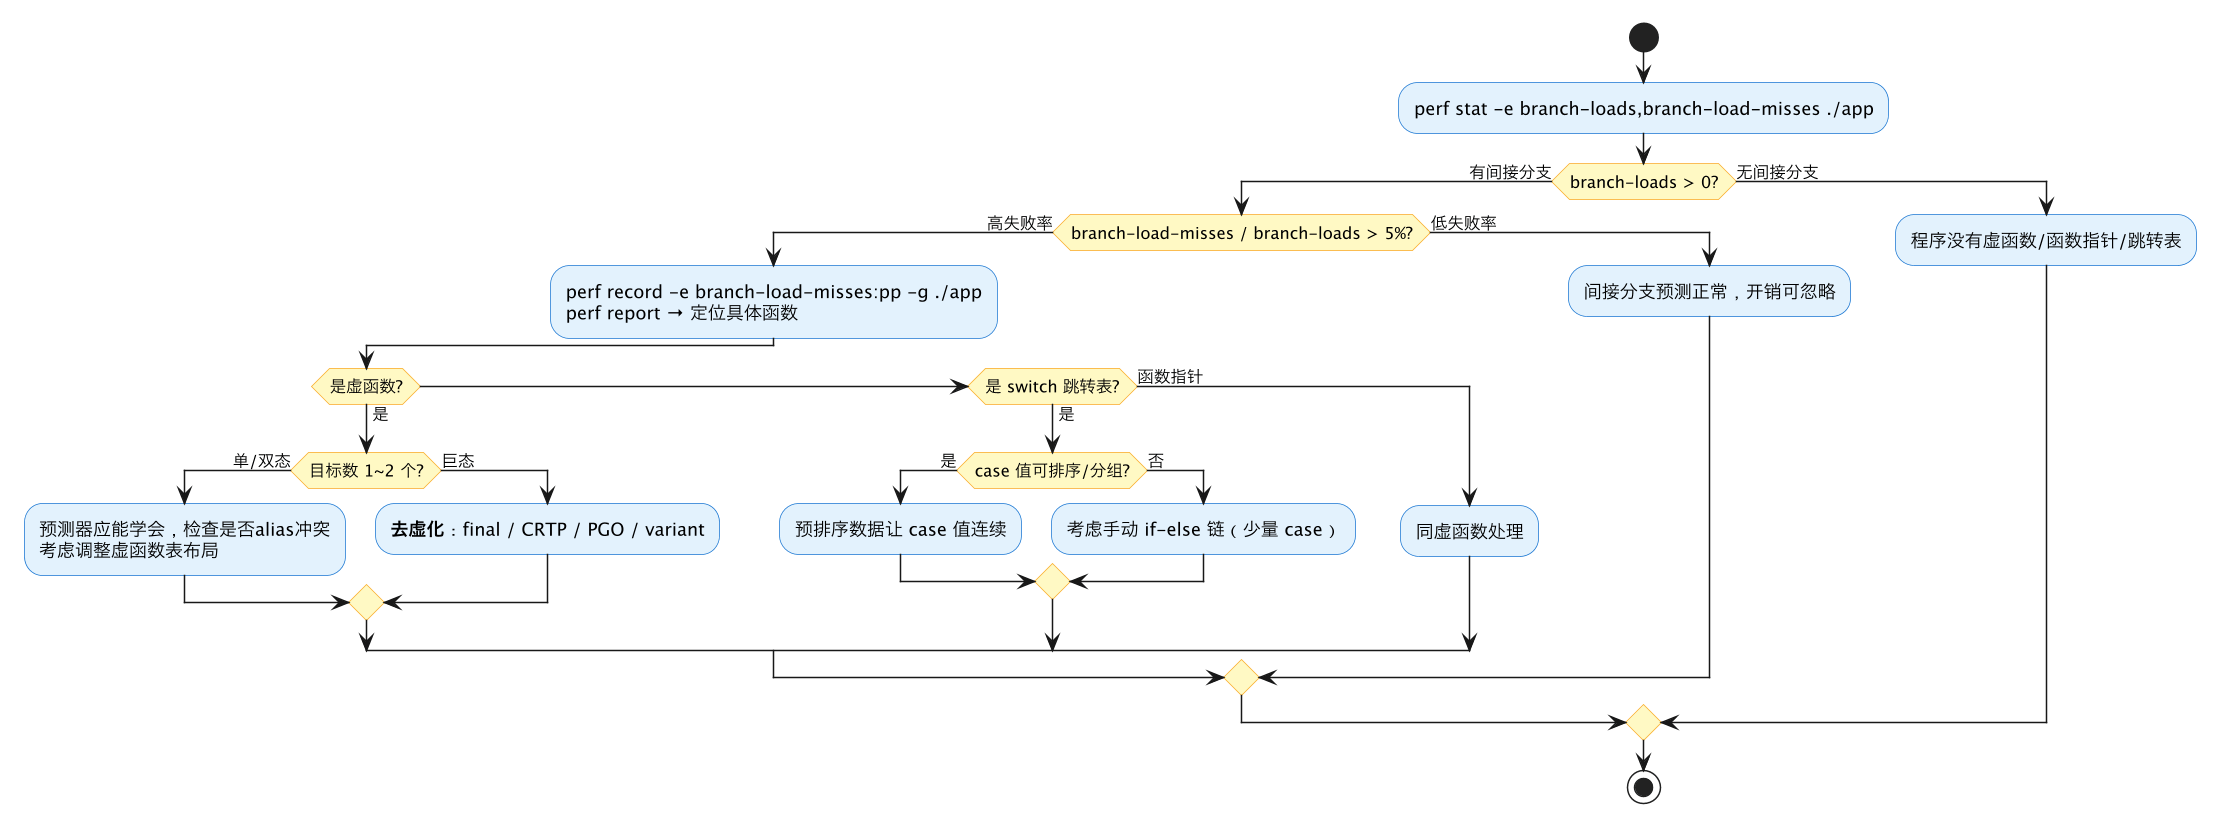
8.3 perf 命令速查
| 我想知道... | 用这个 |
|---|---|
| 间接分支预测失败率 | perf stat -e branch-loads,branch-load-misses ./app |
| 哪个函数在间接 miss | perf record -e branch-load-misses:pp -g ./app && perf report |
| 哪条 call* 指令在 miss | perf annotate(在 report 中进入热点函数后) |
| 间接 + 直接分支一起看 | perf stat -e branches,branch-misses,branch-loads,branch-load-misses ./app |
| 间接miss 是否连带 I-cache miss | perf stat -e branch-load-misses,L1-icache-load-misses,iTLB-load-misses ./app |
cpp// main.cpp —— 间接分支预测实验 // // 对比四种调用方式的分支预测行为: // 1. 直接函数调用 → 无间接分支,call 目标已知,零开销 // 2. 单态虚函数 → 间接分支 (call *%rax),但目标始终不变 // CPU 间接分支预测器很快"学会",准确率 >99% // 3. 多态虚函数 → 间接分支,目标在每个对象间交替变化 // CPU 能预测简单交替模式,准确率仍很高 // 4. 巨态虚函数 → 间接分支,目标完全随机变化 // 预测器无从学起,准确率大幅下降 // // 核心原理: // - 直接分支 (jcc) 只要猜"跳/不跳"一个 bit // - 间接分支 (call *%rax / jmp *%rax) 还要猜**跳转到哪个地址** —— 难得多 // - 现代 CPU 有专门的 indirect branch predictor 和 ITTAGE 来应对 // - 单态/少态虚函数:predictor 轻松学会 // - 巨态虚函数:predictor 抓瞎,每次都是赌 // // 编译: make // make perf → perf stat 全指标 // make perf-branch-loads → 只看 branch-loads / branch-load-misses // // 用法: // ./indirect_branch → 四种模式耗时对比 + perf 建议 #include <iostream> #include <vector> #include <chrono> #include <iomanip> #include <cstdlib> #include <cstring> #include <random> #include <algorithm> constexpr int N = 4096; // 对象数量 constexpr int ROUNDS = 10000; // 每模式重复测量轮数 constexpr int WARMUP = 500; // 计时前先跑这么多轮预热 (让 iCache + predictor 进入稳态) constexpr int TRIALS = 5; // 计时后跑这么多遍取中位数 (避免噪声) // ── 虚函数类层级 ──────────────────────────────────────────────── // 模拟一个简化的"运算"接口, 类似 FPGA/量化里常见的 kernel dispatch struct Op { virtual ~Op() = default; virtual int compute(int x) const = 0; }; struct OpAdd : Op { int compute(int x) const override { return x + 1; } }; struct OpSub : Op { int compute(int x) const override { return x - 1; } }; struct OpMul : Op { int compute(int x) const override { return x * 2; } }; struct OpShl : Op { int compute(int x) const override { return x << 1; } }; // ── 准备对象数组 ──────────────────────────────────────────────── // 生成 N 个 Op* 指针, 按指定模式分配子类 enum Pattern { MONO, DUAL, MEGA }; std::vector<Op*> make_ops(Pattern p) { std::vector<Op*> ops(N); switch (p) { case MONO: // 单态: 全部同一种类型 for (int i = 0; i < N; i++) ops[i] = new OpAdd(); break; case DUAL: { // 双态: 交替 OpAdd / OpSub for (int i = 0; i < N; i++) ops[i] = (i % 2 == 0) ? (Op*)new OpAdd() : (Op*)new OpSub(); break; } case MEGA: { // 巨态: 四种类型随机混排 std::mt19937 rng(42); std::uniform_int_distribution<int> dist(0, 3); for (int i = 0; i < N; i++) { switch (dist(rng)) { case 0: ops[i] = new OpAdd(); break; case 1: ops[i] = new OpSub(); break; case 2: ops[i] = new OpMul(); break; case 3: ops[i] = new OpShl(); break; } } break; } } return ops; } void free_ops(std::vector<Op*>& ops) { for (auto p : ops) delete p; } // ── 测量工具 ──────────────────────────────────────────────────── // 每个 bench 函数都按这个模式: // 1) warmup: 跑 WARMUP 轮不计时, 让 iCache + branch predictor 进入稳态 // 2) trials: 跑 TRIALS 遍计时, 取中位数 (median), 抗噪声 // 关键原因: 第一个测的模式 iCache 是冷的、predictor 状态为空、CPU 可能尚未睿频; // 不预热直接计时, 后面的模式会"借光"前面建立好的微架构状态, 数据失真。 // 中位数比平均数更抗偶发中断/调度抖动。 double pick_median(std::vector<double>& v) { std::sort(v.begin(), v.end()); return v[v.size() / 2]; } // ── 模式1: 直接函数调用 (对照基准) ────────────────────────────── inline int direct_add(int x) { return x + 1; } double bench_direct_call() { volatile long sum = 0; // warmup for (int r = 0; r < WARMUP; r++) { for (int i = 0; i < N; i++) sum += direct_add(i); } (void)sum; // trials std::vector<double> times; for (int t = 0; t < TRIALS; t++) { volatile long s = 0; auto t0 = std::chrono::high_resolution_clock::now(); for (int r = 0; r < ROUNDS; r++) { for (int i = 0; i < N; i++) s += direct_add(i); } auto t1 = std::chrono::high_resolution_clock::now(); times.push_back(std::chrono::duration<double>(t1 - t0).count()); (void)s; } return pick_median(times); } // ── 模式2: 单态虚函数 ────────────────────────────────────────── double bench_mono_virtual() { auto ops = make_ops(MONO); volatile long sum = 0; for (int r = 0; r < WARMUP; r++) { for (int i = 0; i < N; i++) sum += ops[i]->compute(i); } (void)sum; std::vector<double> times; for (int t = 0; t < TRIALS; t++) { volatile long s = 0; auto t0 = std::chrono::high_resolution_clock::now(); for (int r = 0; r < ROUNDS; r++) { for (int i = 0; i < N; i++) s += ops[i]->compute(i); } auto t1 = std::chrono::high_resolution_clock::now(); times.push_back(std::chrono::duration<double>(t1 - t0).count()); (void)s; } free_ops(ops); return pick_median(times); } // ── 模式3: 双态虚函数 (交替) ──────────────────────────────────── double bench_dual_virtual() { auto ops = make_ops(DUAL); volatile long sum = 0; for (int r = 0; r < WARMUP; r++) { for (int i = 0; i < N; i++) sum += ops[i]->compute(i); } (void)sum; std::vector<double> times; for (int t = 0; t < TRIALS; t++) { volatile long s = 0; auto t0 = std::chrono::high_resolution_clock::now(); for (int r = 0; r < ROUNDS; r++) { for (int i = 0; i < N; i++) s += ops[i]->compute(i); } auto t1 = std::chrono::high_resolution_clock::now(); times.push_back(std::chrono::duration<double>(t1 - t0).count()); (void)s; } free_ops(ops); return pick_median(times); } // ── 模式4: 巨态虚函数 (随机混排) ──────────────────────────────── double bench_mega_virtual() { auto ops = make_ops(MEGA); volatile long sum = 0; for (int r = 0; r < WARMUP; r++) { for (int i = 0; i < N; i++) sum += ops[i]->compute(i); } (void)sum; std::vector<double> times; for (int t = 0; t < TRIALS; t++) { volatile long s = 0; auto t0 = std::chrono::high_resolution_clock::now(); for (int r = 0; r < ROUNDS; r++) { for (int i = 0; i < N; i++) s += ops[i]->compute(i); } auto t1 = std::chrono::high_resolution_clock::now(); times.push_back(std::chrono::duration<double>(t1 - t0).count()); (void)s; } free_ops(ops); return pick_median(times); } // ── 模式5: 函数指针 ───────────────────────────────────────────── double bench_funcptr(const char* label, std::vector<int(*)(int)> fptrs) { const int M = (int)fptrs.size(); volatile long sum = 0; for (int r = 0; r < WARMUP; r++) { for (int i = 0; i < N; i++) sum += fptrs[i % M](i); } (void)sum; std::vector<double> times; for (int t = 0; t < TRIALS; t++) { volatile long s = 0; auto t0 = std::chrono::high_resolution_clock::now(); for (int r = 0; r < ROUNDS; r++) { for (int i = 0; i < N; i++) s += fptrs[i % M](i); } auto t1 = std::chrono::high_resolution_clock::now(); times.push_back(std::chrono::duration<double>(t1 - t0).count()); (void)s; } (void)label; return pick_median(times); } // ── 模式6: switch 跳转表 ──────────────────────────────────────── int switch_dispatch(int op, int x) { switch (op) { case 0: return x + 1; case 1: return x - 1; case 2: return x * 2; case 3: return x << 1; case 4: return x >> 1; default: return x; } } double bench_switch_sequential() { volatile long sum = 0; for (int r = 0; r < WARMUP; r++) { for (int i = 0; i < N; i++) sum += switch_dispatch(i % 5, i); } (void)sum; std::vector<double> times; for (int t = 0; t < TRIALS; t++) { volatile long s = 0; auto t0 = std::chrono::high_resolution_clock::now(); for (int r = 0; r < ROUNDS; r++) { for (int i = 0; i < N; i++) s += switch_dispatch(i % 5, i); } auto t1 = std::chrono::high_resolution_clock::now(); times.push_back(std::chrono::duration<double>(t1 - t0).count()); (void)s; } return pick_median(times); } double bench_switch_random() { std::mt19937 rng(42); std::uniform_int_distribution<int> dist(0, 4); volatile long sum = 0; for (int r = 0; r < WARMUP; r++) { for (int i = 0; i < N; i++) sum += switch_dispatch(dist(rng), i); } (void)sum; std::vector<double> times; for (int t = 0; t < TRIALS; t++) { volatile long s = 0; auto t0 = std::chrono::high_resolution_clock::now(); for (int r = 0; r < ROUNDS; r++) { for (int i = 0; i < N; i++) s += switch_dispatch(dist(rng), i); } auto t1 = std::chrono::high_resolution_clock::now(); times.push_back(std::chrono::duration<double>(t1 - t0).count()); (void)s; } return pick_median(times); } // ── 运行所有模式(默认行为)───────────────────────────────────── void run_all() { std::cout << "\n╔══════════════════════════════════════════════════════════╗\n" << "║ 间接分支预测实验 (Indirect Branch Prediction) ║\n" << "║ 对象 N=" << N << ", 每轮 " << ROUNDS << " 遍 ║\n" << "║ 焦点: branch-loads / branch-load-misses ║\n" << "╚══════════════════════════════════════════════════════════╝\n\n"; auto print_row = [](const char* name, double t, double baseline) { std::cout << std::left << std::setprecision(2) << std::setw(30) << name << std::setw(14) << (t * 1e3) << std::setw(12) << (t / baseline * 100.0) << "%\n"; }; // ── 虚函数部分 ──────────────────────────────────────────── std::cout << "── 虚函数调用 (vtable dispatch) ──\n\n" << " 正在测量... \n"; double t_direct = bench_direct_call(); double t_mono = bench_mono_virtual(); double t_dual = bench_dual_virtual(); double t_mega = bench_mega_virtual(); std::cout << std::left << std::fixed << std::setw(30) << "模式" << std::setw(14) << "耗时(ms)" << std::setw(14) << "相对(%)\n" << std::string(58, '-') << '\n'; double baseline = t_direct; print_row("直接调用 (direct call)", t_direct, baseline); print_row("单态虚函数 (monomorphic)", t_mono, baseline); print_row("双态虚函数 (bimorphic)", t_dual, baseline); print_row("巨态虚函数 (megamorphic)", t_mega, baseline); std::cout << "\n ── 观察要点 ──\n\n" << " ▸ 直接调用: call 目标地址编码在指令里, 无间接分支\n" << " ▸ 单态虚函数: 通过 vtable 间接跳转 (call *%rax),\n" << " 但每次目标相同 → indirect predictor 学会后几乎零开销\n" << " ▸ 双态虚函数: 两个目标交替 → predictor 能学交替模式,\n" << " 比单态稍慢但接近\n" << " ▸ 巨态虚函数: 四个目标随机 → predictor 无法学习,\n" << " 每次 ~50%+ 概率猜错, 显著变慢\n\n"; // ── 函数指针部分 ────────────────────────────────────────── std::cout << "── 函数指针调用 ──\n\n" << " 正在测量... \n"; std::vector<int(*)(int)> mono_fptrs = { direct_add }; std::vector<int(*)(int)> mega_fptrs = { [](int x) -> int { return x + 1; }, [](int x) -> int { return x - 1; }, [](int x) -> int { return x * 2; }, [](int x) -> int { return x << 1; }, }; double t_fp_single = bench_funcptr("单目标函数指针", mono_fptrs); double t_fp_multi = bench_funcptr("多目标函数指针", mega_fptrs); std::cout << std::left << std::fixed << std::setw(30) << "模式" << std::setw(14) << "耗时(ms)" << std::setw(14) << "相对(单目标%)\n" << std::string(58, '-') << '\n'; print_row("函数指针(单一目标)", t_fp_single, t_fp_single); print_row("函数指针(四目标轮转)", t_fp_multi, t_fp_single); std::cout << "\n ── 观察要点 ──\n\n" << " ▸ 函数指针 = 间接 call, 和虚函数本质一样\n" << " ▸ 单一目标: predictor 学会, 接近直接调用\n" << " ▸ 多目标: 取决于目标地址在间接分支预测器中的别名冲突\n\n"; // ── switch 跳转表部分 ───────────────────────────────────── std::cout << "── switch 跳转表 ──\n\n" << " 正在测量... \n"; double t_sw_seq = bench_switch_sequential(); double t_sw_rnd = bench_switch_random(); std::cout << std::left << std::fixed << std::setw(30) << "模式" << std::setw(14) << "耗时(ms)" << std::setw(14) << "相对(%)\n" << std::string(58, '-') << '\n'; print_row("switch(顺序 op)", t_sw_seq, t_sw_seq); print_row("switch(随机 op)", t_sw_rnd, t_sw_seq); std::cout << "\n ── 观察要点 ──\n\n" << " ▸ switch 密集连续值 → 编译成跳转表 (jmp *disp(,%rax,8))\n" << " 本质是间接分支, 也受 indirect predictor 影响\n" << " ▸ 顺序 op: predictor 可能学到大步进模式\n" << " ▸ 随机 op: 预测失败率上升, 变慢\n\n"; // ── perf 建议命令 ────────────────────────────────────────── std::cout << "── perf 建议命令 ──\n\n" << " # 用 --mode 单独跑一个模式, 避免各种模式混在一起:\n" << " perf stat -e branch-loads,branch-load-misses \\\n" << " ./indirect_branch --mode mono\n\n" << " perf stat -e branch-loads,branch-load-misses \\\n" << " ./indirect_branch --mode mega\n\n" << " # perf record 定位具体函数 (同样建议 --mode 隔离):\n" << " perf record -e branch-load-misses:pp -g \\\n" << " ./indirect_branch --mode mega\n" << " perf report --stdio\n" << " # 进入热点函数后: perf annotate\n\n" << " # 预期结果:\n" << " # 单态虚函数 → branch-load-misses 很低\n" << " # 巨态虚函数 → branch-load-misses 显著升高\n" << " # 巨态间接分支预测失败比条件分支 (jcc) 更难优化\n\n" << " 核心结论: 间接分支 (虚函数/函数指针/switch 跳转表)\n" << " 不仅要猜方向, 还要猜目标地址, 比条件分支更难预测。\n" << " 单态/少态 → predictor 学会, 几乎零开销;\n" << " 巨态/随机 → predictor 抓瞎, 考虑去虚化或分支打散。\n"; } // ── main ──────────────────────────────────────────────────────── int main(int argc, char** argv) { const char* mode = "all"; for (int i = 1; i < argc; i++) { if (strcmp(argv[i], "--mode") == 0 && i + 1 < argc) mode = argv[++i]; else if (strcmp(argv[i], "-m") == 0 && i + 1 < argc) mode = argv[++i]; } if (strcmp(mode, "direct") == 0) { bench_direct_call(); return 0; } if (strcmp(mode, "mono") == 0) { bench_mono_virtual(); return 0; } if (strcmp(mode, "dual") == 0) { bench_dual_virtual(); return 0; } if (strcmp(mode, "mega") == 0) { bench_mega_virtual(); return 0; } if (strcmp(mode, "fptr-single") == 0) { std::vector<int(*)(int)> mono_fptrs = { direct_add }; bench_funcptr("单目标函数指针", mono_fptrs); return 0; } if (strcmp(mode, "fptr-multi") == 0) { std::vector<int(*)(int)> mega_fptrs = { [](int x) -> int { return x + 1; }, [](int x) -> int { return x - 1; }, [](int x) -> int { return x * 2; }, [](int x) -> int { return x << 1; }, }; bench_funcptr("多目标函数指针", mega_fptrs); return 0; } if (strcmp(mode, "switch-seq") == 0) { bench_switch_sequential(); return 0; } if (strcmp(mode, "switch-rnd") == 0) { bench_switch_random(); return 0; } if (strcmp(mode, "all") != 0) { std::cerr << "未知模式: " << mode << "\n" << "用法: ./indirect_branch [--mode <模式>]\n" << " 模式: direct | mono | dual | mega |\n" << " fptr-single | fptr-multi | switch-seq | switch-rnd | all\n"; return 1; } run_all(); return 0; }
九、和本仓库其他文档的关系
- 前置:branch-prediction——直接分支预测(jcc 方向预测),BTB/BHT/TAGE/两位计数器的基础概念,流水线 flush 机制。本篇是它的间接分支专题深入。
- 同层微架构:cpu-out-of-order——乱序执行 + 投机执行机制;rob——ROB 清空时的具体行为;uop-pipeline-walkthrough——µop 级流水线走读。
- 观测:perf——
branch-loads/branch-load-misses等 PMU 事件详解。 - 实验:indirect-branch demo——六种场景可跑对比。
十、一句话总结
间接分支(
call *%rax/jmp *%rax)比直接分支(jcc)多一个维度——不仅要猜"跳不跳",还要猜一个任意的目标地址。单态/少态时间接分支预测器(ITTAGE)学会目标后几乎零开销(日常 OOP 虚函数就是这样,不用谈虚函数色变);巨态(四个以上目标随机)时预测器完全抓瞎,误判率 50%+,还连累 I-cache 和 iTLB 一起 miss,惩罚比直接分支误预测更重(20~30 拍 vs 15~20 拍)。优化手段是去虚化(final / CRTP / PGO / variant),但前提是先用perf stat -e branch-loads,branch-load-misses确认瓶颈确实在这里。Spectre v2 专门攻击间接分支预测器,retpoline 的缓解方案正是用 RSB(返回栈)替代 ITTAGE——侧面印证了"间接分支预测是个更难的问题"。