vmstat —— 整机 CPU / 内存 / IO / 上下文切换 一屏概览
这个工具是做什么的
vmstat(virtual memory statistics)是排查的"第一眼"工具:用一行数字同时覆盖 CPU、内存、swap、块 IO、中断/上下文切换,帮你在 5 秒内判断瓶颈的大方向(CPU?内存?IO?调度?),再决定用哪个专项工具深入。
可以回答什么问题
| 问题 | 判据 |
|---|---|
| CPU 过载了吗?任务在排队等 CPU? | r 列:持续 > CPU 核数 = 过载 |
| 有任务卡在磁盘 IO 上? | b 列:持续 >0 = IO 拖累 |
| 内存够不够?有没有在 swap? | si/so 列:持续非 0 = 内存不足的铁证 |
| 磁盘读写量大不大? | bi/bo 列:块设备 IO 速率 |
| 上下文切换多不多? | cs 列:异常高 = 线程过多/锁竞争 |
| 中断量大不大? | in 列:网络繁忙时高 |
| CPU 瓶颈在哪一类? | us/sy/wa/id 列 |
数据来源
- 来源文件:CPU/中断/上下文切换/运行队列取自
/proc/stat;内存与 swap 取自/proc/meminfo;换页(si/so)、缺页取自/proc/vmstat;块 IO(bi/bo)取自/proc/diskstats。 - 采集方式:按间隔读这些文件并做差,把多类指标压缩成一行输出。
- 由此决定的特性:输出的第一行是开机以来的累计平均,没有实时意义,直接忽略,从第二行起才是每个间隔的真实增量——这是 vmstat 最常见的读图误区。
vmstat 1                 # 每 1 秒刷新(最常用)
vmstat 1 10              # 每秒一次,共 10 次
vmstat -w 1              # 宽格式,列对齐更好读(推荐)
vmstat -S M 1            # 内存单位用 MB(默认 KB)
vmstat -a 1              # memory 区显示 active/inactive 而非 buff/cache
vmstat -t 1              # 每行加时间戳
⚠️ 第一行永远是开机以来的平均值,不代表当下,忽略它;从第二行起才是每个间隔的实时增量。
一、输出样例
procs -----------memory---------- ---swap-- -----io---- -system-- ------cpu-----
 r  b   swpd   free   buff  cache   si   so    bi    bo   in   cs us sy id wa st
 2  0      0 1048576  20480 800000    0    0     5    12  200  450 10  3 86  1  0
 1  0      0 1047000  20480 800100    0    0     0  1024  310 1200 15 25 59  1  0
二、字段分组详解
procs(进程队列——判断 CPU/IO 压力)
| 字段 | 含义 | 判读 |
|---|---|---|
r | 可运行 + 正在运行的进程数(等 CPU 的队列长度) | 持续 > CPU 核数 = CPU 不够,任务在排队 |
b | 处于不可中断睡眠(D 状态)的进程数 | 通常是卡在磁盘/网络 IO;持续 >0 = IO 拖累 |
memory(内存,默认 KB)
| 字段 | 含义 | 判读 |
|---|---|---|
swpd | 已用 swap 大小(KB) | 持续增长 = 内存吃紧被迫换出;稳定不涨 = 历史遗留的换出页,新压力不大 |
| free | 完全空闲内存(KB) | 看着小不一定真紧,要看 si/so 和 free -h 的 available |
buff | 块设备缓冲(KB):裸盘元数据、块设备层缓冲 | 在现代 Linux 上几乎为 0(KB 量级),因为块设备缓冲已被并入 page cache,单独存在的只有裸块设备访问(如 dd 直写裸盘) |
cache | 页缓存(KB):文件内容缓存 | 可回收——内存吃紧时内核直接 drop,进程要用时再从磁盘读,不算真占用 |
⚠️ 单位陷阱:vmstat 的
memory列默认是 KB。swpd=5896是 5.7MB,不是 5.7GB。看到 6 位数的 free 时先除以 1048576 换算成 GB。推荐用vmstat -w -S M 1一眼看清。
memory 四列的实操解读(看 swpd / free / buff / cache 四个数到底在说什么)
这四列常被误读,本节用真实场景拆解。核心口诀:swpd 看压力、free 看余量、buff 看裸盘、cache 看闲置利用。
四列的本质是什么
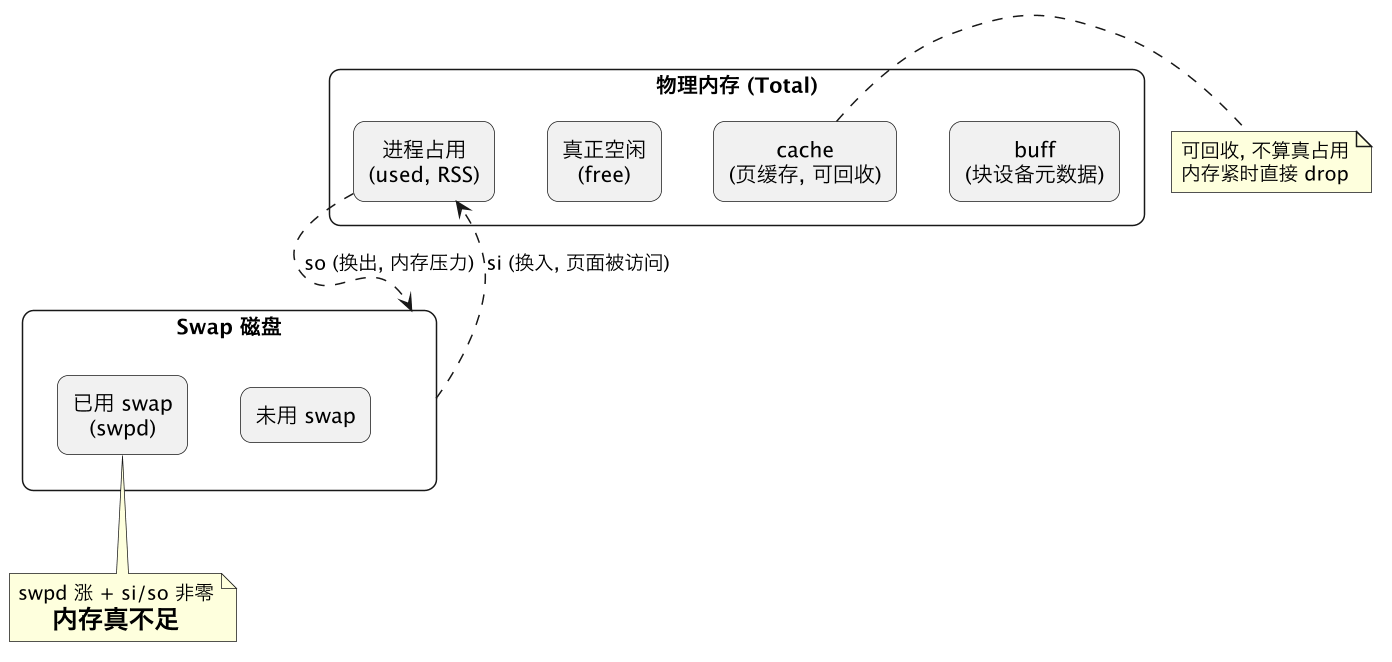
逐列详解
1. swpd(已用 swap,KB)—— 看的是"换出压力"
- 不是"当前正在换出"——它是累计已换出的总量快照。
swpd = 0:系统从未/从未需要 swap,是健康的标志。swpd > 0 但稳定**不涨**:历史上换出过一些冷页(开机加载大量数据/某个大进程退出后的余波),但当前没有新压力。swpd 持续增长**:内存真吃紧,内核持续把冷页换出。**配合so > 0` 看更准**。- 内存换出后再被访问需要从磁盘读回(
si > 0),代价极大——1000x 内存访问的延迟。
2. free(完全空闲,KB)—— 看的是"未分配的余量"
- 是
free -h那行 free 列的同名同义,但 vmstat 不显示available。 - free 很小不等于内存不足——空闲内存被内核拿去做
cache是常态。 - 真正可用内存要算
free + 可回收 cache,这正是free -h的available字段。 - vmstat 看不到
available是个坑,所以单看vmstat 1没法判定内存紧不紧,必须配合free -h。
3. buff(块设备缓冲,KB)—— 看的是"裸盘元数据"
- 主要是裸块设备(
/dev/sda1这种直接访问)的元数据缓冲。 - 在普通文件 IO 场景下几乎为 0(截图里始终 20 KB 正是如此),因为文件 IO 的缓冲都走 page cache 了。
- 真正能让
buff涨起来的情况:直接对裸块设备读写(dd if=/dev/zero of=/dev/sdb bs=1M)、ext4 日志、文件系统元数据(inode、superblock)。 - 如果
buff异常高(GB 级)→ 可能有进程在直写裸盘,看 iotop 找进程。
4. cache(页缓存,KB)—— 看的是"内核把空闲内存用到哪了"
- 文件内容缓存:读文件、mmap 文件、dd 读盘、tar 拷贝等都会让 cache 涨。
- 本质是空闲内存的"再投资"——内存闲着也是闲着,不如缓存住热数据,下次访问直接从内存读(μs 级)替代磁盘(ms 级)。
- 内存紧时由
kswapd自动 drop,free 涨、进程无感。 - Cache 突降是正常行为:截图 14:19 时刻
cache从 7.1 GB 缓慢降到 7.5 GB 再升到 7.0 GB——不是"丢了",是kswapd在后台默默回收冷页、留给新的热数据。si/so保持 0 → 这不是内存压力,是正常轮转。
典型场景速查表
| 场景 | swpd | free | buff | cache | si/so | 含义 |
|---|---|---|---|---|---|---|
| 内存充足、刚启动读了一些文件 | 0 | 中等 | 小 | 持续上涨 | 0 | 空闲内存被积极利用做缓存,健康 |
| 截图场景(持续观测中段) | 稳定 5896 KB | 很大(485 GB) | 几乎 0 | 7 GB 上下波动 | 几乎 0 | 健康:少量历史换出 + cache 主动轮转 + 内存非常宽裕 |
cache 持续降、free 涨 | 0 | 涨 | 小 | 降 | 0 | kswapd 在清理冷页、内存宽裕,正常 |
cache 降、si/so 升、swpd 涨 | 涨 | 跌 | 小 | 降 | >0 | 真内存不足——冷页被换出到磁盘 |
buff 突然涨到 GB 级 | 0 | 跌 | 涨 | 小 | 0 | 有进程在直写裸盘(dd、日志回写),用 iotop 定位 |
free 持续降低、cache 同步降、swpd 涨 | 涨 | 跌 | 小 | 降 | >0 | 双重压力:用户态和内核态都在抢内存,真问题 |
解读流程(5 秒判断)
vmstat 1 看到 4 列数字
  → swpd 涨? si/so 非 0?
    → 是 → 内存真不足 → free -h 看 available → 找吃内存进程
  → swpd 不涨, si/so = 0?
    → 是 → swpd 是历史换出残量, 不是当前问题
      → free 仍很大 + cache 在变 → 内核在做缓存轮转, 健康
      → free 持续降 + cache 持续降 + swpd 涨 → 预警
swap(换页——判断内存是否真的不足)
| 字段 | 含义 |
|---|---|
si | 每秒从磁盘换入内存 KB(swap in) |
so | 每秒从内存换出到磁盘 KB(swap out) |
si/so持续非 0 是内存不足的铁证——系统在拿磁盘当内存用,性能会断崖式下跌。偶尔跳一下(如刚启动大程序)可忽略,持续非 0 要处理。
💡
swpd涨 vssi/so非零是两件事:swpd 是"已换出量的累计值"(涨过之后可能保持不变),si/so是"换页活动速率"(每秒换出/换入多少)。只有两者同时持续变化才说明当前有换页压力。swpd高但si/so = 0:历史换出残量,不代表当前有问题。
io(块设备 IO)
| 字段 | 含义 |
|---|---|
bi | 每秒从块设备读入的块数(blocks in) |
bo | 每秒写入块设备的块数(blocks out) |
bo持续很高 +wa高 +b大 → 写盘瓶颈,转iostat -x/iotop。
system(中断与切换)
| 字段 | 含义 | 判读 |
|---|---|---|
in | 每秒中断数(interrupts) | 网卡/时钟/磁盘中断,网络繁忙时高 |
cs | 每秒上下文切换数(context switches) | 异常高 = 线程过多/锁竞争/频繁 IO 阻塞;配合 pidstat -w 定位进程 |
cpu(百分比,同 top)
| 字段 | 含义 |
|---|---|
us | 用户态 |
三、快速判断口诀
| 现象 | 结论 | 下一步 |
|---|---|---|
r 长、us/sy 高、id 低 | CPU 瓶颈 | top -H → pidstat -u → perf |
wa 高、b 大、bi/bo 大 | IO 瓶颈 | iostat -x → iotop |
si/so 持续非 0、swpd 涨 | 内存不足 | free -h、ps --sort=-%mem 找吃内存进程 |
swpd > 0 但稳定、si/so=0` | 历史换出残量(当前无压力) | 没事,不处理 | | ||
cs/in 异常高、us不高 | 上下文切换/中断风暴 | pidstat -w、mpstat -P ALL 看 %soft |
sy 高、us 不高 | 内核态开销大 | strace -c 看 syscall、perf 看内核栈 |
四、附加用法
vmstat -s                # 内存与事件的总量统计(自开机累计,一次性快照)
vmstat -d                # 各磁盘设备的读写次数/扇区累计
vmstat -m                # 内核 slab 分配情况(内核对象内存)
五、常见排查方法与分析
5.1 CPU 过载 — r 持续高于 CPU 核数
vmstat 1 → 确认 r > CPU核数 且 us+sy 高
  → top -H → 找高 CPU 进程/线程
    → pidstat -ut 1 → 确认是哪个 TID 在烧
      → perf top -t <TID> → 定位热点函数
5.2 IO 瓶颈 — wa 高 + b 大 + bi/bo 大
vmstat 1 → 确认 wa > 20% 且 b > 0
  → iostat -x 1 → 确认哪块盘的 await 高
    → iotop -o → 找读写进程
      → strace -e trace=read,write,fsync -p <PID> → 看操作
5.3 内存不足 — si/so 持续非零
vmstat 1 → 确认 si/so > 0 持续
  → free -h → 确认 available 是否接近 0
    → ps aux --sort=-%mem | head → 找吃内存大户
      → pidstat -r -p <PID> 1 → 看 majflt/s 是否 > 0
        → dmesg | grep -i oom → 是否已触发过 OOM
5.4 上下文切换风暴 — cs 异常高 + us 不高
vmstat 1 → 确认 cs 数万/秒
  → pidstat -w 1 → 找 cswch 或 nvcswch 最高的进程
    → cswch 高 → strace -c -p <PID> 看哪个 syscall 被频繁调
    → nvcswch 高 → 线程数过多或调度策略异常
5.5 中断风暴 — in 骤增
vmstat 1 → 确认 in 骤增(如从几百到几万)
  → mpstat -P ALL 1 → 看 %irq/%soft 集中在哪些核
    → cat /proc/interrupts → 确认中断来源设备
5.6 内核态开销大 — sy 高、us 不高
vmstat 1 → 确认 sy > 30% 且 us 正常
  → pidstat -u 1 → 找 %system 高的进程
    → strace -c -p <PID> → 定位高频 syscall
      → perf record -g -p <PID> → 看内核栈热点
5.7 memory 四列的解读示例(以截图为例)
截图中
swpd=5896、free≈50.8 GB、buff=20、cache≈7.1 MB、si/so=0,内存单位是 KB,实际为swpd=5.7MB、free=485GB、cache=6.8GB。
| 列 | 截图值 | 换算 | 解读 |
|---|---|---|---|
swpd | 5896 | 5.7 MB | 历史上换出过 ~6MB 冷页,开机后一直保持不变,当前没有新换出压力 |
| free | 50882092 | ~485 GB | 巨量空闲(系统总内存 512GB+),几乎裸机状态 |
buff | 20 | 20 KB | 几乎为 0,没有裸块设备访问场景,正常 |
cache | 7147528 | ~6.8 GB | 大量文件内容被缓存(之前读过的大文件/mmap),可回收,不算真占用 |
si/so | 0/0 | — | 当前没有换页活动——swpd 的 5.7MB 是历史残留,不代表当前内存吃紧 |
bi/bo | 0/0 | — | 块 IO 极轻,磁盘不是瓶颈 |
结论:该机器内存非常宽裕。swpd 是个常见的"看起来吓人但其实没事"的指标——很多老系统开机加载大数据库/大文件后,swpd 会留点残量再也不涨。只有 swpd 持续增长配合 si/so 非零才是真信号。
六、交叉引用
- CPU 逐核:mpstat(看单核是否成瓶颈)
- 进程级 CPU:pidstat(定位哪个进程 us/sy 高)
- 上下文切换:scheduling-observation(cs 高时的深度分析)
- 内存详细:free(si/so 非零时进一步确认)
- 磁盘 IO:iostat(wa 高、b 大时的下一步)
- 函数热点:perf(CPU 瓶颈时深入)
- 数据源:procfs §三(/proc/stat、meminfo、diskstats)
七、和其他工具的关系
vmstat 是"分诊台":定了大方向后——
总结
vmstat 是系统瓶颈的「分诊台」:vmstat 1 每秒一行,r/b 看运行和不可中断等待队列(r>核数=CPU 不够、b 持续非零=IO 堆积),us/sy/wa/id 分用户/系统/IO 等待/空闲,si/so 非零才是真换页(内存不足),bi/bo 看块 IO,cs/in 看上下文切换和中断速率;它定大方向但不下钻——CPU 高转 mpstat/top/pidstat/perf,内存转 free/pidstat -r,IO 转 iostat/iotop,切换高转 pidstat -w。记住 swpd 残留不等于内存吃紧,要 si/so 非零才是真信号。