Store Buffer —— 为什么写不能"等",以及等出来的内存乱序
上一篇 msi 场景3 留了个尾巴:核要写一条被别人共享的行时,必须先发失效、等所有
Inv-Ack回来才能动笔。这一等就是几十上百拍。Store buffer(写缓冲)就是为了让 CPU 不必干等而生的——但它也把"写立即对外可见"这条直觉打破了,直接催生了内存屏障和整个内存序(memory ordering)话题。
本篇详细论述:store buffer 解决什么问题、怎么设计、引入了什么新问题、怎么用屏障补救,以及它对称的兄弟 invalidate queue。前置知识是 msi 的一致性握手和 mesi-protocol 的状态机;下游话题是 atomic 的内存屏障。
一、问题起点:一次写要 CPU 干等几百拍
先把 msi 场景3 的代价量化。CPU 执行一条 store(写内存)时,如果这条 cache line:
- 不在本核缓存,或
- 在本核但状态是 S(别的核也持有),
硬件都不能就地写——必须先取得独占:发 RFO(Read For Ownership) / BusUpgr,让其他核把副本失效,等它们全部回 Inv-Ack,本核把行升到 M(Modified),才能真正改。
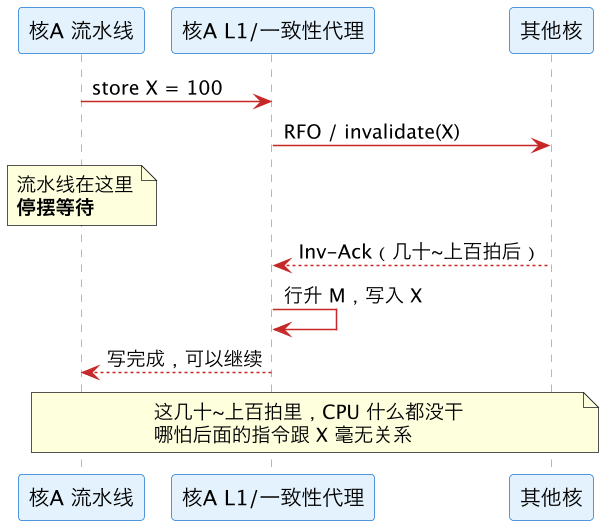
为什么这一圈 Inv-Ack 要几十~上百拍? 因为它不是一次本地缓存访问,而是一次"跨核往返 + 逐级下探":请求要离开核心时钟域进入较慢的 uncore、查 LLC 目录确认谁持有、沿 ring/mesh 逐跳路由到对端核、等最慢的持有者置无效,再原路把 Ack 送回、跨域同步回核心域。对比 L1 命中只要 ~4~5 拍,这一圈直接跳到几十~上百拍——贵就贵在"离开了本核"。逐跳耗在哪个时钟域、每段大约几拍的完整拆解,见 缓存组织·访问流程篇"缓存访问的时钟域与开销"。
这一笔几十上百拍的跨核往返,正是 store buffer 值得存在的理由:把它从关键路径上藏到后台。
关键矛盾:写本身在 CPU 眼里是"发出去就完事"的动作(不像读,读要等数据回来才能算下一步)。可一致性协议逼着写也得同步等 ACK。于是——
每一次"写未命中/写共享行",都让整条流水线为一次跨核往返停摆。而写在真实程序里极其密集(初始化、压栈、
counter++、结构体赋值……),若条条都等,CPU 大部分时间在发呆。 这就是 store buffer 要解决的问题。
二、核心思路:写先入队,CPU 立刻往下跑
Store buffer 是介于 CPU 流水线和 L1 之间的一个小队列(FIFO)。它的设计只有一句话:把写"记下来"就放行,别让流水线等一致性握手。
三步拆开看:
- 入队即放行:CPU 执行 store,把
(地址, 值)写进 store buffer 就算这条指令"做完了",流水线立刻执行下一条。一致性握手(RFO/等 ACK)由 store buffer 在后台慢慢做。 - 后台提交(drain):store buffer 里的条目在拿到该行的独占(M)后,才真正写入 L1、对其他核可见。这个"排空"过程和 CPU 前台执行并行。
- store forwarding(关键补丁):本核后续的 load 如果读的正是 store buffer 里还没提交的地址,必须直接从 store buffer 拿,不能去读 L1(L1 里还是旧值)。否则"我刚写的值自己都读不到",单线程语义就崩了。
Store buffer 的本质是把"写的发起"和"写的完成(全局可见)"这两件事在时间上分开:发起是即时的,完成是异步的。CPU 靠这个把一致性延迟藏到后台,换来流水线不停摆。收益立竿见影,但代价就藏在"分开"这两个字里——见第四节。
三、为什么读不需要 store buffer 这种东西?
对比一下就懂 store buffer 为何是"写专属"优化:
| 读 load | 写 store | |
|---|---|---|
| 后续指令依赖它吗 | 依赖——要用读到的值算下一步,天然得等数据回来 | 常常不依赖——写出去后,本条指令的使命就完了 |
| 能不能"发了就不管" | 不能(等值回来) | 能(值已定,剩下的是通知别人) |
| 藏延迟的手段 | 乱序执行、预取(prefetch)、非阻塞 cache | store buffer(本篇主角) |
所以:读的延迟靠"提前发起 + 乱序重叠"来藏,写的延迟靠"发起后入队、异步完成"来藏。 store buffer 正是抓住了"写的结果不影响本条指令后续"这一点,才能安全地让写"离开流水线"。
四、代价:store buffer 制造了内存乱序
这是本篇最重要的一节。Store buffer 让写延迟对其他核可见,于是同一个核发出的"写"和"读",在别的核看来顺序可能被打乱。x86 允许的唯一一种重排——StoreLoad 重排(写后读被提前)——根源就是 store buffer。
4.1 单核视角没事,多核视角出事
- 单核自洽:靠 store forwarding,本核 load 总能看到本核 store buffer 里最新的写,所以单线程程序察觉不到 store buffer 的存在,语义完全正常。
- 多核穿帮:核A 的 store 还躺在自己的 store buffer 里没提交时,核B 是看不到的——store forwarding 只对本核有效,别的核没法窥探你的 store buffer。于是核A 觉得"我明明先写了 X 再读的 Y",核B 却看到"X 好像还没写"。
4.2 经典翻车案例:两个标志位
这是几乎所有内存模型教材的入门例子(Dekker 算法的核心片段)。初始 x = y = 0,两个核各跑一段:
// 核 0                     // 核 1
x = 1;                      y = 1;
r0 = y; r1 = x;直觉:不可能 r0 == 0 && r1 == 0——总得有一个核先写完吧?但有了 store buffer,这个"不可能"真的会发生:
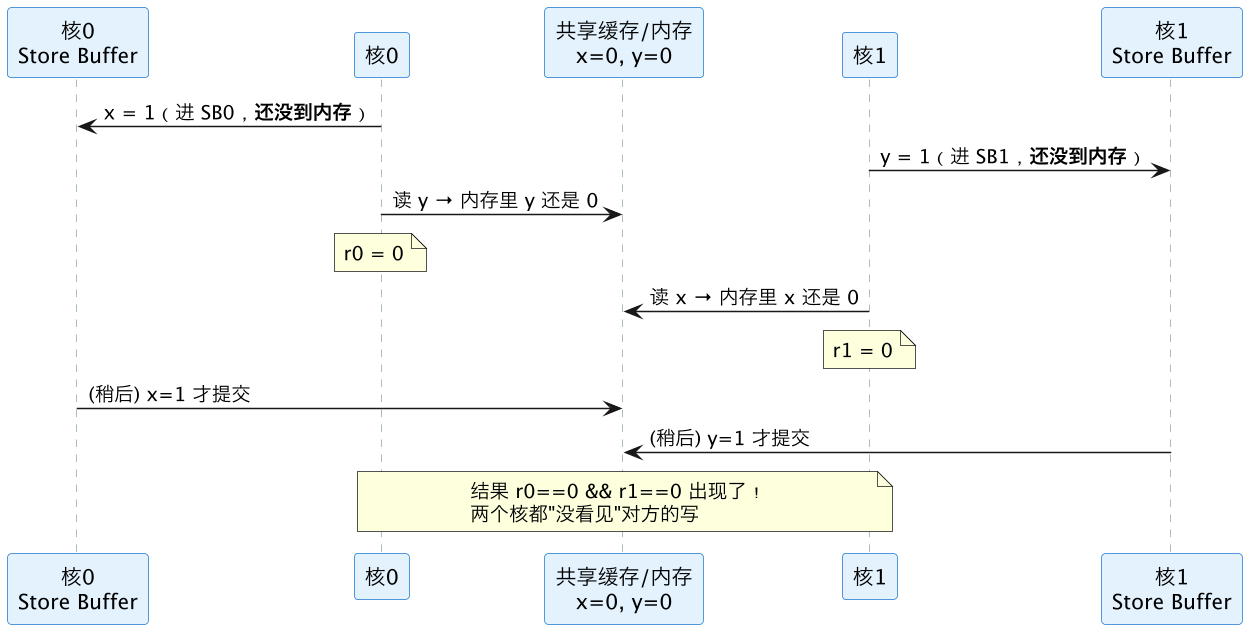
为什么:x=1 和 y=1 都还压在各自的 store buffer 里没提交,两个核的读却已经打到了共享内存/缓存的旧值。站在别的核看,"写 x" 被推迟到了"读 y"之后——写和读的顺序被 store buffer 颠倒了。这就是 StoreLoad 重排。
注意:这不是编译器乱序(编译器一行没动),是硬件层的写延迟可见造成的。即使你关掉编译器优化,store buffer 依旧会让它发生。
4.3 x86-TSO:store buffer 决定了 x86 的内存模型
x86 的内存模型叫 TSO(Total Store Order,全序写),它其实就是"有 store buffer,但 store buffer 是 FIFO、且不做投机乱序"这一硬件事实的抽象描述。关键结论只有一句:store buffer 是 FIFO → x86 只放行 StoreLoad 一种硬件重排(写压在 buffer 里没提交、后面的读先执行;而 FIFO 提交挡住了 StoreStore,读不被暴露地投机重排挡住了 LoadLoad/LoadStore)。
而 ARM/Power 是弱内存模型:它们的 store buffer 不保证 FIFO 提交、读也可投机重排,四种重排几乎都允许,需要程序员更频繁地加屏障。
一句话:x86 只有 StoreLoad 一种硬件重排,且它 100% 来自 store buffer。理解了 store buffer,就理解了 x86 内存模型的全部"怪脾气"。
四种重排(LoadLoad/LoadStore/StoreStore/StoreLoad)各在 x86/ARM 允许还是禁止的完整 permit 表、成因归属、跨架构差异、屏障如何逐一封堵,见导读 memory-reordering 第三节——本篇是其中 StoreLoad/StoreStore 那两格的成因展开。
4.4 写重排只是三层重排之一
写重排(store buffer 造成的 StoreLoad)只是"重排"这个大话题里的一层。编译器重排、CPU 乱序执行、内存重排三者的完整区分(谁干的、发生在编译期还是运行期、"编译器屏障 ≠ 内存屏障"为什么最常搞错),见导读 reordering-overview。本篇聚焦其中 store buffer 造成的 StoreLoad。
五、补救:内存屏障强制排空 store buffer
既然乱序来自"store 还压在 buffer 里没提交就去读",那修复手段自然是:在关键点强制把 store buffer 排空(drain),等它全部提交、全局可见了,再往下走。 这就是内存屏障(memory fence) 干的事之一。
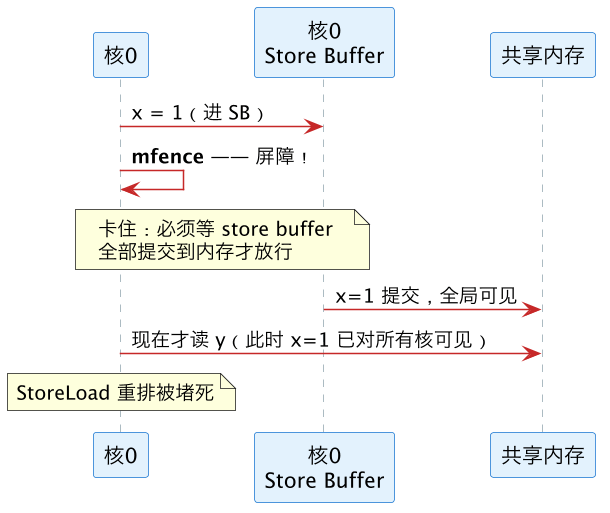
对应到指令:治 StoreLoad 的关键,就是强制排空 store buffer这一个动作,x86 上由两条途径提供:
| 层面 | 手段 | 效果 |
|---|---|---|
| x86 指令 | mfence | 全屏障:排空 store buffer,禁止 StoreLoad 越过 |
| x86 指令 | lock 前缀(lock add/xchg 等) | 自带全屏障——所以原子操作在 x86 上"顺带"修好了内存序,见 atomic 第四节 |
- 回到 4.2 的例子:在两段代码的
store和load之间各插一个mfence(或把变量设成std::atomic默认序),x=1会先被强制提交,r0==0 && r1==0就不可能了。 - 代价:屏障 = 主动放弃 store buffer 的收益,让 CPU 在这点上真的去等。所以屏障不是免费的,滥用
seq_cst会把 store buffer 省下的时间又赔回去——这正是memory_order_relaxed/release-acquire存在的意义:只在需要的地方、用最弱够用的屏障。
C++ 里
seq_cst/release/acquire/relaxed各档到底"禁哪几种重排"、为什么只有seq_cst/全屏障能压住 StoreLoad,见导读 memory-reordering 第五节的屏障→重排映射表。本节只讲 store buffer 这一侧:屏障强制排空它,StoreLoad 就没了。
设计哲学:硬件默认"快而弱"(store buffer 全程异步、允许 StoreLoad),把"什么时候必须强一致"的决定权交给软件用屏障显式表达。快是默认,慢是你主动买的。
六、对称的兄弟:Invalidate Queue(失效队列)
Store buffer 优化了写的发起方。但一致性握手还有另一端也慢:收到 invalidate 的核,要真去 L1 里把那条行置无效也要花时间;若它让请求方等这个失效真正做完才回 Ack,写方又被拖慢了。于是硬件在接收侧做了对称优化——invalidate queue:收到失效先入队、立刻回 Ack,稍后再真置无效。它的后果、读屏障、以及 x86 为何感觉不到它,与 store buffer 完全对称。
完整论述(含 producer/consumer 翻车、读屏障(acquire)、SB-vs-IQ 对称对照表、x86 为何感觉不到)见独立篇 invalidate-queue。
七、串起来:store buffer 在 MESI 握手里的位置
store buffer 和 invalidate queue 正是让 msi 场景3 那次"失效-确认握手"不阻塞流水线的两个缓冲——一个在发起侧、一个在接收侧。把它们放进同一张握手图,能看清"X 的写入"与"对 B 真正失效"之间那段双向乱序窗口是怎么来的。这张两缓冲会合图是两篇文档的会合点,画在 invalidate-queue 第七节,不在此重复。
一句话图景:MESI 保证"最终一致",store buffer + invalidate queue 保证"不为一致性干等",内存屏障保证"需要时能拿回强一致"。三者分工明确——协议管正确性的下限,两个缓冲管性能,屏障管按需拔高一致性。
八、和本仓库其他文档的关系
- 上游:msi(一致性握手为什么慢、
Inv-Ack从哪来)、mesi-protocol(M/E/S/I 状态机)、mesi-false-sharing(伪共享)。 - 微架构视角:data-hazards——store→load forwarding 是数据冒险中 RAW 的关键解法,SB 地址比对与 L1 访问的 1 拍并发机制。
- 纵切面走读:uop-pipeline-walkthrough——Store Buffer 槽位生命周期序列图(分配→填充→退休→仲裁→提交),以及 SB/LB/LSU 三者层级关系。
- 下游:atomic(
lock前缀自带全屏障、std::memory_order选择)——原子操作的"内存序"部分,底层机制就是本篇的 store buffer + invalidate queue + 屏障。 - 性能观测:store buffer 满(写密集且频繁失效)会造成流水线停顿;屏障过多会拉长关键路径。可用 perf 看:
# 写密集 + 跨核失效时,观察停顿与一致性流量
perf stat -e cycles,instructions,mem_inst_retired.all_stores,machine_clears.memory_ordering ./app
# machine_clears.memory_ordering:内存序违规导致的流水线清空(常与 store buffer/乱序相关,事件名因型号而异)
perf list | grep -i "mem_\|machine_clears\|fence"
九、一句话总结
写不能就地完成(要等一致性 ACK),于是 CPU 用 store buffer 让写"入队即放行、后台异步提交",把跨核延迟藏起来——代价是写延迟对别人可见,产生 StoreLoad 重排(x86-TSO 的唯一乱序来源)。接收侧对称地用 invalidate queue 让失效"先回 Ack、后生效",代价是本核延迟看到别人的写。两者都靠内存屏障在关键点强制排空来换回强一致。协议保正确,缓冲保性能,屏障按需拔高——这就是现代多核"又快又能对"的三层结构。