服务端并发/线程模型 —— 有了 epoll,用几个线程、怎么分工
epoll 解决了"一个线程盯住成千上万个 fd",但它只回答了"怎么等"这半个问题;另外半个是:这些就绪事件由几个线程来处理?谁负责 accept、谁负责读写 IO、谁负责耗时计算? 这就是"并发/线程模型"要回答的。本篇建立在 epoll 之上:先讲清 epoll 单打独斗的两个天花板,再引出事件驱动的核心范式 Reactor 及其三种经典变体(逐个画图),讲连接怎么分配到线程,最后对比"线程池 vs 协程"两条压榨并发的路。本篇是导读"并发/线程模型"分支的展开。
一、问题定位:epoll 解决了一半,还剩两个天花板
一句话:epoll 让"一个线程盯多个 fd"成立,但"一个线程"很快撞上两堵墙——处理不过来、多核用不满。
用一个 epoll 事件循环收连接、收数据,连接数不再和线程数一比一,内存这关过了(瓶颈①,见导读)。但单靠这一个线程,还有两个躲不掉的问题:
| 天花板 | 现象 | 根因 |
|---|---|---|
| ① 处理不过来 | epoll_wait 一次返回几百上千个就绪 fd,单线程挨个处理,后面的事件排长队;某个事件里做了点耗时计算,整条循环卡住 | 就绪事件的处理是串行的,CPU 干活能力被压在一个线程上 |
| ② 多核用不满 | 机器 16 核,单 epoll 线程只跑满 1 核,其余 15 核闲着 | 一个线程只能用一个核,epoll 循环本身不会自动并行 |
所以线程模型要回答的,就是把"等 IO(epoll_wait)、accept 新连接、读写 IO、耗时计算"这几件事,拆给几个线程、各自负责哪一块。答案的核心范式,就是 Reactor。
一句话:epoll 把"等"做到了极致,但"处理"和"多核"还得靠线程模型来分工——线程模型 = 给 epoll 事件循环配上合理的分工方案。
二、Reactor 模式:事件驱动的核心范式
一句话:Reactor = 一个 epoll 事件循环 + 一个事件分发器(dispatcher),把就绪事件按类型派发给对应的 handler。
"Reactor"直译是"反应堆"——它不主动去问"谁有数据",而是被动等待事件发生,一有事件就"反应"(分发)。一个 Reactor 的骨架永远是这三步的循环:
epoll_wait阻塞等待,拿回一批就绪的 fd(等)。- 分发器根据每个 fd 的类型/事件,把它交给对应的 handler(分)。
- handler 执行具体动作:listen fd 就绪 →
accept;连接 fd 可读 →read+ 处理;可写 →write(做)。
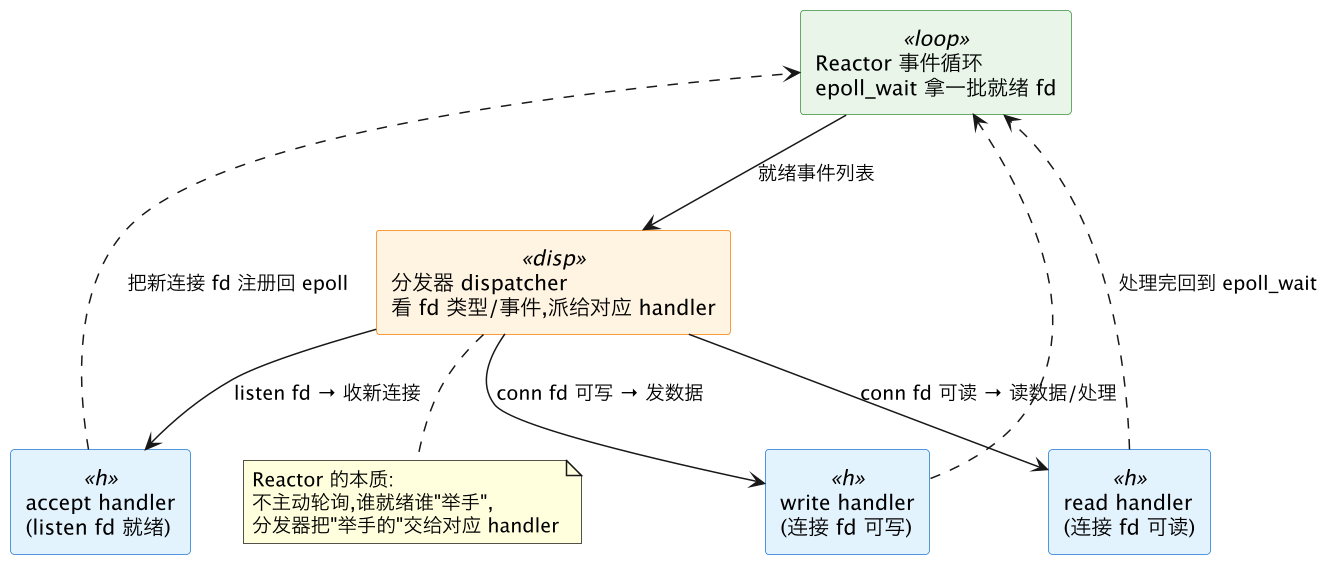
Reactor 只是范式,真正的分歧在于:这个循环、这些 handler,由几个线程来跑? 由此分出三种经典变体。
一句话:Reactor 就是"epoll 循环 + 分发器 + 一堆 handler",它规定了"事件怎么流转",但没规定"用几个线程"——那正是下面三种变体的区别。
三、三种经典 Reactor 变体
3.1 单 Reactor 单线程:一个线程包圆
一句话:一个线程既 epoll_wait,又 accept、又读写、又跑业务——简单、无锁,但业务一慢就全卡,还只能用一个核。
所有事情都在同一个线程里做:epoll_wait 拿就绪事件 → 分发 → accept / read / 业务处理 / write,处理完回到 epoll_wait。Redis(≤5.x)的网络层就是这个模型。
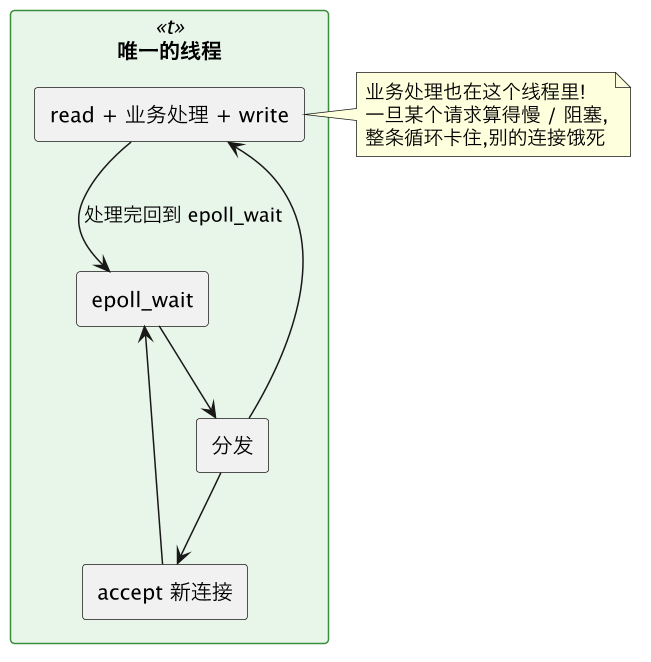
| 优点 | 缺点 |
|---|---|
| 实现极简,全程无锁(单线程无并发) | 业务耗时/阻塞会卡住整条循环,拖垮所有连接 |
| 无上下文切换、无缓存抖动 | 只能用一个核,多核浪费 |
适用:业务极轻(纯内存操作、转发)、单核 CPU 就够的场景。这就是 Redis 早期"单线程也能扛高并发"的底气——命令是纳秒级内存操作,瓶颈在网络不在 CPU。
3.2 单 Reactor 多线程:IO 单线程,计算丢给线程池
一句话:一个线程专职 epoll + accept + 读写,把耗时业务甩给 worker 线程池——IO 归 IO、计算归计算。
针对 3.1 的"业务卡循环"痛点:IO 线程读完数据后,不自己算,而是把业务任务扔进一个 worker 线程池;worker 算完把结果交回 IO 线程去 write。这样耗时计算被隔离在池里,事件循环始终快速空转。
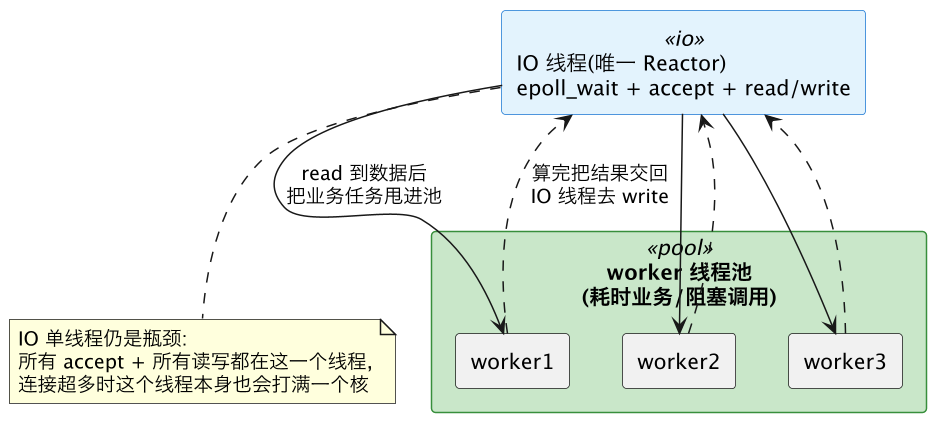
| 优点 | 缺点 |
|---|---|
| 耗时业务不再卡事件循环,计算能吃多核 | IO 仍是单线程:accept + 全部读写压在一个核,海量连接时它先到顶 |
| 结构比多 Reactor 简单 | IO 线程和 worker 之间有任务队列的交接/同步成本 |
适用:业务有一定 CPU 开销,但连接数/收发压力还没到让单个 IO 线程打满的程度。
3.3 主从 Reactor 多线程(multi-Reactor):accept 与 IO 彻底分离
一句话:mainReactor 只管 accept,多个 subReactor(各一线程、各一 epoll)分摊已建立连接的 IO,再配 worker 池——这是 Netty/高性能服务器的主流。
把 3.2 的"IO 单线程"瓶颈也拆开:
- mainReactor(主):只有一个 epoll,只监视 listen fd,只做 accept。接到新连接后,按策略把它分派给某个 subReactor。分派完立刻回去等下一个连接。
- subReactor(从):多个,每个一条线程、各自一个独立的 epoll,只负责分到自己名下那批连接的读写。个数通常 = CPU 核数,可绑核(见 thread-affinity)。
- worker 线程池:subReactor 只做非阻塞收发,耗时业务再甩给 worker 池(同 3.2)。
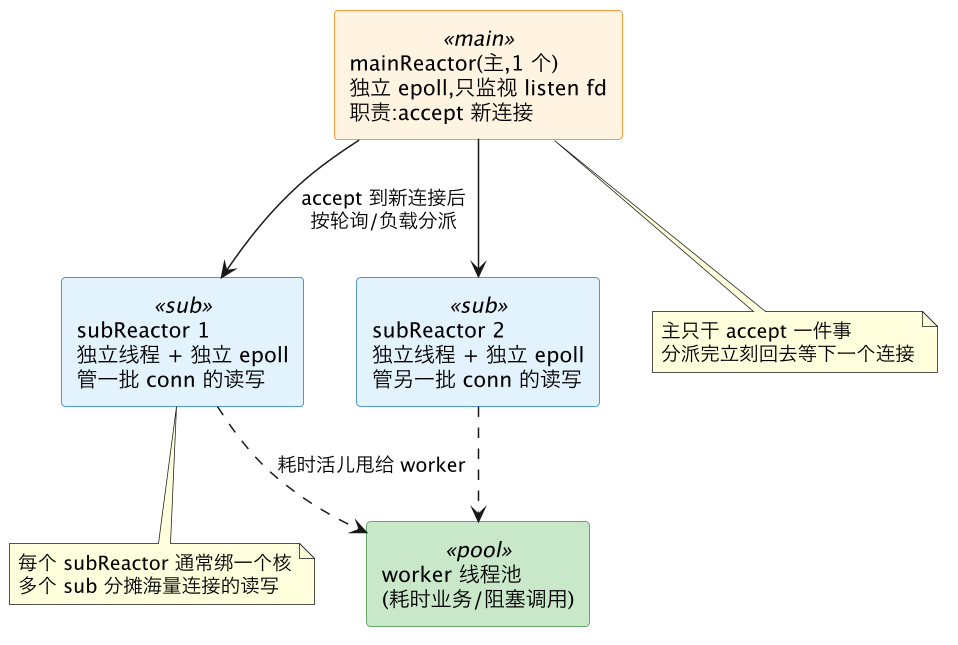
accept 与 IO 分离带来的关键收益:accept 不再和读写抢同一个线程,新连接建立速度不受已有连接读写负载的拖累;多个 subReactor 把读写压力摊到多核,单个 IO 线程的天花板被突破。这就是 Netty(boss 组 accept + worker 组 IO)、以及大多数高性能服务器的核心结构。
| 优点 | 缺点 |
|---|---|
| accept 与 IO 分离,读写吃满多核 | 结构最复杂,跨线程分派/同步需小心 |
| 连接被分摊到多个 subReactor,单线程不再是瓶颈 | subReactor 之间可能负载不均(取决于分派策略) |
四、一个连接怎么分配到某个线程
一句话:要么"accept 后由 main 把新 fd 注册到某个 subReactor 的 epoll"(应用层分派),要么用 SO_REUSEPORT 让内核在源头就把连接分散到多个 listen fd(内核分派)。
主从 Reactor 里,新连接落到哪个 subReactor,有两条路线:
- 应用层分派(main 分):mainReactor
accept出新 fd 后,按**轮询(round-robin)或当前负载(挑连接数最少的 sub)**选一个 subReactor,把这个 fd 注册进它的 epoll。简单可控,但所有连接都先经 main 这一个点。 - 内核分派(SO_REUSEPORT):让每个线程各自 bind 同一个 IP:端口,各拥有一个独立 listen fd 和独立 accept 队列;新连接到来时内核按四元组哈希直接投给某一个队列。从源头就分摊,没有单点 accept、无锁竞争,还顺带解决惊群(见 epoll 第四节)。Nginx 的
listen ... reuseport、每线程一个 listen fd 的现代框架都走这条路。
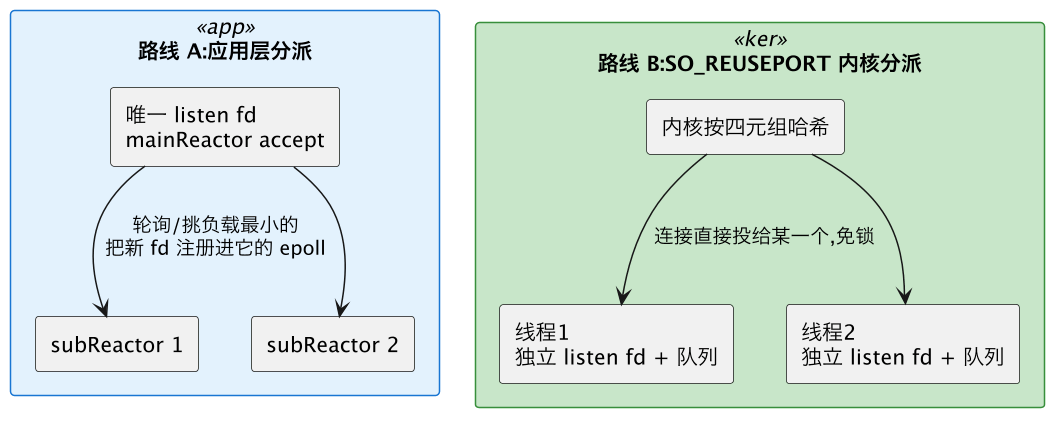
| 维度 | 应用层分派(main 分) | SO_REUSEPORT(内核分) |
|---|---|---|
| accept 点 | 单点(main) | 每线程各一个,无单点 |
| 惊群/锁 | 需注意 | 天然无惊群、无锁 |
| 负载均衡 | 可按实时负载精确挑 | 按哈希,通常较均但不感知实时负载 |
| 灵活度 | 高(策略自定) | 低(内核哈希固定) |
五、线程池 vs 协程:两条压榨并发的路
一句话:线程池用"少量重量级线程"扛阻塞业务;协程用"海量用户态轻量线程"把异步写成同步的样子——遇 IO 就让出,不陷内核。
Reactor 有条铁律:事件循环里绝不能阻塞。一旦在循环里做了阻塞磁盘 IO、抢长锁、跑耗时计算,整条循环卡死,名下所有连接一起饿死。绕开阻塞有两种主流手段:
- 线程池:事件循环只做非阻塞收发,凡是可能阻塞/耗时的活儿(大文件读、
fsync、复杂计算、同步访问下游)一律甩给 worker 线程池,算完再交回循环发送。代价:线程重(每个默认 8MB 栈,见 thread-creation),线程间切换要陷内核(见 context-switch),线程数开不大。 - 协程(coroutine):用户态的轻量"线程"——goroutine、C++20 coroutine、Kotlin 挂起函数等。一个系统线程上可以跑成千上万个协程;某个协程一遇到 IO(会阻塞的调用),运行时把它挂起、切到同线程的另一个协程,IO 就绪再切回来。于是你能用同步的写法(一行行顺着写
read/write)表达异步逻辑,运行时在底层帮你对接 epoll——把"异步回调地狱"抹平成"同步风格代码"。
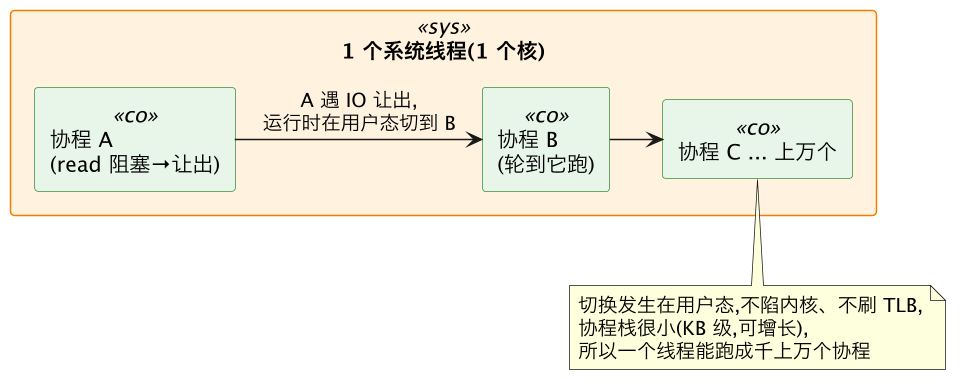
协程为什么适合高并发:① 栈小——协程栈初始 KB 级(可按需增长),不像线程默认 MB 级,内存上能开成千上万个;② 切换廉价——协程切换在用户态完成,只需保存/恢复少量寄存器和栈指针,不陷入内核、不刷 TLB,远比线程上下文切换便宜(线程切换的内核开销见 context-switch);③ 写法同步、执行异步——遇 IO 让出而非阻塞,底层仍是 epoll 事件驱动,却省掉了手写回调的心智负担。
一句话:线程池是"把阻塞关进少量重线程的笼子";协程是"把阻塞变成用户态的一次廉价让出"——前者兼容一切阻塞代码,后者用同步写法拿到事件驱动的性能。
六、对比总表
| 维度 | 单 Reactor 单线程 | 单 Reactor 多线程 | 主从 Reactor 多线程 | 协程 |
|---|---|---|---|---|
| accept 在哪 | 唯一线程 | 唯一 IO 线程 | mainReactor 专职 | 运行时调度(常配 SO_REUSEPORT) |
| IO 读写在哪 | 唯一线程 | 唯一 IO 线程 | 多个 subReactor 分摊 | 各协程内(遇阻塞让出) |
| 计算在哪 | 唯一线程(会卡循环) | worker 线程池 | worker 线程池 | 协程内直接写(阻塞点自动让出) |
| 多核利用 | ✘ 只用一个核 | 计算多核,IO 单核 | ✔ IO + 计算都吃满多核 | ✔ 多线程各跑一批协程 |
| 是否有锁 | 无锁 | IO/worker 间需同步 | 跨线程分派需同步 | 看是否跨线程共享(单线程调度可无锁) |
| 复杂度 | 最低 | 中 | 高 | 中(依赖语言/运行时) |
| 代表 | Redis(≤5.x) | 部分自研服务 | Netty、多数高性能服务器 | Go、C++20 协程、Kotlin |
七、和本仓库其他文档的关系
本篇建在 epoll 之上——epoll 提供"等一批就绪 fd"的能力,线程模型决定"用几个线程消费这批事件"。相关联的开销与机制:
- 事件循环的基石、LT/ET、惊群与 SO_REUSEPORT:epoll
- 多路复用与其他 IO 模型的横向对比:io-models
- 线程创建成本、栈内存(为什么线程开不多、协程栈为什么小):thread-creation
- 上下文切换代价(线程切换陷内核 vs 协程用户态让出):context-switch
- 把 subReactor/worker 绑核,减少迁移与缓存抖动:thread-affinity
- 整个高并发优化框架里线程模型的位置:overview
八、一句话总结
epoll 只解决了"一个线程盯多个 fd",剩下的"处理不过来 + 多核用不满"由线程模型来分工:Reactor(epoll 循环 + 分发器)是核心范式,单 Reactor 单线程最简但卡循环、只用一核,单 Reactor 多线程把计算甩给线程池、IO 仍单核,主从 Reactor 让 main 专职 accept、多个 subReactor 分摊 IO 吃满多核(Netty/主流服务器);连接分配靠应用层轮询/负载分派或 SO_REUSEPORT 内核哈希免锁;而线程池用重线程扛阻塞、协程用用户态廉价让出把异步写成同步——选谁,取决于单请求的 CPU 成本和你要压榨到哪一层。