数据冒险(Data Hazards)导读 —— 依赖就是速度的敌人
本文讲透数据冒险:三条因果链(流水线 → 超标量 → 乱序)为何必然引入冒险、RAW 是真依赖 / WAW·WAR 是假依赖这个根本区分、以及三种冒险的 µop 级对比。这是理解流水线性能(pipelining-superscalar)、乱序执行(cpu-out-of-order)、寄存器重命名(register-renaming)、保留站(reservation-station)、ROB(rob)、LSU(lsu)的枢纽文档。
破题:为什么说"依赖就是速度的敌人"
第一条因果链——流水线:
流水线(pipelining)让每个部件持续忙碌 → 但部件之间不能有间隔 → 相邻两条指令的"写→读"间隔就是冒险的温床 → 于是必须解决冒险。
一条指令刚完成(产生结果),紧跟着的指令就要用这个结果——但结果要经过"写回寄存器"才能被读到。这个**"写→读"的间隔**,在流水线里就是冒险(hazard)。
第二条因果链——超标量:
超标量(superscalar)要求每拍发射多条指令 → 多条指令竞争同一个寄存器 → 名字冲突爆炸(WAW/WAR)→ 重命名把名字换掉 → 但真依赖(RAW)换不掉。
超标量把"相邻"变成了"同时"——多发射让冒险的检测范围从"相邻两条"扩大到"同一窗口内任意两条"。流水线只担心 RAW;超标量把 WAW/WAR 也逼成了必须处理的现实问题。
第三条因果链——乱序:
乱序执行(out-of-order)让指令不必按序执行 → 乱序是解决冒险的手段(绕过长延迟,执行后续独立指令)→ 但乱序需要重命名(避免 WAW/WAR 名字冲突)+ 保留站(等待 RAW 数据就绪)+ ROB(乱序执行结果按序提交)。
乱序执行不是制造冒险,而是解决冒险——它靠"绕过等待"把冒险的代价藏起来。
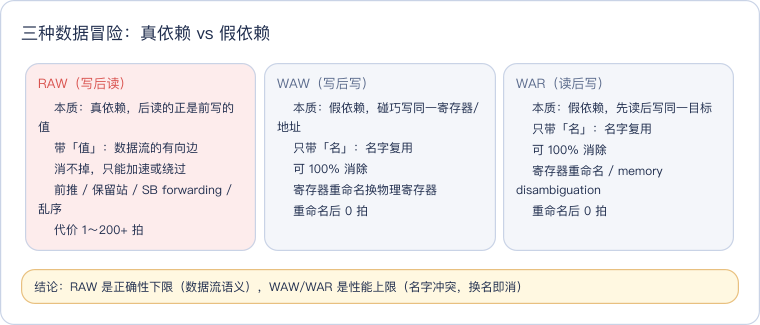
破题结论——三种冒险的定性与量化:
| 冒险 | 全称 | 本质 | 能消除吗 |
|---|---|---|---|
| RAW | Read After Write | 真依赖:后读的正是前写的值 | ❌ 不能 |
| WAW | Write After Write | 假依赖:碰巧写同一个寄存器/地址 | ✅ 能 |
| WAR | Write After Read | 假依赖:碰巧先读后写同一个寄存器/地址 | ✅ 能 |
- RAW 是正确性下限:程序的数据流语义,绕不过去,只能靠硬件加速(前推、保留站、store buffer forwarding)或乱序绕过
- WAW/WAR 是性能上限:名字冲突,换名字(寄存器重命名)就没了
- 另外,所有冒险都发生在 µop 之间(CISC 指令被译码器拆成 RISC µop 后才进流水线)——这是理解一切冒险的视角起点
一个量化镜头:三种冒险的代价差了多少
把三种冒险放到同一把尺子上量——都是"相邻两条指令",代价却横跨三个量级:
| 冒险 | 最小代价 | 最坏代价 | 硬件消解 |
|---|---|---|---|
| ALU→ALU(RAW) | 1 拍(前推) | 依赖链上逐条累加 | 前推旁路 + 结果总线广播 |
| Load→Use(RAW) | 5 拍(L1 hit) | 200+ 拍(DDR miss) | 前推省 1 拍 + 乱序窗口隐藏 |
| Store→Load(RAW) | ~3 拍(SB forwarding) | 地址比对失效退化 | store buffer 地址比对 |
| WAW/WAR(假依赖) | 0 拍(重命名换名) | 仅 PR 池耗尽才影响性能 | 寄存器重命名 |
这张表就是整族文档的"价目表":真依赖的代价从 1 拍到 200 拍横跨三个数量级,假依赖经重命名后归零。 后面四篇速览,就是把这张表的每一行逐个展开。速记法:延迟越大的行越接近"内存",代价越小的行越接近"寄存器"——ALU→ALU 是寄存器里的 1 拍,Load→Use/Store→Load 是内存里的 5~200 拍,假依赖是名字层面的 0 拍。
为什么 RAW 消不掉、而 WAW/WAR 能?一句话版:RAW 是数据流本身——a=b+c 里 b 的值必须到,换名字没用;WAW/WAR 是名字复用——a=1; a=2 只要让第二次写换个物理寄存器,两次写就互不相干。更深一层:RAW 的定义里带着"值",WAW/WAR 的定义里只带着"名"。 硬件消解冒险,本质是让"值"的传递更快(前推),或让"名"的复用不冲突(重命名)——前者在物理世界加速,后者在逻辑世界换名,所以重命名能 100% 消除假依赖,前推只能把 RAW 压到 1 拍、压不到 0。
四篇速览
篇一:RAW 寄存器域——ALU→ALU 前推旁路
RAW 篇(寄存器域) 讲最快的一种真依赖:
- µop 视角:CISC 只暴露到译码器,冒险 = µop 之间的物理寄存器依赖
- ALU→ALU:前推旁路压到背靠背 1 拍;前推的硬件本质是 RAT 判依赖 → 结果总线广播唤醒 → 前推 MUX 截胡(只覆盖最近 1~2 条)
- 代码层实践:依赖链(IPC≈0.3)vs 独立链(IPC≈端口数)——前推救相邻两条,救不了一整串,能拆的链就拆
篇二:RAW 访存域——Load→Use 与 Store→Load
访存 RAW 篇 讲数据不在流水线里的两种真依赖:
- Load→Use:AGU→TLB→SB→L1 全路径,L1 hit 也至少 5 拍,延迟随命中率浮动到 200+ 拍
- Store→Load:store buffer 地址比对 forwarding,命中零额外延迟;部分重叠、跨 line、STA 未完成都会失效
- 调优分叉:Load→Use 拼命中率与 MLP,Store→Load 拼地址对齐与匹配完备性
篇三:WAW/WAR——假依赖,换个名字就消解
假依赖篇 讲透两种假依赖及它们的两个域:
- 寄存器域:WAW/WAR 靠寄存器重命名完全消除(RAT 给每个写分配新 PR、始终指向最新版本)——重命名后正确性层面不存在,只可能因 PR 池耗尽变性能问题
- 内存域:Store WAW 靠 ROB + store buffer 按序提交;Load→Store WAR 靠 memory disambiguation
- 为什么 RAW 消不掉而 WAW/WAR 能:RAW 是数据流的有向边(值必须到),WAW/WAR 只是名字复用(换名语义不变)
篇四:L1 miss 连锁反应——200+ 拍的代价解剖
miss 连锁反应篇 把前推救不了的场景量化到拍:
- 14 拍时间轴全景:load 卡在 LSU(miss 判定 1 拍但结果要等数据)→ 依赖 µop 保留站挂起 → 无关 µop 补偿执行(乱序执行的价值)→ 最坏 ROB 对头阻塞
- MLP(内存级并行):多个独立 load 的 miss 并行等待(MSHR 登记)——数组天然 MLP≈64,链表强制 MLP=1,这就是两者差一个数量级的微架构根
- 配套 perf 验证:
cache-misses / cache-references命中率 +stalled-cycles-backend
关系与导航
数据冒险是理解微架构的枢纽,它连接了上下游几乎所有部件:
| 前置概念 | 文档 | 关系 |
|---|---|---|
| 流水线如何引入冒险 | pipelining-superscalar | 流水线 → 相邻指令间隔 → 冒险温床 |
| µop 从哪来 | uop-pipeline-walkthrough | CISC 译码为 µop 后的世界 |
| 冒险的解决方案 | 文档 | 关系 |
| 重命名怎么消除假依赖 | register-renaming | WAW/WAR 的寄存器域解法 |
| 保留站怎么等待真依赖 | reservation-station | tag 监控 + 唤醒机制 |
| 乱序怎么绕过冒险 | cpu-out-of-order | 乱序窗口 + 调度 |
| ROB 怎么收尾 | rob | 按序提交 + 对头阻塞 |
| LSU 的 memory disambiguation | lsu | Load→Store WAR 的解法 |
| Store Buffer 与 forwarding | store-buffer | Store→Load RAW 的解法,SB 地址比对与 L1 访问的 1 拍并发 |
| 缓存 miss 的物理基础 | cache-organization | L1 miss 是 load→use RAW 延迟的硬件根源 |
| 编码习惯落地 | cache-friendly-code | 顺序访问/SoA 为何天然高 MLP |
一句话总结:数据冒险是流水线、超标量、乱序执行三者合力逼出来的问题——RAW 是真依赖,消不掉,只能加速或绕过;WAW/WAR 是假依赖,重命名换名即消。四篇拆分:RAW 的寄存器域(ALU→ALU 前推)见 RAW 篇,访存域(Load→Use/Store→Load)见 访存 RAW 篇,假依赖与对比总表见 假依赖篇,前推救不了的 L1 miss 连锁反应与 MLP 见 miss 连锁反应篇。