MSI 协议 —— 从"为什么需要缓存一致性"讲起
MSI 是缓存一致性最朴素的形态(Modified/Shared/Invalid 三态)。开篇先回答一个根本问题:多核 CPU 为什么非要一致性协议?不要会怎样? 想通这个,才知道 MSI 在解决什么,以及 MESI 的 E、MOESI 的 O、MESIF 的 F(变种见 mesi-variants)在优化什么。
本篇是家族的问题起点;协议细节的主文档是 mesi,横向对比见 comparison。
一、先看物理拓扑:多核缓存长什么样
讲协议前,必须先看清硬件是怎么连的——协议管的就是这张图里"缓存副本之间"的一致性。一颗现代多核 CPU 的存储层次大致如下:
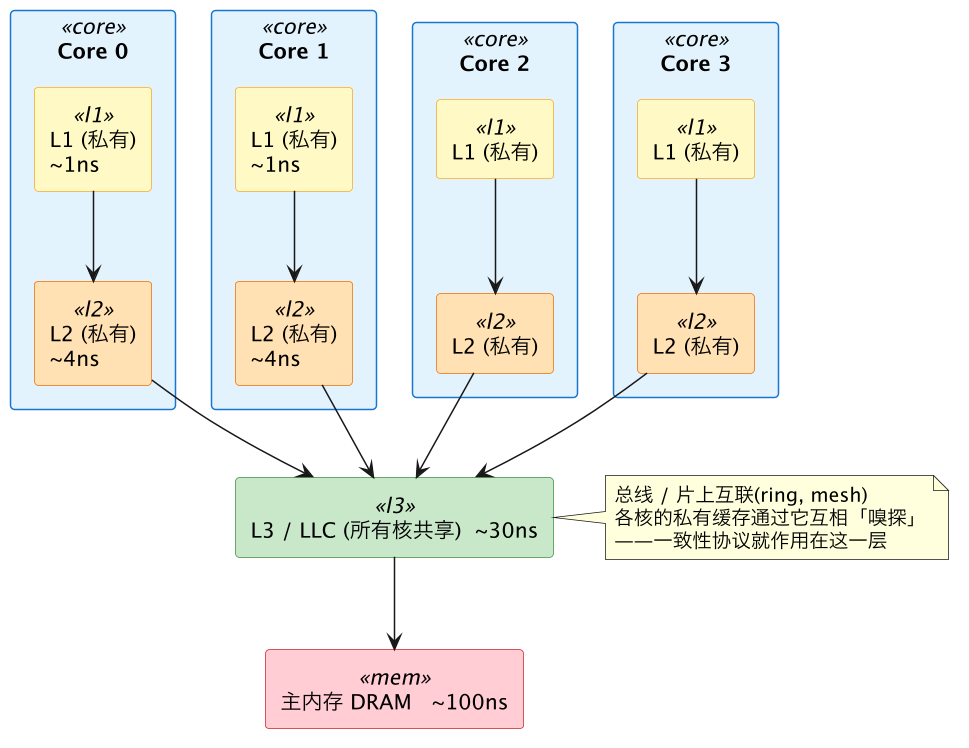
读这张图的三个要点:
- L1/L2 每核私有、L3/内存共享:一致性问题只发生在"私有缓存"层——同一份数据会在多个核的 L1/L2 各留一份副本。
- 速度差是动机:L1 ~1ns、L2 ~4ns、L3 ~30ns、内存 ~100ns。私有缓存快 100 倍,才值得每核各留一份;代价是要一套协议维持一致。
- 私有缓存靠"互联 + 嗅探"通气:早期共享总线,现代片上 ring/mesh(跨插槽走 NUMA)。协议的"广播、失效、转发"消息都跑在这条线上——跨核一致性开销大:要走互联,不是本地命中。
一致性协议本质上就是:给每个 cache line 标一个状态,让核间通过互联互相监听,保证多份副本对外看起来像一份。
二、数据在多级缓存里怎么流动(前置基础)
副本怎么进缓存、怎么变脏,属于单核缓存机制,已在 cache-organization 讲透(命中判定、write-back/write-allocate)。这里只强调引向"多核一致性"的一个关键分叉:
- 写的分叉:要改一条别的核也持有的行,硬件先发 RFO(Read For Ownership) 让其他核的副本失效,独占后才能写——脏数据 + 抢独占,正是一致性问题和 MSI 状态机的来源。(读的分叉见第四节场景4:脏(M)数据必须靠协议转发,因为内存是旧的。)
联系伪共享:一致性以 64B cache line 为单位维护——两个变量落在同一条 line 就共享同一个状态,一个核写它会波及另一个核。这是伪共享的地址级根源(详见 mesi 伪共享篇)。
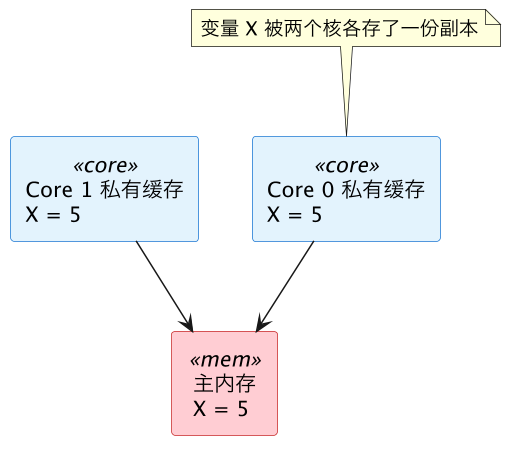
三、根本问题:多核私有缓存导致"数据不一致"
每个核都有私有 L1/L2。数据以 cache line(64 字节) 为单位搬运。问题就出在"私有":同一个地址 X,可能同时被多个核各缓存了一份副本。
四、不做一致性会出什么错?(用图看清 bug)
假设没有一致性机制,核 0 把 X 从 5 改成 100:
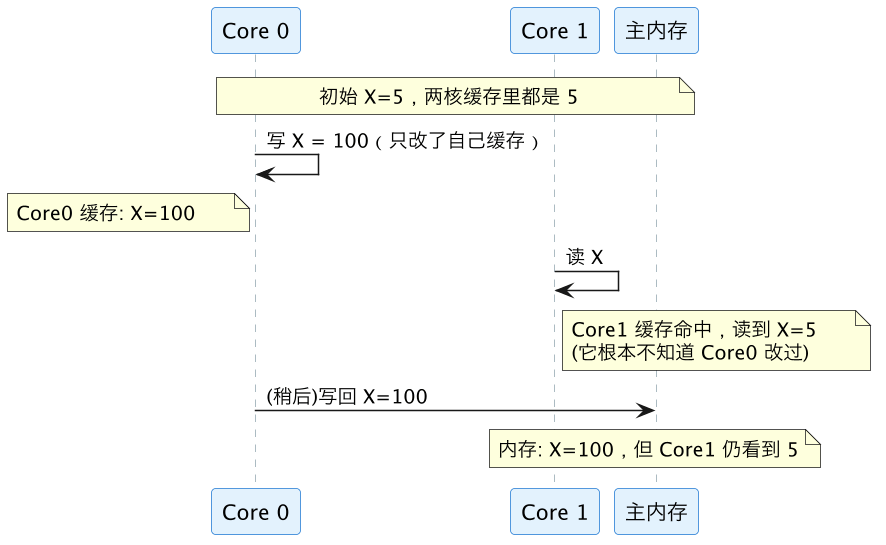
结果:Core1 读到了过期的 5。 两个核看到同一变量不同值,程序逻辑直接崩坏:标志位 ready=1 永远看不到(死等)、count++ 丢更新、锁状态不一致导致两个线程同时进临界区。
这就是缓存一致性问题(cache coherence problem)。没有硬件保证,多核共享内存的编程模型根本不成立——你写的
x = 1别的核可能永远看不到。
五、需要保证什么?—— 一致性的两条底线
一致性协议要让"多份缓存副本对外表现得像唯一一份内存"。具体保证两点:
- 写传播(write propagation):一个核对 X 的写,最终必须让其他核看得到。
- 写串行化(write serialization):所有核看到的"对同一地址的写顺序"必须一致(不能核 A 觉得先 5 再 100、核 B 觉得先 100 再 5)。
怎么实现?两条路线:
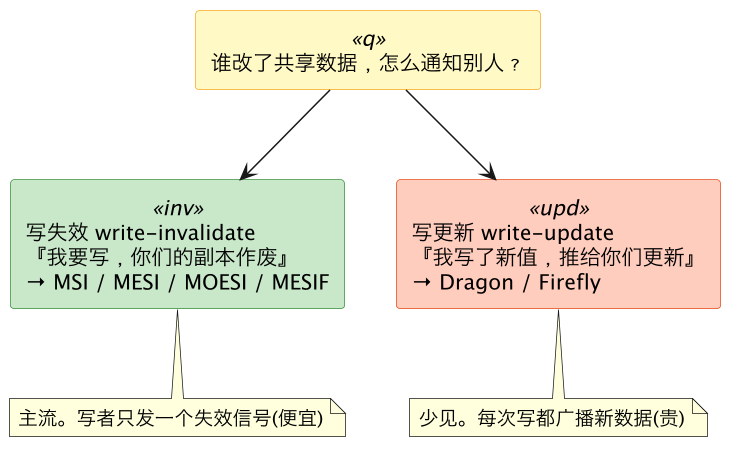
MSI 及其家族走"写失效":写共享行前先让其他核的副本失效,保证同一时刻"可写副本"只有一份,天然满足两条底线。(写更新路线见 mesi-variants。)
"通知失效"早期靠总线嗅探(bus snooping):所有核挂在共享总线上互相监听,谁读写就广播,别的核据此改自己的状态。MSI 就是这套机制上最小的状态集。
六、MSI 的三种状态
MSI 给每个 cache line(在每个核里)标三态之一:
| 状态 | 全称 | 含义 | 和内存一致? | 可否直接写 |
|---|---|---|---|---|
| M | Modified | 本核改过、是最新值,内存里是旧的;独此一份 | 否(脏) | 可 |
| S | Shared | 一个或多个核持有干净副本,与内存一致,只读 | 是 | 否(要先让别人失效) |
| I | Invalid | 本核该行无效/没有 | — | — |
有了三态,第四节 bug 就被堵住:核 0 写 X 必须先升 M,这一步让核 1 的副本变 I;核 1 再读时发现失效,只能重取最新值——不再读到过期的 5。
七、状态机(PlantUML)
先约定几个术语,分处理器侧(Pr) 和总线侧(Bus) 两类信号:
| 缩写 | 含义 |
|---|---|
PrRd | 本核处理器发起的读 |
PrWr | 本核处理器发起的写 |
BusRd | 别的核在总线上发起的读请求(本核嗅探到) |
BusRdX | 别的核发起的读独占(RFO, Read For Ownership,读了是要写) |
BusUpgr | 别的核把 S 副本升级为 M(无需取数,只让别人失效) |
Flush | 把 M 最新数据写回内存 / 转发给请求方 |
Pr*本核主动做,Bus*嗅探到别人做——同一条边,发起方是PrWr,旁观方嗅探到BusRdX/BusUpgr。- 下图中实线 = 本核
Pr*触发;[嗅探]= 被动迁移。颜色:、、。
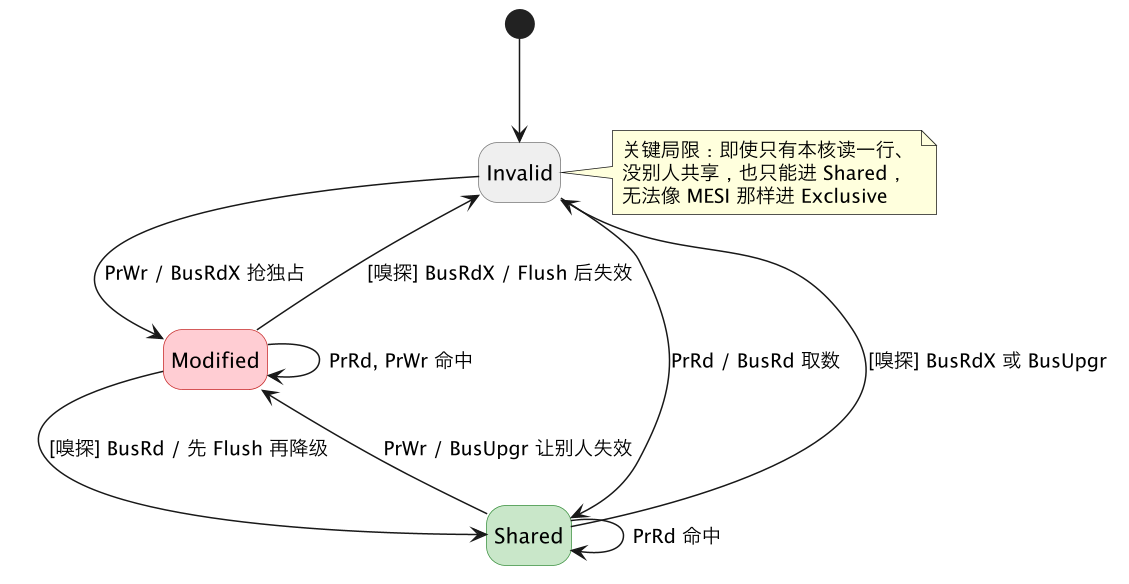
一句话:本核读写让自己往上升(I→S→M);嗅探到别人的读写把自己往下压(M→S→I)。
八、时序图:多核协作下的状态转移全景
上面的状态机是"一条 cache line 自己的视角",这里换成时序图,看同一地址 X 在多核并发读写时两个核的状态如何一步步迁移。约定:括号里是核对 X 的 MSI 状态;BusRd(读)、BusRdX(读独占)、BusUpgr(S→M 升级)、Flush(M 写回/转发)含义同前。
场景2:核B 也来读同一个 X(S → S,共享)
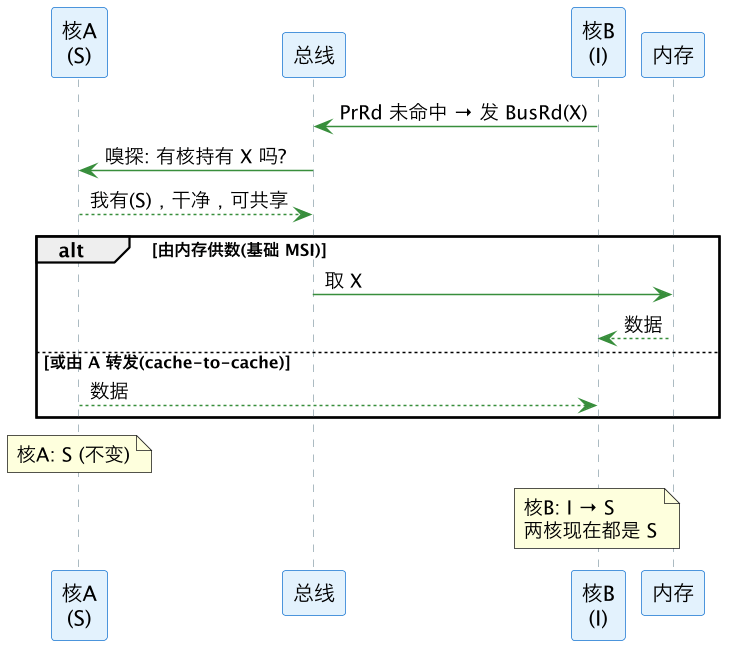
数据从哪来?S 是干净态,内存供数、cache-to-cache 都成立;真实 CPU 为快选后者,需加 F/O 管"谁转发"(见第十节表格)。
场景3:核A 要写 X(S → M,让核B 失效)
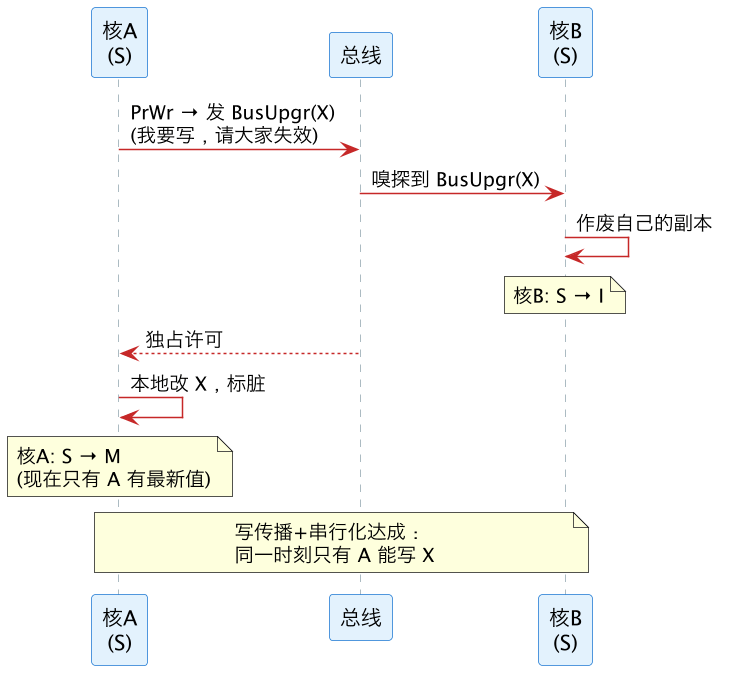
(BusUpgr 是广播还是定向投递,不影响下面的核心问题。)
追问二:需要等对端 ACK 吗? —— 需要,这是一致性正确性的硬要求。 核A 必须收齐所有 S 副本的 Inv-Ack(图里 B、C 都要到)才能升 M 动手写——否则核B 的旧副本可能还没作废,此刻去读就命中过期数据,第四节堵的 bug 又回来了:
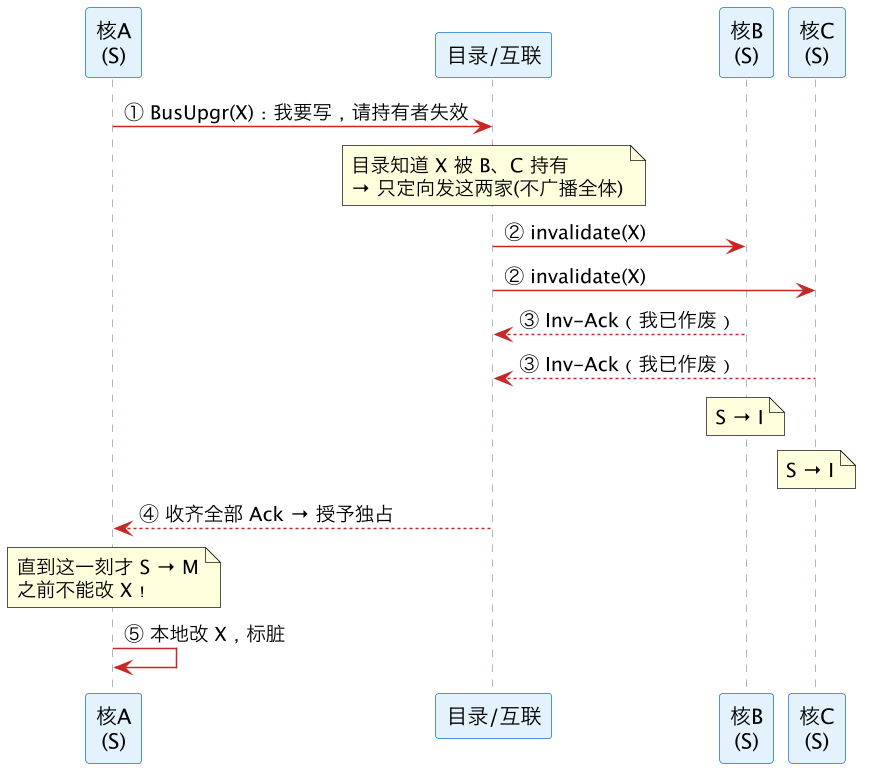
要点:
- ACK 是必须的:核A 要收齐所有被失效核的
Inv-Ack才拿到独占许可——少收一份都不行,那份没确认的副本可能还在被别的核读。 - 这也是跨核写为什么慢:一次
counter++,若这行正被别核共享,就要走"发失效 → 等 ACK 回来"一圈互联往返,几十上百拍耗在这;核越多等得越久——这正是伪共享让性能塌方的物理原因。 - 优化不是取消 ACK,而是少等/异步等:store buffer 让核A 把写暂存、等 ACK 期间继续干别的活(代价是引入内存乱序,要靠屏障纠正);目录+精确失效把"等全体"缩成"等真正持有者"。但"必须收齐 ACK 写才对外可见"这条底线不变。
一句话:无论广播还是定向,核A 都必须等所有 S 副本回
Inv-Ack才能升 M 动笔——这次"失效-确认"握手是写传播正确性的硬要求,也是跨核写慢和伪共享的根子。store buffer 能把"等"藏到后台,但藏不掉。
场景4:核B 读被 A 改过的 X(触发 A 的 M → S)
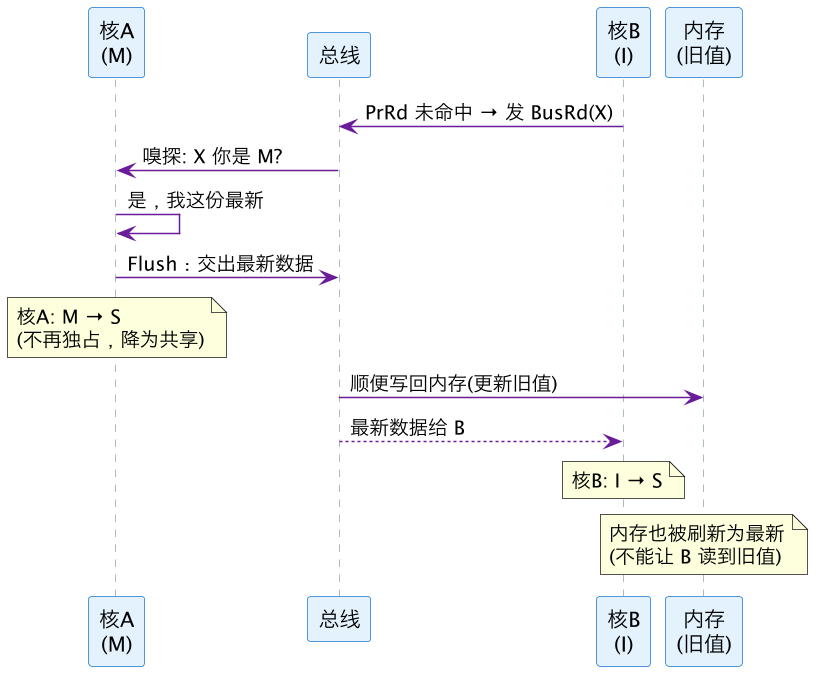
若场景4 里核B 是要写(发
BusRdX),核AFlush后直接 M → I,核B 取到数据后 I → M——对应状态机M --[嗅探 BusRdX]--> I那条边。
四个场景连起来就是 X 的完整生命周期:A读(I→S) → B读(都S) → A写(A升M、B降I) → B再读(A降S、B升S)……每步迁移都能在第七节状态机找到对应边——状态机是"规则",时序图是"规则的实际演出"。
九、MSI 的痛点:读后即写,白发一次广播
MSI 只有三态,分不清"独占且干净"和"共享"——行一律标 S,于是"先读再写"要发两次总线事务:
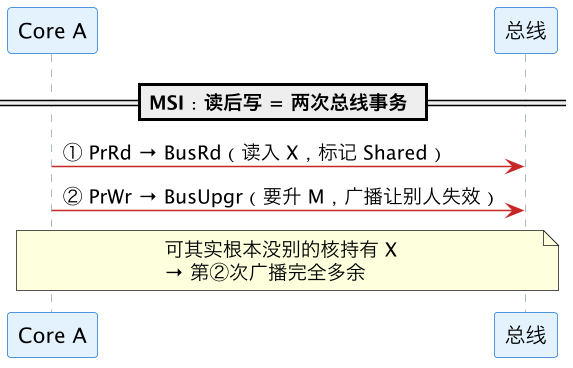
而读后即写极常见:counter++、"分配内存后初始化"、"取对象改字段"……MSI 每次都要为第 ② 步白发一次 BusUpgr。
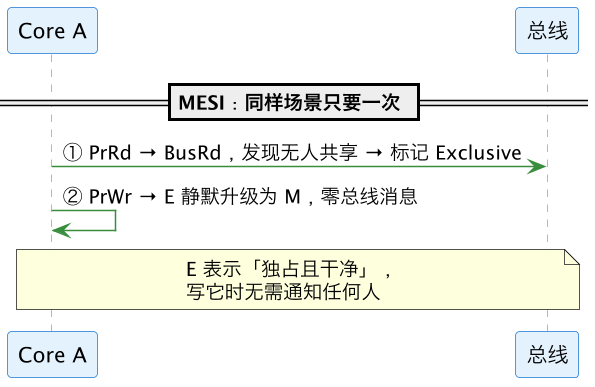
E 给"独占且干净"的行一条免广播升级的快车道——这就是 MESI 存在的全部理由。
十、家族演进:每个新状态省一种开销
MSI 能"正确工作",每种后续协议都为省某类总线/内存开销加一个状态:
| 演进 | 加的状态 | 省掉什么 | 谁用 |
|---|---|---|---|
| MSI → MESI | E Exclusive | "独占干净行"首次写的广播 | 通用基础 |
| MESI → MOESI | O Owned | 脏行被读时先写回内存 | AMD |
| MESI → MESIF | F Forward | 多个 S 副本谁应答新读者 | Intel (QPI/UPI) |
| 另一路:Dragon | 写更新替代写失效 | 非主流 | 教学/历史 |
一句话:MSI 是"能用"的最小集;E/O/F 都是为"少发总线消息 / 少写内存 / 少抢答"加的优化状态(完整对比见 comparison)。
十一、硬件实现:总线协议、时钟域与开销
MSI 在真实芯片上的落地——缓存控制器硬件(Tag+状态阵列、嗅探口)、嗅探总线事务阶段、多时钟域、一致性通信的周期级开销——属于通用缓存硬件机制,已统一收进 cache-organization 第十一节。
十二、对开发者的意义
MSI 本身你在真机上碰不到(商用 CPU 都用增强版),但它讲清了为什么会有伪共享——见 mesi-false-sharing。
十三、结论:MSI 是"对,但慢"
把全篇收成一句话——MSI 在功能上完全正确,问题纯粹是性能。
正确性:MSI 三态严格满足第五节两条底线(写传播靠升 M 强制他人失效、写串行化靠总线仲裁/目录),第四节 bug 被彻底堵死。在缓存一致性(coherence)这一层,MSI 与 MESI/MOESI/MESIF 完全等价,不会在线程间产生可见性问题——后面那些状态没有一个是为"正确性"服务的。
一个必须澄清的边界:coherence ≠ 内存顺序。跨核内存乱序由 store buffer 引入(核把写暂存、不等 ACK 继续跑),要靠屏障纠正——那不是 MSI 的责任:MSI 管"多份副本对外像一份",屏障管"写何时可见、能否重排"。准确说:MSI 保证一致性正确、不保证顺序一致性;顺序问题不归 MSI,也不是缺陷。
唯一的真问题(性能):MSI 分不清"独占且干净"和"共享",读后即写(counter++ 等)每次都要白发一次 BusUpgr(详见第九节)。E/O/F 全是为省这类开销(第十节对照表),没有一个在修正错误。
一句话结论:MSI 能正常工作、线程在一致性层面没有可见性问题,短板只是性能。E/O/F 以及目录、嗅探过滤、mesh 互联,全是在"已经正确"的骨架上做性能优化,而非修 bug。
总结
MSI 是「功能完全正确、问题纯粹在性能」的最小一致性协议:三态(Modified/Shared/Invalid)靠「升 M 强制他人失效」保证写传播、靠总线仲裁/目录保证写串行化,在缓存一致性(coherence)这一层与 MESI/MOESI/MESIF 完全等价,不会产生线程间可见性问题。它唯一的短板是分不清「独占干净」和「共享」,导致 counter++ 这类读后即写每次都白发一次总线升级(BusUpgr);E/O/F 三个新状态分别省「独占干净首写广播 / 脏行被读先写回 / 多副本谁应答」,没有一个在修正确性。还要划清边界:coherence ≠ 内存顺序,跨核乱序由 store buffer 引入、靠屏障纠正,不归 MSI 管。