µop 级流水线走读 —— 几条典型指令从取指到退休的完整旅程
把前面各部件文档(译码、重命名、保留站、执行端口、LSU、ROB)串起来,用三条真实 x86 指令逐拍追踪 µop 在流水线里的完整生命周期。本篇是导读页:讲清楚"为什么要走读、三条指令各自覆盖什么、核心结论是什么",以及和本仓库其他文档的关系。逐拍细节全部拆在四个独立子篇里。
本篇导航(导读 + 四个拆分篇):
| 拆分篇 | 内容 |
|---|---|
| µop 类型与切分 · 关键机制 | 前置知识:六大类 µop、端口分配、macro-op fusion、指令切分规律、七级阶段、Store Buffer、RAT+tag 广播 |
| 三条指令逐拍走读 | mov [rbx], eax(STA+STD)· add eax,[rsi+8](LD+ADD)· addsd xmm0,[rdi+rcx*8](跨集群 FP) |
| 三案对比 | 时间线叠放对比、µop 各部件生命周期总表 |
| buffer 生命周期 | store/load buffer 槽位生命周期、LSU 层级、线程切换时的流水线清理 |
一、为什么要做 µop 级走读
各部件文档是"横切面"——讲清楚了每个部件怎么工作。但缺一个"纵切面"——一条指令到底怎么穿过所有部件,从取指到退休,每拍在哪个部件、做了什么、和谁交互。
本文以三条典型指令为例,逐拍拆解:
| 指令 | 类型 | 拆成几条 µop | 涉及部件 |
|---|---|---|---|
mov [rbx], eax | store(地址+数据) | 2 µop | AGU、Store Buffer、LSU、ROB |
add eax, [rsi+8] | load + ALU | 2 µop | AGU、L1 D-Cache、ALU、RS tag 匹配 |
addsd xmm0, [rdi+rcx*8] | 浮点 load + FP 运算 | 2 µop | AGU、FP RS、FP 执行单元、FP 物理寄存器 |
以下走读基于 Skylake 微架构(6 发射宽度、4 ALU + 3 AGU + 2 FMA),但原理适用于所有现代超标量乱序核。
走读之前,先给自己列几个"看完要能回答的问题",对照着读效率更高:
| 你想知道的问题 | 去哪个拆分篇 |
|---|---|
| x86 指令为什么拆成多条 µop?总共几类? | 前置知识篇 |
| store 为什么拆 STA+STD?两条 µop 能并行吗? | 案例一 |
| load→use 延迟为什么至少 2 拍? | 案例二 |
| FP 指令为什么比整数慢这么多? | 案例三 |
| 三条指令时间线叠在一起差在哪? | 三案对比 |
| store/load buffer 的槽位从填充到回收怎么走? | buffer 生命周期 |
二、核心结论速览
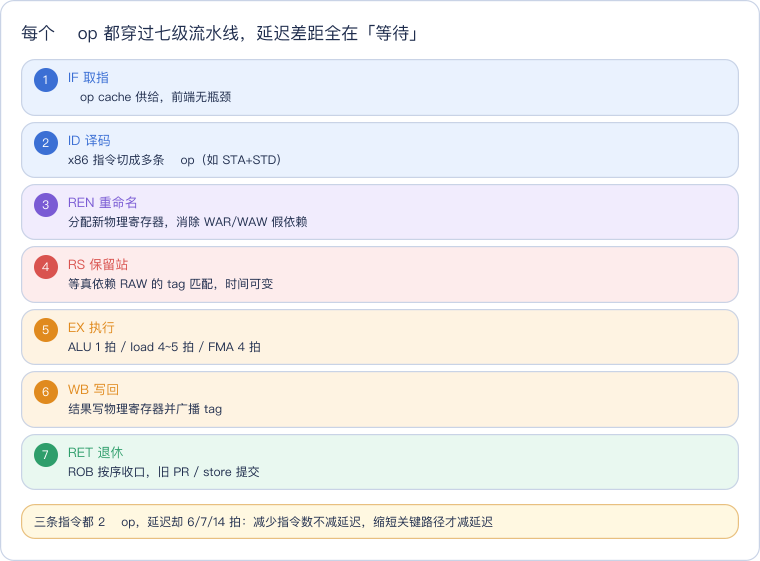
七级流水线:每条 x86 指令(的每个 µop)都穿过 IF → ID → REN → RS → EX → WB → RET 七个阶段。取指/译码/重命名各 1 拍,RS 等待时间可变,EX 拍数取决于 µop 类型(ALU 1 拍、load 4~5 拍、FMA 4 拍),WB 1 拍,退休按序 1 拍。
三条指令总对比(完整时间线叠放见 三案对比):
| 维度 | mov [rbx], eax | add eax, [rsi+8] | addsd xmm0, [rdi+rcx*8] |
|---|---|---|---|
| µop 数 | 2(STA + STD) | 2(LD + ADD) | 2(LD + ADDSD) |
| µop 间依赖 | 无 RAW | 有 RAW(µop₂ 等 µop₁) | 有 RAW(µop₂ 等 µop₁) |
| µop 在同一个 RS? | 是(INT RS) | 是(INT RS) | 否(INT RS + FP RS) |
| 最短总延迟(L1 命中) | ~6 拍 | ~7 拍 | ~14 拍 |
| 延迟瓶颈 | 无(可并行发射) | load→use 2 拍 | FP 流水线 4 拍 + 跨集群 |
| 退休时做什么 | 标记 store buffer 可提交 | 释放 eax 旧 PR | 释放 xmm0 旧 FP_PR |
三条规律:
- 总延迟 ≈ 关键路径上各执行单元延迟之和,和"指令条数"无关。三条指令都是 2 µop,延迟却从 6→7→14 拍递增,差距全在"等待"。这条规律对优化有直接指导:减少指令条数不减少延迟,缩短关键路径才减少延迟。比如
add eax, [rsi+8]的 7 拍里,ADD 只占 1 拍,LD 占了 4~5 拍——瓶颈在访存,不在运算。 - 重命名消除假依赖、保留站等真依赖、ROB 按序收口——这三个机制让"切碎的 µop"既能乱序并行又不破坏单核语义。假依赖(WAR/WAW)本来会强迫 µop 串行,重命名给每次写分配新物理寄存器后就化解了;真依赖(RAW)是算出来的数据必须等,RS 的 tag 匹配负责暴露它,乱序调度负责在等待期间插入别的 µop;ROB 则保证最终退休顺序与程序顺序一致,任何乱序执行都不能越过 ROB head。
- store 的"执行完毕" ≠ "内存已更新":拍 4 填 Store Buffer、拍 6 退休、拍 N 才异步写 L1——这个窗口就是 StoreLoad 重排的根源(详见 store-buffer)。
三条指令之外的通用经验
走读完三条指令,可以顺手带走几条能直接用的经验:
- 依赖链决定延迟,吞吐看端口:一段循环的每轮延迟由"最长依赖链"决定(比如 load→ALU→store 的链),而每秒能执行多少条由端口带宽决定(4 个 ALU 端口每拍最多 4 条 ALU µop)。优化循环要么拆依赖链,要么减少同端口 µop 数,两者是不同的事。
- load 延迟是循环头号瓶颈:L1 命中也要 4~5 拍,L2 命中 12 拍。循环体里连续依赖 load 结果的代码,瓶颈几乎总是访存。解法是预取、或者用数据布局让依赖链更短。
- FP 代码看 FMA 的 4 拍流水线:浮点依赖链每层至少 4 拍,比整数 1 拍慢一个量级。混合精度、减少不必要的转换、用向量化让一条 FMA 处理多个元素,都比优化整数部分划算。
两种读法:从图到字,还是从字到图
这套走读文档有两种用法,随学习习惯选:
- 图优先:先看每篇的 PlantUML 序列图,时间轴从拍到拍走一遍,不认识的术语再翻正文。图已经把"谁在什么时候做了什么"标清楚了,适合快速建立整体感,也是回头复习时最快的路径。
- 字优先:先把前置知识篇读透(µop 类型、七级阶段、三个机制),再进案例篇。文字把"为什么这么设计"讲得更细——比如 STA/STD 为什么拆开、重命名为什么变成三操作数、Store Buffer 为什么能异步提交——适合追究原理。
无论哪种读法,都建议按"前置知识 → 案例一 → 案例二 → 案例三 → 对比"的顺序至少过一遍:案例之间是递进的,案例三要用到案例二的 tag 唤醒机制,前置知识又是两个案例的共同基础。
这套文档的阅读顺序不是随意的,是"积木"式的——每篇只依赖前面的篇目,跳读容易卡壳。
假设条件:所有案例都假设的理想环境
三条案例都做了几个"理想化"假设,走读时心里有数,就不至于被实际机器的表现吓到:
- L1 D-Cache 命中:load 只花 4~5 拍;一旦 miss,12 拍(L2)起步,案例二的 load→use 就不是 2 拍而是 14 拍了。
- 无分支误预测:分支预测失败要冲刷 15~20 拍流水线,案例里没展示这条线。
- 前端无瓶颈:µop cache 足够喂满后端;实际上指令宽(5 字节的 addsd)会挤占取指带宽。
- Store Buffer 有空槽:56 个槽位写满时 store 会阻塞,案例里假设了空闲。
真实负载里这些假设全被打破,但"逐拍走读"的价值恰恰在这里——先把理想时序记牢,实测偏差才有参照系。
和本仓库其他文档的关系
| 涉及部件 | 对应文档 | 本文展示了什么 |
|---|---|---|
| 译码(x86→µop) | pipelining-basics §2.1 | 译码器如何把 mov [rbx], eax 切成 STA + STD |
| 寄存器重命名 | register-renaming | RAT 查表、PR 分配、tmp→P45 的建立与 µop₂ 的读取 |
| 保留站 | reservation-station | µop 在 RS 里等 tag 匹配、被调度器挑中发射 |
| 数据冒险 | data-hazards | load→use RAW 依赖的 2 拍延迟,前推网络的旁路 |
| LSU / Store Buffer | lsu | store buffer 生命周期、store→load forwarding、load buffer |
| ROB | rob | µop 按序退休、旧 PR 回收、store buffer 提交触发 |
| 乱序执行全景 | cpu-out-of-order | 三条指令的乱序可能(µop 间独立→可并行)与限制(RAW 依赖→串行) |
总结
mov [rbx], eax拆成 STA+STD 两条无依赖 µop,可同拍发射、store buffer 异步提交;add eax, [rsi+8]拆成 LD+ADD 两条有 RAW 依赖的 µop,load→use 至少 2 拍延迟;addsd xmm0, [rdi+rcx*8]拆成 LD+ADDSD 两条跨集群 µop,FP 执行单元 4 拍流水线是延迟大头。每条 x86 指令穿过 IF→ID→REN→RS→EX→WB→RET 七级,重命名消除假依赖、保留站等真依赖、ROB 按序收口——这三个机制让"切碎的 µop"既能乱序并行又不破坏单核语义。