DMA 多通道架构:并发能力、仲裁机制与工程价值
每个 DMA 通道是否独立、能否并行传输?如果后端总线共享,搞那么多通道意义何在?本文从硬件 FSM 到总线仲裁再到工程价值,把"多通道到底有什么用"讲清楚。
§零 一句话结论
每个 DMA 通道拥有独立传输状态机(FSM),硬件允许并行启动;最终数据吞吐是否并行,看后端总线是否独立。即使总线共享,多通道的核心价值也不在"叠加带宽",而在数据流隔离、优先级抢占、多外设独立中断、长短任务互不阻塞。
§一 先拆两个概念(很多人混淆)
这是最容易被混在一起的两个层次,必须拆开:
| 层次 | 问题 | 谁决定 |
|---|---|---|
| ① 通道 FSM 是否独立 | 能不能同时启动传输指令 | DMAC 内部设计 |
| ② 总线能否同时吞吐数据 | 会不会抢带宽、分时复用 | 后端 AXI/PCIe 端口数 |

- FSM 层:通道 0/1/2/N 各有独立寄存器、独立 LLI 链表指针、独立中断——可以"同时就绪"。
- 总线层:出口只有一组 AXI Master,所有就绪通道的读写请求在这里时分复用(time-multiplexed)。
§二 硬件架构内部
2.1 通道内部(单通道视角)
以 ARM PL330 单通道为例:
| 资源 | 作用 |
|---|---|
| 源地址寄存器(SAR) | 数据从哪读 |
| 目标地址寄存器(DAR) | 数据写到哪 |
| 传输计数寄存器(TCR) | 还剩多少字节 |
| LLI 链表寄存器(LLP) | 下一段描述符在哪(scatter-gather) |
| 控制/配置寄存器(CCR) | 传输方向、burst 长度、地址递增模式 |
| 通道状态机(FSM) | idle → load_descriptor → transfer → done |
| 独立中断线 | 该通道完成时触发专属 IRQ |
2.2 多通道 → 共享总线:仲裁器怎样分片
当 ch0 和 ch1 同时就绪、同时发出传输请求时:
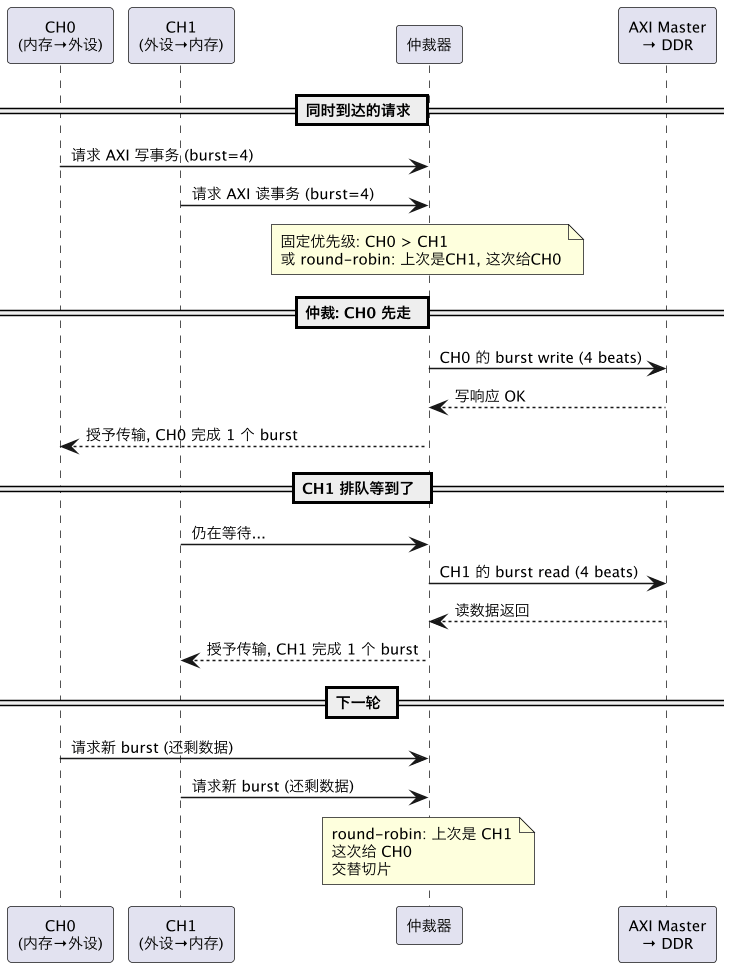
仲裁后的实际效果(时间线视图):
时间 →
CH0:  [burst0======][等待...][burst1======][等待...]
CH1:  [等待..........][burst0======][等待...][burst1======]
AXI:  [CH0-burst0][CH1-burst0][CH0-burst1][CH1-burst1]  ← 时分复用
FSM 并行:CH0 和 CH1 的状态机都在"传输中"状态,谁都没有被挂起。
总线串行:物理总线某一时刻只能服务一个 burst,多通道交替获得总线使用权。
2.3 两种典型仲裁策略
| 策略 | 规则 | 适用场景 |
|---|---|---|
| 固定优先级(Fixed) | CH0 > CH1 > ... > CH7,高优先级先走 | 有明确的紧急/普通业务分级 |
| 轮询(Round-robin) | 上次服务 CH_N,下次服务 CH_N+1,轮流 | 各通道同等重要,防止低优先级饿死 |
§三 多通道的五大工程价值
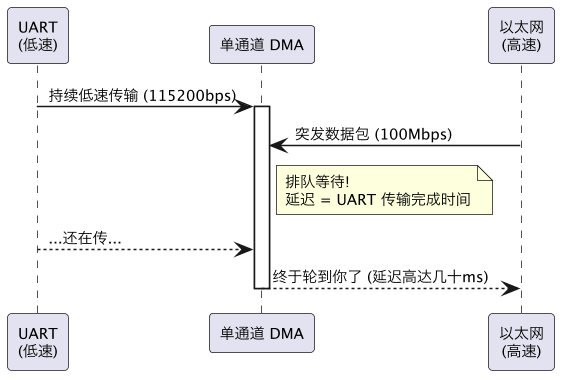
3.1 数据流隔离——低速不阻塞高速 (最高价值)
单通道时,UART 持续 DMA 占用控制器,以太网突发包只能排队:
多通道方案:UART 占 ch0,以太网占 ch1,ch1 随时能插入高优先级传输:
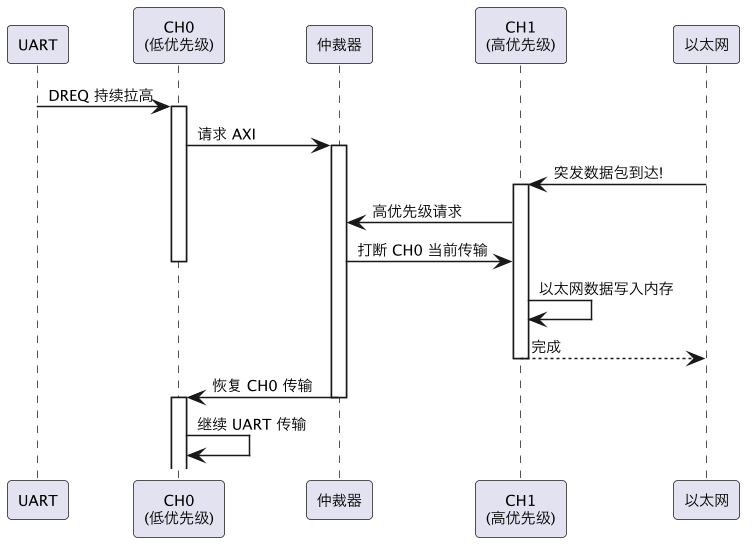
通道内置优先级仲裁,高优先级通道可以抢占低优先级通道的剩余带宽——不需要等低优先级传完。
3.2 多种传输方向同时存在
单通道只能串行:读完才能写。
| 单通道(串行) | 多通道(并发启动) |
|---|---|
| read 512B → done → write 512B → done | ch0: read 内存→FPGA |
| 总时间 = read + write | ch1: write FPGA→内存 |
| 两个方向同时进行(各自 FSM 推进) |
3.3 适配多外设独立中断
每个通道有独立中断信号。外设的 DMA 请求(DREQ)绑定到专属通道:
SPI_TX  → ch2  → CH2_IRQ  → 驱动知道"SPI 发送完成"
SPI_RX  → ch3  → CH3_IRQ  → 驱动知道"SPI 接收完成"
ADC     → ch4  → CH4_IRQ  → 驱动知道"ADC 采样 DMA 完成"
如果只有 1 条通道:所有 DREQ 挤在一起,驱动必须轮询状态寄存器判断"是谁完成的"——慢且易出错。
3.4 LLI 长链表传输穿插实时短任务
一条通道在执行 64KB scatter-gather 链表(几十段描述符),此时硬件事件触发需要紧急搬 64 字节——另一条通道可以立刻响应,插入短报文传输。
CH0: [desc0====][desc1====][desc2====][desc3====][desc4====]...  (LLI 链表, 64KB)
CH1:                [紧急64B]                                        (插入, 不阻塞)
单通道: 必须等 CH0 跑完 64KB 才能响应紧急任务 → 延迟可达 ms 级
多通道: CH1 仲裁获得总线 → 几百 ns 内完成紧急传输 → 延迟 μs 级
3.5 驱动软件解耦
不同业务静态分配专属通道,传输上下文互不干扰:
| 业务 | 通道 | 说明 |
|---|---|---|
| 视频流 | ch0~ch1 | 高带宽,连续传输 |
| 控制报文 | ch2 | 低延迟,小包 |
| 日志搬运 | ch3 | 低优先级,不抢带宽 |
驱动层无需复杂锁争抢同一个通道资源,每条通道独立管理自己的描述符队列和中断。
§四 两种极端场景对比
场景 A:单 AXI 端口 + 多通道(绝大多数嵌入式 DMAC,如 PL330)
✅ 通道 FSM 独立——可以同时就绪、并行发起请求
✅ 数据流隔离——低速不阻塞高速
✅ 优先级抢占——紧急通道打断普通通道
✅ 独立中断——多外设无需轮询
❌ 带宽不叠加——AXI 出口时分复用,总带宽 = 单端口带宽
场景 B:多独立端口(高端 SoC / XDMA / FPGA AXI-DMA)
✅ 通道 FSM 独立 + 总线端口独立
✅ 数据真正并行搬运——带宽线性叠加
✅ FPGA AXI-DMA: MM2S 和 S2MM 各占一条 AXI 通路,全双工互不争抢
✅ XDMA: 每对 H2D/D2H 独立 PCIe 流量通路,多通道带宽隔离
§五 FPGA 高速场景
5.1 AXI DMA:收发天然全双工
标准 Xilinx AXI DMA IP 内部:
MM2S 通道(Mem→Stream): 独立 AXI Read Master  + 独立 FSM
S2MM 通道(Stream→Mem): 独立 AXI Write Master + 独立 FSM
两套硬件完全独立 → 收发同时进行,互不抢占,真正全双工。
5.2 XDMA(PCIe DMA):多通道带宽隔离
每一对 H2D(Host→Device)/ D2H(Device→Host)都是:
- 独立传输引擎
- 独立 PCIe Tag 空间
- 独立中断
多通道可以在 PCIe 链路上真正并行搬运,带宽相互隔离——这对 FPGA 加速卡上的多算法流水线至关重要。
§六 总结
| 问题 | 答案 |
|---|---|
| 通道 FSM 能并行吗 | 能——每通道独立硬件状态机 |
| 数据一定并行吞吐吗 | 不一定——取决于后端总线端口是否独立 |
| 总线共享时多通道意义何在 | 数据流隔离 + 优先级抢占 + 独立中断 + 长短任务互不阻塞 |
| 何时带宽能叠加 | 每个通道绑定独立 AXI/PCIe 端口 |
一句话:多通道 DMA 真正的价值不在于"N 倍带宽",而在于"N 条数据流互不阻塞"——低速不拖累高速,紧急能插队,长短各走各的。这在嵌入式实时系统和 FPGA 硬件流水线中是不可替代的。
配套:DMA 原理见 dma,8237 四通道经典架构见 dma-8237,CPU 与 DMA 引擎的完整交互过程见 dma-cpu-interaction,PCIe 多通道流量通路见 pcie。
总结
多通道 DMA 的真正价值不是「N 倍带宽」,而是「N 条数据流互不阻塞」:每个通道有独立的硬件状态机/传输引擎/中断(AXI DMA 的 MM2S、S2MM 完全独立实现全双工,XDMA 每对 H2D/D2H 有独立引擎、独立 PCIe Tag、独立中断),因此低速流不拖累高速流、紧急任务能插队、长短任务各走各的,并带来数据流隔离与优先级抢占。通道 FSM 一定能并行,但数据能否真正并行吞吐取决于后端总线端口是否独立——只有每个通道绑定独立 AXI/PCIe 端口时带宽才叠加;端口共享时多通道换来的是隔离与确定性,而非吞吐翻倍。这在嵌入式实时系统和 FPGA 硬件流水线里不可替代。