进程创建的详细过程 —— fork / exec / clone 到底做了什么
Linux 上"创建一个新进程"从来不是一步到位的:先
fork()复制出一个几乎一样的自己,再execve()把新程序"换脑"进去。本篇从内核视角讲清fork复制了什么、写时复制 (CoW) 为什么让它又快又省、fork/vfork/clone的家族关系,以及fork+exec这个 shell 启动程序的标准姿势。下一篇 thread-creation 讲线程创建与共享。
加载细节(
execve → ld.so → _start → main)不在本篇重复,见 compile-link-load §四;本篇只讲进程语义。线程创建见 thread-creation,fork 与多线程的坑见 fork-and-threads。
零、全景图:为什么要"先复制再替换"
Unix 把"创建进程"和"运行新程序"拆成了两个独立动作,这是 Unix 设计里最经典的一刀切:
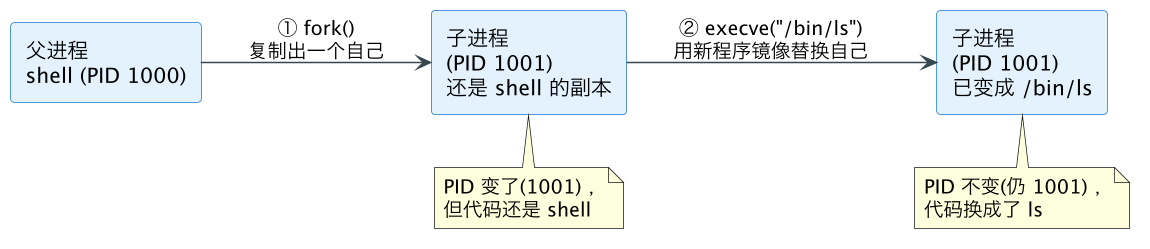
fork():复制当前进程,得到一个新进程(新 PID)。复制出来的子进程和父进程代码完全一样。execve():把当前进程的地址空间整个换成另一个程序的镜像,不创建新进程,PID 不变。- 拆开的好处:在
fork之后、exec之前的那一小段,子进程可以自由调整环境(重定向 fd、改信号、改工作目录),再去exec。管道、重定向全靠这一段。
一、fork() 到底做了什么
fork() 复制调用它的那个进程,产生一个新进程。子进程是父进程的一份"快照副本":
| 资源 | fork 后子进程的情况 |
|---|---|
| 地址空间(代码/数据/堆/栈) | 逻辑上是一份独立副本(物理上靠 CoW 共享,见 §二) |
| 打开的文件描述符表 | 复制一份 fd,但指向同一个打开文件表项(共享读写偏移量!) |
| 信号处理函数(handler) | 复制(exec 后会被重置为默认,因为代码没了) |
| 当前工作目录 / umask / 根目录 | 复制 |
| PID | 不同(子进程拿到全新 PID) |
| PPID | 子进程的 PPID = 父进程的 PID |
| 未决信号 / 文件锁 / 定时器 | 不继承(清空) |
一次调用,两次返回
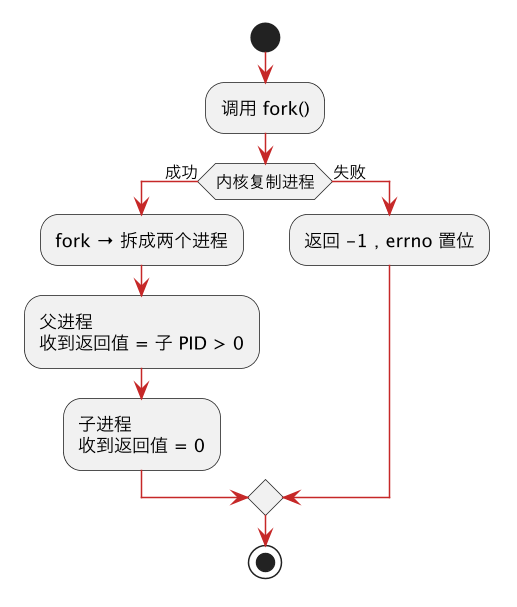
fork() 最反直觉的地方:它被调用一次,却返回两次——在父进程里返回一次,在子进程里也返回一次,靠返回值区分身份:
pid_t pid = fork();
if (pid < 0) {
    // 出错:创建失败(比如进程数超限)
    perror("fork");
} else if (pid == 0) {
    // 子进程:fork 返回 0
    printf("我是子进程, 我的 PID=%d, 父进程=%d\n", getpid(), getppid());
} else {
    // 父进程:fork 返回子进程的 PID
    printf("我是父进程, 我的 PID=%d, 子进程=%d\n", getpid(), pid);
}- 父进程:
fork()返回子进程的 PID(一个正数),这样父亲能知道"我生了谁"。 - 子进程:
fork()返回 0(子进程要找爸爸用getppid()即可,不需要返回值告诉它)。 - 两个进程从
fork()的下一条语句同时开始各自往下跑,谁先跑由内核调度决定(不要假设顺序)。
二、写时复制 Copy-on-Write (CoW) —— fork 为什么这么快
如果 fork() 真的把父进程几百 MB 的内存整块复制一遍,那会又慢又浪费——尤其是子进程 fork 完马上就 exec,复制来的内存转手就被丢掉。
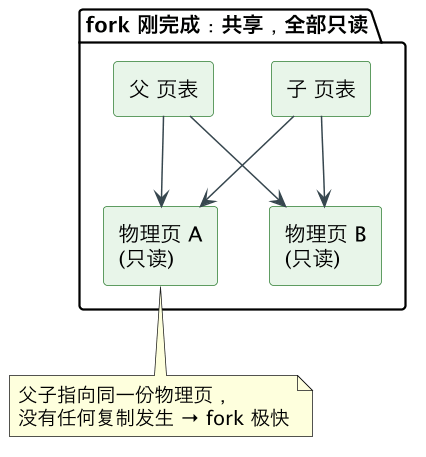
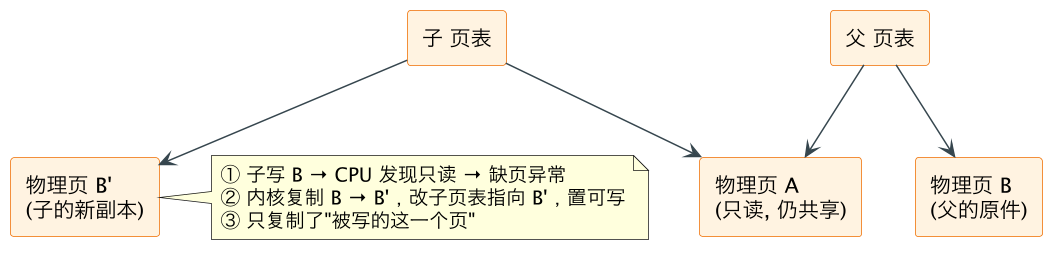
内核的做法:fork 时不复制物理内存,只复制页表,并把父子双方指向的物理页统一标记为只读。谁都不写,就一直共享;谁先写,谁触发缺页异常(page fault),内核这时才真正复制那一个页——这就是 Copy-on-Write。
当子进程写页 B时:
要点:
- fork 的开销从"复制整个地址空间"降到"复制页表 + 标记只读",与进程内存大小几乎无关(只与页表大小相关)。
- fork 后立刻 exec 时几乎零复制:
exec会丢弃整个旧地址空间、装入新镜像,那些共享的只读页从头到尾没被写过,一个都没真复制——白省了。 - 代价:第一次写会有一次缺页 + 复制的开销(延迟到真正需要时才付)。
- 观察:
fork后大量写内存的进程,会看到 minor page fault 飙升(/proc/$PID/stat的min_flt字段,或ps -o min_flt)。
三、fork / vfork / clone 的家族关系
真正的系统调用其实是 clone,fork 和 vfork 都是它的封装。clone 用一组 flags 精细控制"新任务和旧任务共享什么"——共享得越多,就越像"线程";共享得越少,就越像"进程"。
| flag | 含义(置位 = 共享/复用) |
|---|---|
CLONE_VM | 共享地址空间(同一份内存) |
CLONE_FILES | 共享文件描述符表 |
CLONE_FS | 共享文件系统信息(cwd / umask / root) |
CLONE_SIGHAND | 共享信号处理函数表 |
CLONE_THREAD | 归入同一个线程组(同一个 PID,只是 TID 不同) |
于是三者本质上是"给 clone 传不同 flags":
| 创建方式 | 地址空间 | 文件描述符表 | 文件系统信息 | 信号 handler | 典型用途 |
|---|---|---|---|---|---|
| fork | 复制(CoW) | 复制 | 复制 | 复制 | 创建独立进程 |
| vfork | 共享(不复制页表) | 复制 | 复制 | 复制 | 老式"马上要 exec"优化 |
| clone(建线程) | CLONE_VM 共享 | CLONE_FILES 共享 | CLONE_FS 共享 | CLONE_SIGHAND 共享 | 创建线程(pthread) |
一句话记忆:同一个
clone,共享得越多越像线程,越少越像进程。 线程创建的完整机制见 thread-creation。
vfork 的历史与危险
vfork 诞生在没有 CoW 的年代:那时 fork 会实打实地复制整个地址空间,而子进程 fork 完马上 exec,复制纯属浪费。vfork 的优化是——父子直接共享地址空间,且父进程被挂起,直到子进程 exec 或 _exit。
危险也正在这里:
- 子进程和父进程共用同一份内存,子进程若修改变量、
return、或调用除_exit/execve之外的函数,会破坏父进程的栈和状态,行为未定义。 - 所以
vfork后只能立刻execve或_exit,别的什么都不能干。
实战避坑:生产上 fork + waitpid 卡死怎么排查和根治?见 vfork(四类根因 + SICHLD 冲突 + 锁继承死锁 + 根治四方案)。
如今有了 CoW,fork 已经足够快,vfork 基本被淘汰。真要"创建并运行新程序",优先用 posix_spawn:它是 fork+exec 的高层封装(内部可能用 vfork/clone 优化),接口安全、可移植,省去手写 fork 后那段脆弱的代码。
四、exec 家族 —— 换脑,不换身份
execve() 是真正的系统调用(execl/execlp/execvp/... 都是它的库函数封装)。它做的事:用一个新程序的镜像,替换当前进程的整个地址空间。
- 不创建新进程:调用它的进程还是那个进程,PID 不变、打开的 fd 默认继续沿用(除非设了
FD_CLOEXEC)。 - 旧的代码/数据/堆/栈全部被丢弃,换成新程序的段;
exec成功后不再返回(因为返回地址所在的旧代码已经没了),只有失败才返回 -1。 - 信号 handler 被重置为默认(因为处理函数的代码没了),但信号屏蔽字(mask)会保留。
标准姿势:fork + exec
shell 启动一个程序(比如你敲 ls -l)的标准流程就是 fork 出一个自己,再在子进程里 exec 成目标程序,父 shell wait 收尸:
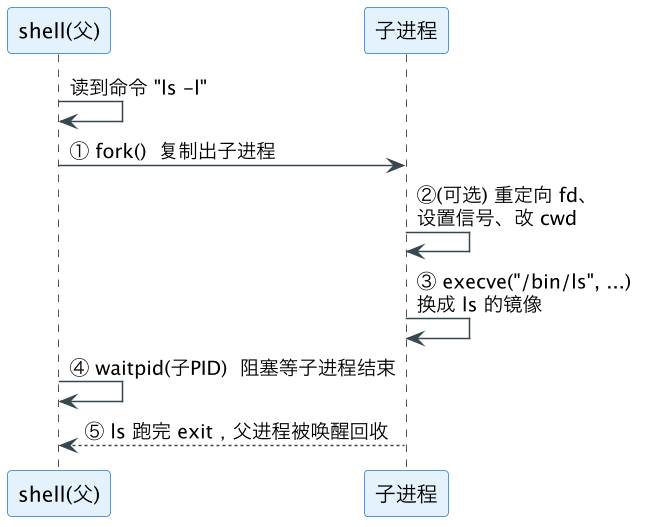
- 第②步是"拆开 fork/exec"的价值所在:管道
a | b、重定向> file,都在这一步用dup2把 fd 接好,再 exec。 execve之后的加载细节(内核映射 ELF、ld.so加载动态库、跳到_start再进main)见 compile-link-load §四;本篇不重复。
五、进程创建后,内核干了什么
以 fork/clone 为例,内核大致按这几步把新进程"搭起来":
- 分配
task_struct:内核里每个进程/线程都对应一个task_struct(进程描述符),复制父进程的大部分字段。 - 分配新 PID:从 PID 分配器领一个空闲号,写入新
task_struct。 - 建立地址空间:复制父进程的
mm_struct和页表,把可写页标记只读以启用 CoW(见 §二);线程则直接共享父的mm_struct。 - 复制/共享其它资源:按 flags 决定文件描述符表、信号表、fs 信息是复制还是共享。
- 设为可运行、加入调度队列:新进程状态置为
TASK_RUNNING,等待调度器挑中。 - 返回用户态:父进程
fork()返回子 PID,子进程从同一处返回 0,两者各自继续执行。
六、观测:看 fork / clone / execve 真的发生了
用 strace -f 跟踪进程创建
-f(follow forks)会跟进 fork/clone 出来的子进程,能看到进程创建的整条链。以在 shell 里跑 ls 为例:
strace -f -e trace=fork,vfork,clone,execve,wait4 -- bash -c 'ls'典型能看到:
clone(child_stack=NULL, flags=CLONE_CHILD_CLEARTID|... ) = 12345   # ← fork 实际调的是 clone
strace: Process 12345 attached
[pid 12345] execve("/bin/ls", ["ls"], 0x... /* 20 vars */) = 0     # ← 子进程换成 ls
[pid 12345] +++ exited with 0 +++
wait4(-1, ...) = 12345                                             # ← 父进程 wait 收尸
注意:现代 glibc 的 fork() 底层调的是 clone,所以 strace 里看到的往往是 clone 而非 fork。strace 的更多用法见 strace。
用 /proc/$PID 看进程状态
cat /proc/$PID/status     # Name/State/Pid/PPid/Threads 等;State 看 R/S/D/Z
cat /proc/$PID/stat       # 单行原始字段:含 min_flt(CoW 缺页次数)、utime/stime
ls  /proc/$PID/fd         # 该进程打开的所有 fd(fork 继承来的能对上号)
cat /proc/$PID/cmdline # exec 进来的程序命令行(看进程"换脑"成了谁)PPid能验证父子关系;父进程先死时子进程会被 init/systemd(PID 1)收养,PPid 变 1。- 子进程退出但父进程没 wait,会变成僵尸进程(Z 状态),ps 里显示
<defunct>。 - 进程异常终止(SIGSEGV/abort)后的现场分析见 core-dump。
七、一句话总结
fork 靠写时复制(只复制页表、标记只读、谁写谁分裂)极快地"复制出一个自己",exec 再原地"换脑"成新程序而不换 PID——fork+exec 就是 Linux 启动一切程序的标准姿势;三者本质都是 clone,共享得越多越像线程、越少越像进程。