sar —— 历史性能数据采集与回看(System Activity Reporter)
这个工具是做什么的
sysstat 套件的核心。前面的工具都是"看当下",一旦问题过去就没了现场。sar 能后台持续把各项指标记到磁盘,让你事后回看"昨天下午 3 点到底发生了什么"。排查偶发/已过去的性能问题,它是唯一能给出现场的工具。
架构:数据从哪里来,到哪里去
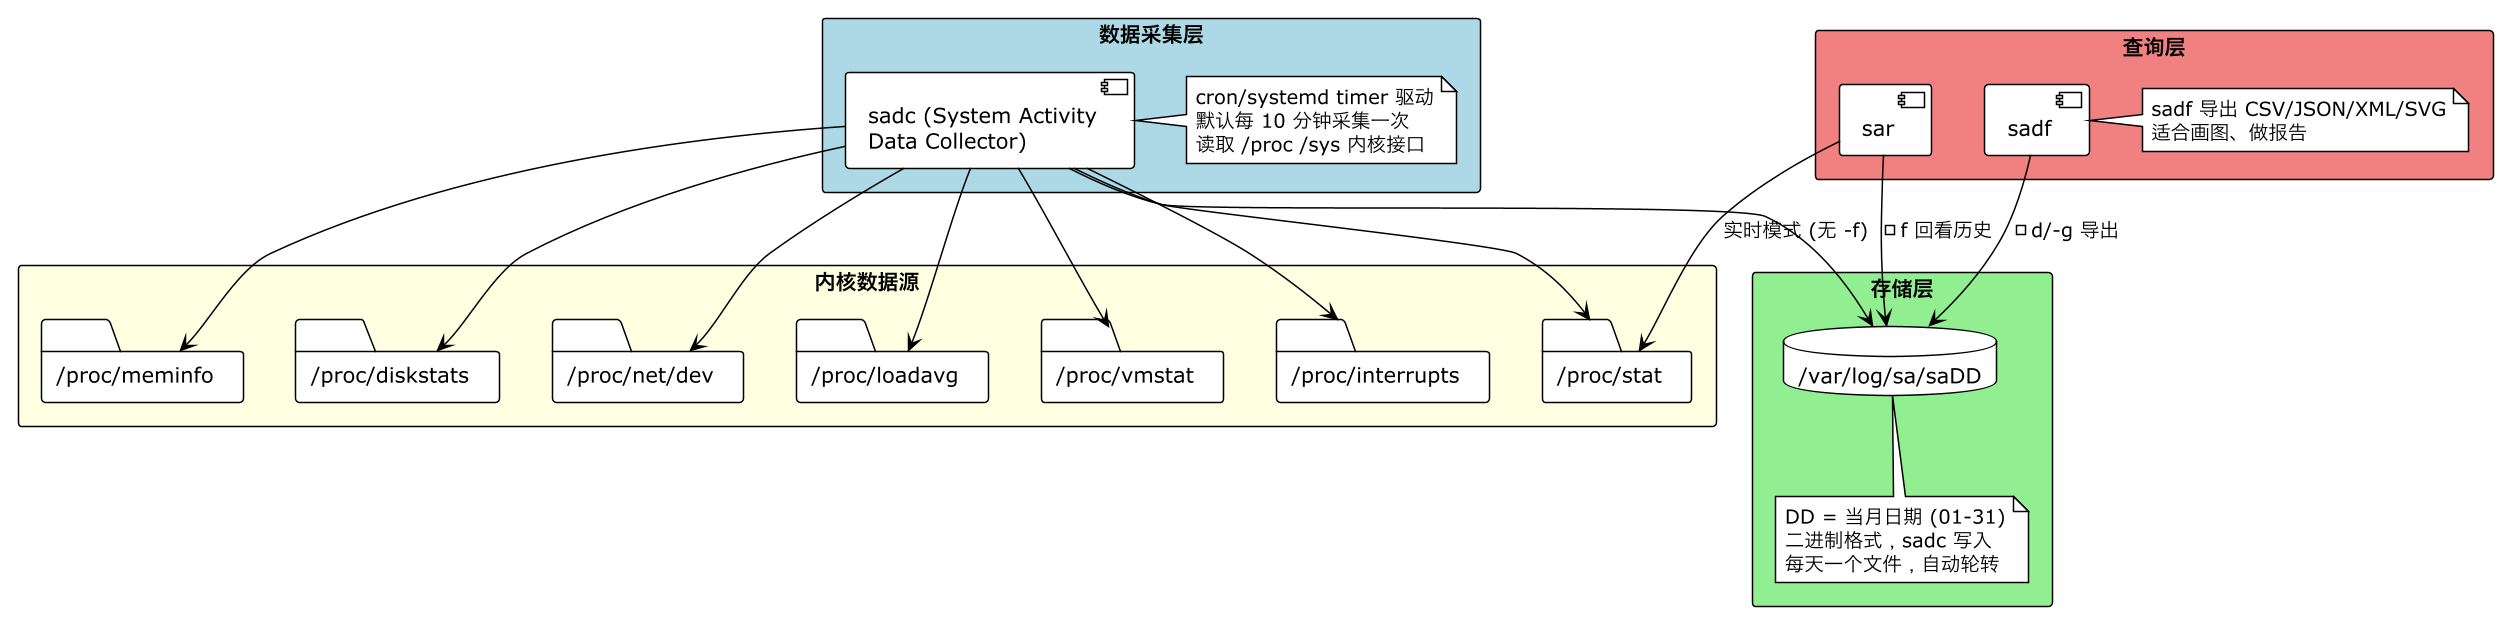
关键特性:
| 特性 | 说明 |
|---|---|
| 事后回看 | 唯一能给"昨天的问题"提供现场的工具 |
| 时间分辨率 | 默认 10 分钟一个采样点,可调为 1~5 分钟 |
| 数据源 | 同其他 sysstat 工具(读 /proc),但由 sadc 后台定时采集落盘 |
| 存储格式 | 二进制 /var/log/sa/saDD,每天一个文件 |
| 数据保留 | 默认保留 7~30 天(由 /etc/sysconfig/sysstat 控制 HISTORY 变量) |
安装与启用
yum install sysstat / apt install sysstat

# 启用后台采集(关键!不开就没有历史文件)
systemctl enable --now sysstat        # 或 sysstat.service + sysstat-collect.timer
采集频率由
/etc/cron.d/sysstat(或 systemd timer)控制,默认约每 10 分钟一个采样点。生产环境建议改为每 5 分钟得到更精细的时间分辨率。
一、全选项速查表
sar 的 -X 选项覆盖了 CPU / 内存 / IO / 网络 / 进程 / NUMA 等几乎全部子系统。以下是完整的选项索引:
| 选项 | 监控对象 | 等价工具 | 一句话 |
|---|---|---|---|
-u | CPU 使用率 | mpstat | %user / %system / %iowait / %steal / %idle |
-u ALL | CPU 细分 | — | 加上 %irq / %soft / %guest / %gnice |
-P ALL | 每核 CPU | mpstat -P ALL | 找单核打满、负载不均 |
-P 0 | 指定核 CPU | mpstat -P 0 | 看特定核(如隔离核)的负载 |
-r | 内存使用 | free | kbmemfree / %memused / kbcommit / %commit |
-r ALL | 内存详细 | — | 加上 kbbuffers / kbcached / kbactive / kbinact |
-R | 内存活动 | — | frmpg/s(释放页速率)、bufpg/s(缓冲页速率) |
-S | swap 空间 | free -s | kbswpfree / %swpused / kbswpcad |
-W | swap 活动 | — | pswpin/s / pswpout/s(换入换出速率) |
-B | 分页/换页 | vmstat | pgpgin/s / pgpgout/s / fault/s / majflt/s |
-b | 整机 IO 速率 | — | tps / rtps / wtps / bread/s / bwrtn/s |
-d | 各磁盘 IO | iostat -x | tps / rkB/s / wkB/s / %util / await / aqu-sz |
-d -p | 各分区 IO | — | 比 -d 多一层分区粒度 |
-n DEV | 网卡流量 | ifstat | rxpck/s / txpck/s / rxkB/s / txkB/s / %ifutil |
-n EDEV | 网卡错误 | — | rxerr/s / txerr/s / rxdrop/s / txdrop/s |
-n TCP | TCP 统计 | netstat -s | active/s / passive/s / 各状态段数 |
-n ETCP | TCP 错误 | — | retrans/s(重传,网络质量核心指标) |
-n SOCK | 套接字数量 | ss -s | totsck / tcpsck / udpsck / rawsck |
-n IP | IP 层统计 | netstat -s | irec/s / fwddg/s / idel/s |
-n ICMP | ICMP 统计 | — | imsg/s / omsg/s / iech/s |
-n UDP | UDP 统计 | — | idgm/s / odgm/s / noport/s |
-n NFS | NFS 客户端 | — | call/s / retrans/s / read/s / write/s |
-q | 负载 + 运行队列 | uptime | runq-sz / plist-sz / ldavg-1/5/15 / blocked |
-w | 上下文切换 | vmstat | cswch/s(自愿)+ proc/s(进程创建速率) |
-v | 内核表 | — | dentunusd / file-nr / inode-nr |
-I | 中断统计 | cat /proc/interrupts | INTR/s 总中断 + 各 IRQ 线 |
-I SUM | 中断汇总 | — | 仅 INTR/s 总计 |
-m | 电源管理 | — | MHz(CPU 频率)/ CPU%(功耗) |
-y | TTY 设备 | — | rcvin/s / xmtin/s |
-Y | NUMA 统计 | — | hit% / miss% / local%(NUMA 命中率,见 NUMA 专题) |
-A | 全部 | — | 一次性输出以上所有指标(数据量极大,不推荐日常用) |
注意:sar 不同版本选项有差异。
sar -h查看当前系统支持的全部选项。-u ALL仅在较新sysstat版本支持。
二、实时采样(用法同其他工具:sar [选项] 间隔 次数)
sar 1 5                   # CPU 总览,每 1 秒共 5 次
sar -u 1                  # CPU 使用率(%user/%system/%iowait/%idle/%steal)
sar -u ALL 1              # CPU 详细分类(含 %irq/%soft/%guest/%gnice)
sar -P ALL 1              # 每个核分别看
sar -P 0,2,4 1            # 只看 0、2、4 号核
sar -r 1                  # 内存使用
sar -S 1                  # swap 空间使用
sar -B 1                  # 换页统计(pgpgin/s、majflt/s、pgscank/s...)
sar -b 1                  # 整机块 IO 速率(tps、读写块/s)
sar -d 1                  # 各磁盘设备 IO(含 %util、await,类 iostat)
sar -n DEV 1              # 网卡流量(收发包/字节/s)
sar -n TCP,ETCP 1         # TCP 主被动连接、重传、错误
sar -n SOCK 1             # 套接字数量(总/TCP/UDP/TIME-WAIT)
sar -w 1                  # 上下文切换速率 + 进程创建速率
sar -q 1                  # 运行队列长度 runq-sz、负载 ldavg-1/5/15
sar -v 1                  # 内核表(inode / dentry / file 使用情况)
sar -I SUM 1              # 中断汇总
sar -Y 1                  # NUMA 本地/远端内存访问命中率
三、回看历史数据(sar 的核心价值)
3.1 基本用法
后台采集的二进制文件在 /var/log/sa/saDD(DD = 当月日期,如 sa15):
sar -u                                  # 回看"今天"的 CPU 历史(整天每个采样点)
sar -u -f /var/log/sa/sa15              # 回看本月 15 号的 CPU
sar -r -f /var/log/sa/sa15              # 回看 15 号内存
sar -d -f /var/log/sa/sa15              # 回看 15 号磁盘
sar -n DEV -f /var/log/sa/sa15          # 回看 15 号网卡
sar -u -s 14:00:00 -e 15:00:00 -f /var/log/sa/sa15   # 只看 15 号 14:00-15:00 这段
sar -u -f /var/log/sa/sa15 -i 1800      # 每 30 分钟取一个点(降采样,看长趋势)
3.2 输出格式解读
12:00:01 AM     CPU     %user     %nice   %system   %iowait    %steal     %idle
12:10:01 AM     all      2.34      0.00      1.12      0.05      0.00     96.49
12:20:01 AM all 3.01 0.00 1.45 0.02 0.00 95.52| 列 | 含义 | 正常范围 | 异常信号 |
|---|---|---|---|
%user | 用户态 CPU(应用程序) | < 80% | 持续 > 90% → 应用 CPU 密集 |
%system | 内核态 CPU(syscall、中断处理) | < 10% | 持续 > 20% → 过多 syscall / 中断风暴 |
%iowait | 等待 IO 的 CPU 空闲比例 | < 5% | 持续 > 10% → 磁盘瓶颈 |
%steal | 被 hypervisor 偷走的 CPU(虚拟化) | ≈ 0% | > 1% → 宿主机 CPU 超卖 |
%idle | 真正空闲 | — | CPU 维度没有瓶颈 |
%iowait的陷阱:%iowait高不一定意味着磁盘慢——它只表示有进程在等 IO 而 CPU 闲着。如果 CPU 同时在跑其他计算,%iowait可能为 0 但磁盘仍然是瓶颈。判断磁盘是否瓶颈,更可靠的指标是-d的%util和await。
四、关键指标深度解读(按子系统)
4.1 CPU(-u / -u ALL / -P ALL / -q)
| 字段 | 含义 | 判据 |
|---|---|---|
%user | 用户态 CPU 占比 | > 90%:应用层 CPU 密集,perf top 找热点函数 |
%system | 内核态 CPU 占比 | > 20%:过多 syscall / 中断,strace -c 统计 syscall 频率 |
%iowait | CPU 空闲等 IO 的时间占比 | > 10%:磁盘/网络 IO 瓶颈,交叉看 -d 和 -n |
%steal | 被 hypervisor 抢占 | > 1%:VM CPU 超卖,联系云平台 |
%irq | 硬中断处理 | 突然暴涨 → 网卡中断风暴,cat /proc/interrupts 看哪条 IRQ |
%soft | 软中断处理 | 和 ksoftirqd 使用率对应,网络收发包主要走软中断 |
%guest | 运行虚拟机的时间 | VM 宿主机的 %guest 包含客户机 CPU |
%idle | 空闲(含 halt 和 mwait) | 该指标不包含 %iowait |
runq-sz | 运行队列长度(就绪+运行) | > CPU 核数 × 2:CPU 饱和 |
ldavg-1 | 1 分钟平均负载 | > CPU 核数:有进程在排队等 CPU |
ldavg-15 | 15 分钟平均负载 | 持续 > CPU 核数:长期 CPU 不足,考虑扩容 |
blocked | D 状态(不可中断睡眠)进程数 | > 0 持续:IO 阻塞(等磁盘/网络),结合 -d -n 检查 |
解读示例:
# 负载高、CPU 空闲也高 → IO 瓶颈
12:00:01 AM   runq-sz   plist-sz   ldavg-1   ldavg-5   ldavg-15   blocked
12:00:01 AM      2        450        8.23      7.91      6.45        3
12:10:01 AM   %user   %system   %iowait   %idle
12:10:01 AM    12.34    3.21     28.45    56.00
→ ldavg-1 = 8.23 >> CPU 核数,但 %user + %system = 15%,%iowait = 28%,blocked = 3。CPU 不忙但负载高 = IO 阻塞。下一步用 sar -d 找慢盘、pidstat -d 找哪个进程。
# 负载高、CPU 也打满 → 纯 CPU 瓶颈
12:00:01 AM   %user   %system   %iowait   %idle
12:00:01 AM    88.12    5.34      0.21     6.33
→ %user = 88%,几乎没 iowait。CPU 是瓶颈,用 perf top / pidstat -u 找罪魁祸首进程。
4.2 内存(-r / -R / -S / -W / -B)
| 字段 | 含义 | 判据 |
|---|---|---|
%memused | 物理内存使用率 | 持续 > 90% 且不回落 → 泄漏或不足 |
%commit | 承诺内存占比(commit/limit) | > 100% → 有 OOM 风险(已承诺的内存超过物理+swap) |
kbbuffers | 裸块设备缓冲区(buffer cache) | 通常较小(几百 MB),过大可能是裸设备 IO |
kbcached | 文件页缓存(page cache) | Linux 会尽可能用空闲内存做缓存,高是正常的 |
kbavail | 无需 swap 即可分配给新进程的内存 | 远小于 kbmemfree 时说明大量内存在 cache 里但可回收 |
%swpused | swap 使用率 | > 0 且持续增长 → 内存压力 |
pswpin/s | 从 swap 换入页速率 | > 0 → 有进程被 swap out 又换入,性能严重受损 |
majflt/s | 主缺页(触发磁盘 IO) | > 10/s → 频繁访盘,可能是 mmap 大文件或内存不够 |
pgscank/s | 内核扫描回收页速率 | > 0 → 内存压力,内核在主动回收 |
pgscand/s | 直接回收页速率 | > 0 → 严重内存压力(内核跳过 kswapd 直接回收) |
pgsteal/s | 实际回收的页速率 | 配合 pgscank/s 看回收效率 |
解读示例:
# 内存泄漏的经典特征
Day 1 09:00: kbmemused=32645820  %memused=50.12  %commit=45.23
Day 2 09:00: kbmemused=39876540  %memused=61.23  %commit=54.88
Day 3 09:00: kbmemused=48102348  %memused=73.87  %commit=68.45
Day 4 09:00: kbmemused=58012344  %memused=89.12  %commit=82.33
Day 5 09:00: kbmemused=62345678  %memused=95.78  %commit=95.12
→ %memused 每天涨 ~10%,从不回落。%commit 同步上涨 → 确认内存泄漏。
4.3 磁盘 IO(-d / -b)
| 字段 | 含义 | 判据 |
|---|---|---|
tps | 每秒 IO 次数(IOPS) | HDD 极限 ~200、SSD 极限 ~50k~500k |
rkB/s / wkB/s | 读写吞吐 | 接近磁盘/RAID 带宽上限则满 |
%util | 设备繁忙时间占比 | > 80% 持续 → IO 饱和(HDD;SSD 可并发,%util 高不一定满) |
await | 单次 IO 平均等待时间(ms) | HDD < 20ms、SSD < 2ms;> 50ms → 磁盘慢 |
aqu-sz | 平均队列长度 | > 1 → IO 堆积 |
areq-sz | 平均请求大小(KB) | 过小 → 小 IO 多(随机读场景);大 → 顺序 IO |
HDD vs SSD 读
%util的区别:HDD 串行,%util = 100%就是物理极限。SSD 多通道并行,%util = 100%时还能继续提 IOPS,应更关注await和aqu-sz。
4.4 网络(-n DEV / -n EDEV / -n TCP,ETCP)
| 字段 | 含义 | 判据 |
|---|---|---|
rxkB/s / txkB/s | 收发带宽 | 接近网卡带宽上限(1Gbps ≈ 125MB/s)则满 |
rxpck/s / txpck/s | 收发包速率(PPS) | PPS 高但带宽不高 → 小包风暴 |
%ifutil | 网卡利用率 | > 80% → 接近带宽上限 |
rxerr/s / txerr/s | 收发错误 | 非零且增长 → 网线/网卡/驱动问题 |
rxdrop/s | 接收丢包 | 持续 > 0 → 网卡 ring buffer 溢出,增大 net.core.rmem_max |
active/s | 主动建连(connect()) | 突然暴涨 → 可能是连接风暴 |
passive/s | 被动建连(accept()) | 正常服务端应该值为正 |
retrans/s | TCP 重传段数/s | > 1% of 发包量 → 网络质量差或拥塞 |
totsck | 总套接字数 | 接近 fs.file-max → socket 耗尽风险 |
解读示例:
# TCP 重传率异常
12:00:01 AM   active/s  passive/s   retrans/s
12:00:01 AM    45.23     120.45       38.12    ← 重传/发包 ≈ 23%!严重丢包
12:10:01 AM    42.11     115.67        0.23    ← 恢复正常
→ retrans/s = 38 而 active + passive ≈ 166,重传率 ~23%。不可能是因为拥塞控制——重传率 > 2% 通常就是物理丢包。检查 sar -n EDEV 看 rxdrop/s 和 rxerr/s。
# 小包风暴(DDoS / 优化不当)
12:00:01 AM   rxpck/s   txpck/s    rxkB/s    txkB/s
12:00:01 AM   850234    14523      12.34     3.45
→ rxpck/s = 850k 但 rxkB/s = 12MB/s → 平均包大小 ~15 字节。小包风暴。网卡 PPS 上限 ~1M pps(千兆环境),850k 已经很危险。
4.5 进程与上下文切换(-w / -v)
| 字段 | 含义 | 判据 |
|---|---|---|
proc/s | 每秒创建的进程数 | > 1000/s → fork 风暴(可能是脚本/内核 bug) |
cswch/s | 自愿上下文切换(等资源主动让出) | 高说明进程频繁等锁/IO/信号量 |
dentunusd | 未使用的 dentry 缓存项 | 值持续增长 → 大量文件被缓存但未释放 |
file-nr | 已打开文件数 | 接近 fs.file-max → 文件描述符耗尽 |
inode-nr | 已分配 inode 数 | 接近上限 → inode 耗尽(小文件太多) |
4.6 NUMA(-Y)
| 字段 | 含义 | 判据 |
|---|---|---|
hit% | NUMA 本地节点命中率 | > 99% 正常;< 95% → 跨 NUMA 访存严重 |
miss% | 跨节点访问比例 | > 5% → 内存分布不均衡,考虑 numactl 绑定 |
local% | 本节点分配的内存被本节点 CPU 访问 | > 99% 正常 |
foreign% | 本节点内存被远端 CPU 访问 | > 5% → 进程被调度到远端 NUMA 节点 |
详见 NUMA 基础。
五、典型排查场景
5.1 偶发卡顿事后复盘
# Step 1:找异常时刻
sar -q -f /var/log/sa/sa15 -s 14:00 -e 16:00
  → 看 runq-sz / blocked / ldavg-1 哪个时间点突变

# Step 2:在异常时刻交叉验证
sar -u -f /var/log/sa/sa15 -s 14:20 -e 14:40
  → %iowait 高?%system 高?%steal 高?

# Step 3:根据上一步结果下钻
sar -d -f /var/log/sa/sa15 -s 14:20 -e 14:40    # 如果 %iowait 高
sar -n DEV -f /var/log/sa/sa15 -s 14:20 -e 14:40 # 如果可能网络有关
sar -B -f /var/log/sa/sa15 -s 14:20 -e 14:40     # 如果可能内存压力
5.2 内存泄漏趋势判断
# 连续几天同一时段的 %memused
for d in sa15 sa14 sa13; do
    echo "=== Day: $d ==="
    sar -r -f /var/log/sa/$d -s 09:00 -e 10:00 | tail -1
done
# 若 %memused 逐日递增且从不回落 → 内存泄漏

# 也可以导出 CSV 画图
sadf -d /var/log/sa/sa14 -- -r > mem_14.csv
5.3 容量规划
# 长期看高峰 CPU 使用率和负载
sar -u -f /var/log/sa/sa15
  → 找 %idle 最低的时段
    → 高峰 %idle < 10% → CPU 接近瓶颈
sar -q -f /var/log/sa/sa15
  → 找 ldavg-1 最高的时段
    → 持续 > 核数 → 需要考虑扩容

# 磁盘容量
sar -d -f /var/log/sa/sa15 | grep sda
  → 找 %util 和 await 最高的时段
    → %util > 80% 且 await > 20ms → 磁盘是瓶颈
5.4 网络问题回看
# 流量是否打满
sar -n DEV -f /var/log/sa/sa15 -s 14:00 -e 15:00
  → rxkB/s + txkB/s 是否接近网卡带宽上限

# 丢包/重传
sar -n EDEV -f /var/log/sa/sa15
  → rxdrop/s > 0 → 网卡 ring buffer 溢出
sar -n ETCP -f /var/log/sa/sa15
  → retrans/s > 发包量的 1% → 网络链路质量问题

# 连接数是否异常
sar -n TCP -f /var/log/sa/sa15 | grep TIME-WAIT
  → TIME-WAIT 暴增 → 短连接过多,调 `net.ipv4.tcp_tw_reuse`
5.5 NUMA 调度问题
sar -Y -f /var/log/sa/sa15 -s 14:00 -e 15:00
  → miss% > 5% → 内存跨 NUMA 节点
    解决:numactl --cpunodebind=0 --membind=0 ./myapp
六、导出与画图
sadf -d /var/log/sa/sa15 -- -u > cpu.csv            # CSV 格式,Excel/gnuplot 可读
sadf -j /var/log/sa/sa15 -- -u > cpu.json           # JSON 格式
sadf -x /var/log/sa/sa15 -- -u > cpu.xml            # XML 格式
sadf -g /var/log/sa/sa15 -- -u > cpu.svg            # 直接出 SVG 图(部分版本支持)
sadf -d /var/log/sa/sa15 -- -r -s 14:00 -e 15:00 > mem.csv  # 筛选时间段导出
也可用 kSar(Java GUI 工具)打开 sar 文本/二进制文件,生成漂亮的趋势图,适合做周报月报。
七、与其他工具的协作
| 场景 | 第一步(sar 回看) | 第二步(实时工具复现/下钻) |
|---|---|---|
| CPU 高 | sar -u -q 确定时段 + 大类 | perf top / pidstat -u 找进程/函数 |
| 内存泄漏 | sar -r 多天趋势 | pmap -x <PID> 看进程 / valgrind --leak-check=full |
| 磁盘慢 | sar -d 找慢盘 + 时段 | iostat -x 1 实时看 / iotop 找进程 / pidstat -d |
| 网络丢包 | sar -n ETCP 看重传率 | ss -ti 看连接级重传 / tcpdump 抓包 |
| 上下文切换高 | sar -w 看 cswch/s | pidstat -w 找切换最多的进程 / vmstat 1 |
| NUMA 远端访问 | sar -Y 看 miss% | numastat -p <PID> 看进程级 NUMA 分布 |
八、常见陷阱
| 陷阱 | 说明 |
|---|---|
| 没开后台采集 | systemctl status sysstat 确认服务 running;没开就没有 /var/log/sa/sa* |
| 默认 10 分钟太粗 | 10 分钟的尖峰可能被平均掉;排查突发问题改为 1~2 分钟 |
%iowait 不是磁盘瓶颈的唯一判据 | 多核环境下即使 %iowait = 0,磁盘仍可能打满(其他核在跑计算) |
SSD 磁盘 %util = 100% 不代表满 | SSD 多通道并行,%util 到 100% 时 IOPS 还能继续提 |
kbcached 高不是问题 | Linux 主动把空闲内存用作 page cache,需要时自动回收 |
| 历史文件被清理 | /etc/sysconfig/sysstat 的 HISTORY 控制保留天数,查不到数据可能是过期了 |
虚拟机 %steal | 虚拟化环境中 %steal > 0 说明宿主机 CPU 超卖,不是你程序的问题 |
九、交叉引用
- CPU 实时工具:top / mpstat / pidstat
- 上下文切换:vmstat 判据 + 调度观测
- 磁盘 IO 实时工具:iostat(sar -d 的同源工具)
- 内存实时工具:free(sar -r 的同源工具)
- 网络实时工具:ss(sar -n TCP/SOCK 的同源工具)
- 底层数据源:procfs(sar 底层读
/proc) - NUMA 基础:NUMA 概念
一句话总结:
sar是唯一能"事后回看"历史性能数据的工具——先用sar -q/-u找异常时刻、用-r/-d/-n交叉验证瓶颈子系统、再用实时工具(perf/pidstat/iostat)下钻到进程和函数;排查"昨天下午突然卡了 5 分钟"这类偶发问题,没有sar就没有现场。