案例二:对照实验 make release (-O2) 后的 perf stat 深度解读
紧跟 案例一 的对照实验,展示同一个程序从
-O0到-O2的数字巨变。读完本节,你会看到"高效"的表象——然后进入 案例三 发现同样的表象竟然是:u陷阱伪造的。
上一节给的是默认 make 产物的"对照组"数据(-O0 -g,本节叫 Debug 版)。本节把构建命令换成 make release(-O2 -g,叫 Release 版)再跑一次 perf stat,跟上一节数据逐字段对比——很多数字会让人意外地往相反方向走,但每个反常都能精确归因。
2.1 实验设置差异
| 项 | Debug 版 (案例一) | Release 版 (本节) |
|---|---|---|
| Makefile 目标 | make (默认) | make release |
| 编译参数 | -O0 -g -std=c++17 | -O2 -g -std=c++17 |
| 源码 | 同一份 demos/cpu-demo/main.cpp | 同一份 demos/cpu-demo/main.cpp |
| 场景 | 模式 1 (busy_user_cpu) | 模式 1 (busy_user_cpu) |
| 目标 PID | 3482 | 8929 |
| 采样窗口 | 3 s | 3 s |
唯一变量:优化等级。源码、机器、运行时负载、采样窗口都保持一致。
2.2 Release 版原始 perf stat 输出
[<user>@demo-lab perf]$ perf stat -p 8929 -- sleep 3
 Performance counter stats for process id '8929':
     2,997.61 msec task-clock:u          #    0.990 CPUs utilized
             0      context-switches:u    #    0.000 K/sec
             0      cpu-migrations:u      #    0.000 K/sec
             0      page-faults:u         #    0.000 K/sec
   2,546,077,721      cycles:u           #    0.849 GHz
    4,272,852,608      instructions:u     #    1.68  insn per cycle
      953,529,848      branches:u         #  318.096 M/sec
        21,772      branch-misses:u       #    0.00% of all branches
       3.028330593 seconds time elapsed
2.3 逐项对比:Debug vs Release
| # | 指标 | Debug (-O0) | Release (-O2) | 差值 | 倍数 | 解读方向 |
|---|---|---|---|---|---|---|
| 1 | task-clock (ms) | 3,024.12 | 2,997.61 | -26.5 | 0.99× | 几乎不变(都被 sleep 3 框定) |
| 2 | CPUs utilized | 1.004 | 0.990 | -0.014 | ≈ | 仍占满单核 |
| 3 | context-switches | 0 | 0 | 0 | — | 单任务独占,都未切换 |
| 4 | cpu-migrations | 0 | 0 | 0 | — | 钉在同核 |
| 5 | page-faults | 0 | 0 | 0 | — | 不触发缺页 |
| 6 | cycles | 12,047,315,514 | 2,546,077,721 | -9,501,237,793 | 0.21× | 总工作量降到 1/4.7 |
| 7 | CPU 频率 | 3.984 GHz | 0.849 GHz | -3.135 | 0.21× | P-state 自动降频 |
| 8 | instructions | 7,340,204,487 | 4,272,852,608 | -3,067,351,879 | 0.58× | 编译器把指令数砍掉 42% |
| 9 | IPC | 0.61 | 1.68 | +1.07 | 2.75× | 每周期做的事多了 2.75 倍 |
| 10 | branches | 2,446,709,897 | 953,529,848 | -1,493,180,049 | 0.39× | 分支数减半多(循环展开 / 强度削减) |
| 11 | branch-misses(绝对) | 4,455 | 21,772 | +17,317 | 4.89× | miss 绝对值变多,但 % 仍 ≈ 0 |
| 12 | branch-misses % | 0.000182% | 0.002283% | +0.0021% | 12.5× | 仍远低于 5% 阈值,显示 0.00% |
| 13 | elapsed (s) | 3.012 | 3.028 | +0.016 | 1.005× | 墙上时间几乎不变 |
这些指标背后的微架构原理:上表中 IPC、cycles、分支预测率的变化,本质是 CPU 流水线、超标量、乱序执行、分支预测器在不同代码形态下的表现差异。要真正读懂这些数字,需要理解 CPU 核内部的演进链条——本仓库已有完整文档体系:
上表中的指标 涉及的微架构概念 原理文档 IPC(每周期指令数) 流水线阶段重叠 → 超标量五级加宽 → 乱序执行找 ILP IPC 瓶颈篇:IPC = min(取指、译码、发射、执行、退休并行度、ILP) cycles 暴跌 4.7× -O2后指令精简 + CPU 自动降频,每条指令周期消耗变化乱序执行:少指令 = 少依赖 = 保留站更容易填满执行端口 branch-misses % ≈ 0 分支预测器对"循环计数"模式近乎 100% 命中 分支预测:TAGE/感知器预测器能学到"循环 N 次→跳出"的规律 为何 IPC=1.68 仍远低于理论 4~6 循环体太小(<4 条指令)、数据依赖紧,无法充分利用宽流水 IPC 瓶颈篇:取指喂不饱、发射喂不饱、18 个单元只用 1 个
2.4 四大反直觉发现:为什么 Release 数字会"全面缩水"
2.4.1 CPU 频率从 3.98 GHz 跌到 0.85 GHz(P-state 自动降频)
最直观的反常:Release 版 CPU 频率只剩 Debug 版的 21%(0.85 / 3.98)。这不是"性能变差",恰恰相反——这是好事。
先澄清一个关键前提:perf stat -p 8929 -- sleep 3 中的 3 秒是观测窗口时长,不是程序只跑了 3 秒。程序是 while(true) 死循环,perf 只是在这 3 秒内采集计数器——3 秒到了 perf 收工,但程序本身一直在跑。
| 现象 | 解释 |
|---|---|
| 0.85 GHz 是基频之下 | 现代 CPU(Intel Skylake 之后)在轻负载下会进入 P-state C0 低频档(0.8~1.2 GHz),由 intel_pstate 驱动或 acpi-cpufreq 的 powersave governor 调度 |
| 任务太轻,CPU 太闲 | 编译器把循环体压到只剩"加 1 + 比较"两条指令,3 秒内需要执行的工作量 < 1 GHz 就能轻松跑完 |
| 频率低 ≠ 慢 | "低频"只是用不上那么高。如果工作突增,governor 会在 100~200 μs 内把频率拉回去 |
| 对比 Debug 版 3.98 GHz | Debug 版每个循环要做 4~6 条指令(访存 + 加法),需要高频才能维持 100% CPU 占用 |
真正的问题是:O2 后流水线"流畅但空转",高频对吞吐毫无帮助,所以 governor 主动降频。
Debug(O0) @ 3.98 GHz:                    Release(O2) @ 0.85 GHz:
┌──┬──┬──┬──┬──┬──┬──┬──┐               ┌──┬──┬──┬──┬──┬──┬──┬──┐
│LD│ST│ADD│LD│ST│LD│ST│JM│ ← 每拍几乎     │  │  │  │i++│  │  │  │ ← 每拍大部分空着
│  │  │  │  │  │  │  │P │    满管          │  │  │  │cmp│  │  │  │   (IPC=1.68, 但理论
│  │  │  │  │  │  │  │  │                  │  │  │  │jne│  │  │  │    最大 4~6)
└──┴──┴──┴──┴──┴──┴──┴──┘               └──┴──┴──┴──┴──┴──┴──┴──┘
 AGU 满、ALU 部分忙                       无 cache miss、无 branch mispredict、
 → 必须高频才能跑完                        流水线极其"干净",但 i++→cmp→jne
                                          三条 RAW 串成一条链,每拍只能出 1 条 µop
                                          → 18 个执行单元空了 17 个
**Debug 版流水线"脏而忙" **:load/store 风暴堵住了 AGU,流水线虽然 IPC 低(0.61),但每个端口都在拼命干活——必须靠 3.98 GHz 高频才能扛住 4 次访存/轮。
**Release 版流水线"净而空" **:O2 把 load/store 全删了(sum 被 DCE 删除、i 留在寄存器),没有 cache miss、没有 branch mispredict、没有端口冲突——流水线极其流畅。但 i++ → i<N → jmp 三条指令串成 RAW 依赖链,ILP 几乎为零,发射级永远只出一条 µop。18 个执行单元只用了 1 个 ALU,其余 17 个在发呆。CPU governor 检测到:
"核内利用率极低——18 个执行单元只用 1 个,跑 3.98 GHz 也好、0.85 GHz 也好,被依赖链限定了每拍只能出 1 条 µop,高频只是多出几亿个空泡,对吞吐毫无帮助 → 降到 0.85 GHz 省电。"
于是频率降到了基频之下,但程序的吞吐不受影响——因为瓶颈在 ILP,不在频率。
教学点:cycles 减少 ≠ 程序变慢;真正衡量"程序变快"的是 wall-clock time。Release 版 cycles 少了 4.7 倍,但做的工作也少了 4.7 倍,因此墙上时间不变。这对死循环来说是"无所谓",对真实业务代码则是"显著加速"。
2.4.2 IPC 从 0.61 升到 1.68,但仍未到 4.0(流水线喂不饱)
Release 版 IPC 提升了 2.75 倍,听起来很美。但 1.68 仍远低于现代 x86 的理论上限 4~6,为什么?
前置原理 ①:理解 IPC 需要先明白 CPU 核内超标量架构的五个加宽点——取指(4~6 条/拍)、译码(4~6 µop/拍)、发射(INT 4 + FP 4 µop/拍)、执行(18 个单元)、退休(4~8 µop/拍)——以及各自的限制条件(详见 IPC 瓶颈篇)。
前置原理 ②:ILP(Instruction-Level Parallelism,指令级并行)= 一段代码中,有多少条指令可以同时执行而互不等待。
ILP 高的代码                          ILP 低的代码(mode1 O2 后就是这种情况)
  a = x + 1     ← 不依赖 b、c         i = i + 1     ← i++ 的结果…
  b = y + 2     ← 不依赖 a、c         if i < 10M    ← …是这条的输入…
  c = z + 3     ← 不依赖 a、b         goto loop     ← …必须等判断结果
    ↑                                  ↑
  三条互不依赖,同一拍发射                 三条 RAW 串成一条,每拍只能出 1 条
  IPC 可达 3                            IPC 上限 = 1
超标量 CPU 有 4~6 个发射口、18 个执行单元,但能不能用满,取决于代码里有没有足够多互不依赖的指令可喂。ILP 低 = 依赖链紧 = 硬件再宽也是空等。本节 Release 版的问题本质就是 ILP 太低——
i++ → i<N → jmp三条指令串成 RAW 依赖链,发射级永远只出一条 µop,18 个执行单元空转 17 个。
从五个加宽点诊断 IPC 1.68:
| 加宽点 | 理论并行度 | IPC 1.68 时的状态 |
|---|---|---|
| 取指 | 4~6 条/拍 | ⚠️ 部分受限——循环体只剩 ~3 条指令,每次循环回跳打断连续取指,前端实际取指吞吐 ≈ 2 条/拍 |
| 译码 | 4~6 µop/拍 | ✅ 不卡——add/cmp/jne 都是简单指令,1:1 译码 |
| 发射 | INT 4 条/拍 | 🔴 主瓶颈——i++ 和 i<N 之间是 RAW 依赖链,保留站里操作数就绪的 µop 极少,无法填满发射端口 |
| 执行 | 18 个单元 | 🔴 严重空转——8 个 ALU 只用 1 个,4 个 FMA + 4 个 SIMD ALU + 2 个分支单元全部闲置。18 个执行单元只用了 1 个 |
| 退休 | 4~8 µop/拍 | ✅ 不卡——可退休的 µop 太少 |
| 限制因素 | 解释 | 关联的微架构概念 |
|---|---|---|
| 循环体太小,前端解码追不上 | Release 版把 sum += i 优化后,每轮只剩 ~1 条加法 + 1 条比较 + 1 条分支,< 4 条。现代 CPU 前端每周期最多取指/译码 4~6 条宏指令,这么小的循环根本填不满流水线 | 超标量宽度:取指/译码宽度固定,循环 < 宽度 → 硬件空转 |
| 数据依赖链紧 | i = i + 1 跟 i < 10000000 之间是 RAW 依赖,加法结果要被比较用,串行依赖无法 overlap | 数据冒险:转发/bypass 能减延迟但消不掉依赖,乱序执行也绕不开 |
sum += i 还可能被强度削减或删除 | 若编译器判定 sum 是 dead store(后续没人读),可能直接把整个加法删掉——此时循环退化为 i++ + i<N + branch,只剩 3 条指令 | 重命名与顺序退休:编译器消除伪依赖,但真依赖(RAW)仍在 |
| 单一 ALU 利用 | 简单整型加法只走 1 个 ALU 端口,SIMD/浮点/load 单元全部空转 | 执行端口专业化:超标量端口各司其职,整数加只占 1/18 执行单元 |
微架构诊断:IPC 1.68 的瓶颈跟案例一 1.4.2 的 IPC 0.61 完全不同——0.61 是
-O0的 load/store 风暴堵住了 LSU AGU;1.68 是-O2优化后循环体缩到 3 条指令、依赖链紧到发射层喂不饱端口、18 个执行单元只用了 1 个。从"访存瓶颈"变成了"ILP 瓶颈"——CPU 更宽了没变,是代码喂给它的并行度太低了。
教学点:IPC 不是"越高越好"的孤立指标——它跟"工作量"配对才有意义。Release 版 IPC 高 2.75× 同时 cycles 少 4.7×,意味着每单位时间做的工作几乎没变(2.75/4.7 ≈ 0.58, 实际上 Release 版每秒做的事比 Debug 版少 42%)。
2.4.3 cycles 跌 4.7 倍:编译器到底删了什么?
Debug 版 12 G 周期 → Release 版 2.5 G 周期,省下来的 9.5 G 周期去了哪里?
| 编译器优化 | 估算省下的 cycles | 原理 |
|---|---|---|
sum 寄存器化 | ~3 G | -O0 强制 sum 走栈,每轮 2 次访存(load/store);-O2 把 sum 留在寄存器(可能只留 i 在寄存器,sum 直接被消除) |
| 死代码消除(DCE) | ~3 G | sum 只写不读 → 整个 sum += i 被 GCC 判定为可删除副作用,直接整条 add 指令消失 |
| 循环强度削减 / 不变代码外提 | ~2 G | i++ 和 i < 10000000 可能被改写成更紧凑的形式(指针递增、bound 寄存器缓存) |
| 分支优化 | ~1 G | 循环条件从"每次比较 10000000"变成"递减到 0 后再装回"或展开若干轮,减少比较次数 |
| 其他(对齐、调度、ICache 命中) | ~0.5 G | 函数入口对齐、循环体布局让 ICache 命中率上升 |
最关键的一点:
-O2看到sum是局部变量、函数内不被读取、退出前也没人用 → DCE 把sum += i整个删除。这是 Makefile 注释里写的"教学点"——你可以用objdump -d cpu_demo对比两个版本,Release 版的内循环大概率只剩 3~4 条指令。
2.4.4 wall-clock 时间几乎不变(3.012 s vs 3.028 s)
看似矛盾——CPU 频率降了 4.7 倍,cycles 少了 4.7 倍,IPC 高 2.75 倍——为什么总时间不变?
答案:这个程序是 while(true) { ... },永不停下。perf stat -- sleep 3 只是采样窗口 3 秒,程序在这 3 秒里做的工作量是 "循环迭代次数" 决定的,跟"每次迭代花多少周期"无关。
- Debug 版:3 秒内循环跑 ~100M 次 × 每次 ~120 周期 = 12 G 周期 @ 3.98 GHz
- Release 版:3 秒内循环跑 ~100M 次 × 每次 ~25 周期 = 2.5 G 周期 @ 0.85 GHz
两者每秒都跑了 100M/3 ≈ 3300 万次迭代,所以墙上时间一样。如果是一个"做完就退出"的程序(比如 for(int i=0; i<N; i++) sum += i; 跑完就停),Release 版会显著更快。
教学点:CPU-bound 的死循环不是衡量"性能提升"的好样本——它的时间永远等于 sleep 时长。要看"加速比",需要有限工作量的基准测试(SPEC CPU、sysbench、google-bench),或加一个
std::chrono::steady_clock计时的 for 循环,跑 N 千万次后退出。
2.4.5 汇编级验证:O0 vs O2 的 disassembly 逐行对照
前面 §2.4.1~§2.4.4 从 perf 数据层面分析了 4 大数据差异。本节用 objdump -d 做底层验证——把 busy_user_cpu() 在两种编译模式下的汇编指令逐行对比,看 sum/i 究竟落在了哪里,把上一节的 perf 数字跟真实的机器指令对上。
O0 模式(节选自 objdump -d cpu_demo)
; -O0 -g 编译:sum / i 全部 spill 到栈
00000000004027e0 <_Z14busy_user_cpuPv>:
    4027e0:  55                push   %rbp
    4027e1:  48 89 e5          mov    %rsp, %rbp
    4027e4:  48 83 ec 10       sub    $0x10, %rsp          ; 分配 16 字节栈帧
    4027e8:  c7 45 fc 00 00 00 00  movl $0, -0x4(%rbp)   ; sum = 0 (32-bit spill)
    4027ef:  c7 45 f8 00 00 00 00  movl $0, -0x8(%rbp)   ; i = 0
    4027f6:  eb 10                jmp    402808 <_Z14busy_user_cpuPv+0x28>
    ; ---- 循环体开始 ----
    4027f8:  8b 45 f8             mov    -0x8(%rbp), %eax  ; ① load i → eax
    4027fb:  8b 4d fc             mov    -0x4(%rbp), %ecx  ; ② load sum → ecx
    4027fe:  01 c8                add    %ecx, %eax        ; ③ eax = sum + i
    402800:  89 45 fc             mov    %eax, -0x4(%rbp)   ; ④ store sum
    402803:  48 83 45 f8 01       addq   $1, -0x8(%rbp)     ; ⑤ i++ (load-modify-store)
    ; ---- 循环体结束 ----
    402808:  81 7d f8 80 96 98 00 cmpl $0x989680, -0x8(%rbp)  ; ⑥ i < 10000000?
    40280f:  76 e7                jbe    4027f8 <_Z14busy_user_cpuPv+0x18>
    402811:  eb fe                jmp    402811               ; 死循环
402813: 0f 1f 00 nop逐条计数(单次循环体:5 个 µop,4 次访存 + 1 次 ALU):
- ①
mov -0x8(%rbp), %eax— load i - ②
mov -0x4(%rbp), %ecx— load sum - ③
add %ecx, %eax— ALU - ④
mov %eax, -0x4(%rbp)— store sum - ⑤
addq $1, -0x8(%rbp)— load-modify-store i - ⑥
cmpl + jbe— 条件分支(预测正确,免费)
O2 模式(节选自 objdump -d cpu_demo.release)
; -O2 编译:sum / i 全部留在寄存器,内层循环仅 2 条指令
00000000004028dd <_Z14busy_user_cpuPv>:
    4028dd:  f3 0f 1e fa          endbr64
    4028e1:  55                   push   %rbp
    4028e2:  48 89 e5             mov    %rsp, %rbp
    4028e5:  53                   push   %rbx
    4028e6:  48 83 ec 08          sub    $0x8, %rsp
    4028ea:  bb 00 00 00 00       mov    $0, %ebx        ; sum → 寄存器 ebx
    4028ef:  41 bc 00 00 00 00    mov    $0, %r12d       ; i   → 寄存器 r12d
    4028f6:  eb 05                jmp    4028fd
    ; ---- 循环体开始(2 条指令) ----
    4028f8:  41 8d 1c 24          lea    (%r12,%rbx), %ebx  ; ① sum += i (纯寄存器)
    4028fc:  41 ff c4             inc    %r12d              ; ② i++ (寄存器自增)
    ; ---- 循环体结束 ----
    4028ff:  41 81 fc 80 96 98 00 cmp    $0x989680, %r12d  ; ③ i < 10000000?
    402906:  7e f0                jle    4028f8
    402908:  90                   nop
    402909:  48 8b 5d f8          mov    -0x8(%rbp), %rbx
    40290d:  c9                   leave
40290e: c3 ret逐条计数(单次循环体:2 条指令,0 次访存,2 次 ALU):
- ①
lea (%r12, %rbx), %ebx— sum += i(纯寄存器,0 访存) - ②
inc %r12d— i++(寄存器自增,0 访存) - ③
cmp + jle— 条件分支
聚焦核心指令: lea (%r12,%rbx), %ebx 在流水线上怎么跑?
这是 O2 循环体的心脏指令——它一条指令完成了 sum + i → sum 的加法和赋值,且只花 1 个 cycle(假设 L1 I-Cache 命中)。下面按标准 5 级流水线(取指 / 译码 / 发射 / 执行 / 退休)逐级剖析,并与 O0 的等效路径做对比。
第 1 级 → 取指(Fetch)
I-Cache lookup: 虚拟地址 0x4028f8 → tag match
命中: 16 字节 cache line 读出,包含 41 8d 1c 24 (4 字节)
→ 1 个 cycle,免费(循环体只有 ~6 字节,I-Cache 第一轮就全部命中)
对比 O0:O0 循环体 ~15 字节,也命中了 I-Cache——取指这里 O0 没吃亏。问题在后面。
第 2 级 → 译码(Decode)
4 字节机器码: 41 8d 1c 24 → 解码器输出 1 个 µop:
  µop: LEA_32  r12, rbx → ebx
        │       │    │      └── destination: 32-bit register eax/ebx/ecx/edx
        │       │    └──────── src2: rbx (sum,已在寄存器,无等待)
        │       └───────────── src1: r12 (i,已在寄存器,无等待)
        └───────────────────── 操作: src1 + src2 → dst(纯加法,无内存地址计算)
关键:lea 虽然语法写的是内存寻址形式 (%r12,%rbx),
     但 CPU 的译码器看到 LEA 前缀,直接把它译成 1 个纯 ALU µop
     → 不进 AGU 端口,不走 load/store 流水线!
对比 O0:O0 需要对 5 条 x86 指令分别译码 → 5 个 µop(2 load + 1 ALU + 2 store),译码队列压力是 O2 的 5 倍。
第 3 级 → 发射(Issue) — 这是核心差异所在
µop 进入保留站(RS)后,调度器要做一件事:检查所有源操作数是否就绪(ready)。
┌─────────────────── 保留站(RS) ───────────────────┐
│                                                    │
│  LEA_32  r12, rbx → ebx    [等待发射]              │
│           ↓     ↓                                   │
│         r12=?  rbx=?                                │
│                                                    │
│  检查物理寄存器文件(PRF):                           │
│    r12 → 物理寄存器 P27 → 上一条 inc 已写完,就绪    │
│    rbx → 物理寄存器 P14 → 上轮循环的 lea 已写完,就绪│
│                                                    │
│  判断: 两个操作数都已就绪,立即发射!                 │
│  → 从进入保留站到发射: 0 cycle 等待!               │
└────────────────────────────────────────────────────┘
为什么能 0 等待? 因为 sum(rbx)和 i(r12)都在寄存器文件里,不是从内存 load 的——没有"load-to-use"延迟(通常 4~5 cycle)。
对比 O0 的灾难:
O0 的 add %ecx, %eax 进入保留站时:
  ecx 的值来自 ② mov -0x4(%rbp), %ecx (刚发射,还在 L1 DCache ≈ 4 cycle 后才完成)
  eax 的值来自 ① mov -0x8(%rbp), %eax (同上)
  → 调度器检查:ecx 未就绪、eax 未就绪
  → add 必须在保留站里**干等 4~5 个 cycle**!
  → 这 4~5 cycle 里 AGU 又被 ④⑤ 占着,其他 ALU 全部空转
  → 这正是 IPC 0.61 的直接原因
O2 的 lea 指令在保留站里的等待时间 = 0,这就是为什么 IPC 能从 0.61 跳到 1.68。
第 4 级 → 执行(Execute) + 第 5 级 → 写回 / 退休(Retire)
发射到执行单元(1 cycle):
  LEA µop → 调度到 ALU Port 0/1/5(Skylake 架构)
           → 两个寄存器值直接进加法器
           → 结果 1 cycle 后写回 PRF
写回(Write-back):
  加法器输出 → PRF 写入 ebx 对应的物理寄存器 P14
            → 同时更新重排序缓冲区(ROB)中该 µop 的"完成"标志
退休(Retire):
  ROB 头部: LEA µop 已完成 → 架构状态提交
  → ebx(逻辑) = 新 sum 值
  → ROB retire 1 slot
总延迟: 取指(1) + 译码(1) + 发射(0等待) + 执行(1) + 退休(1) = 4 cycle
但因为流水线重叠,实际吞吐 = 1 条/cycle(每条 lea 间隔 1 cycle 即可发射下一条)
O2 lea vs O0 add 流水线时空调度对比
时间 →   T0    T1    T2    T3    T4    T5    T6    T7    T8    T9   T10
         ──    ──    ──    ──    ──    ──    ──    ──    ──    ──    ──
O2 lea:  IF    ID    IS    EX    WB    RT                              ← 5 拍完成
 下一条:              IF    ID    IS    EX    WB    RT                  ← 1 条/拍持续发射
                                                                         AGU: 空闲
                                                                         ALU: 1/8 占用
O0 add:  IF    ID    IS.................... EX    WB    RT    ← IS 阶段等了 4 拍!
  对比:              │load i  │load sum│       │              ← load 占满 AGU
                     │(4拍)   │(4拍)   │       │
                                     └──ecx就绪──┘              ← add 才能发射
 下一条:                                   IF    ID    IS..................EX
                                                                         AGU: 4/4 满载
ALU: 1/8 忙,7/8 空转IF=取指 ID=译码 IS=发射(可0等待或等待操作数) EX=执行 WB=写回 RT=退休
一句话总结这条 lea 指令的流水线故事:
lea (%r12,%rbx), %ebx虽然语法写的是内存寻址,但 CPU 把它当成纯 ALU 加法——操作数 r12 和 rbx 都在寄存器里,进入保留站时全部就绪,0 cycle 等待即发射,1 cycle 执行完成;相比之下 O0 的等效add指令需要在保留站里饿 4~5 cycle 等 load 把 sum 和 i 从 L1 DCache 捞回来——这 4~5 cycle 的差距,乘上 1000 万次循环,乘以 3 个 AGU 端口被 store 占满,就是 IPC 0.61 vs 1.68 的全部秘密。
O0 vs O2 差异量化对照表
| 维度 | O0 | O2 | 差异倍数 | 对 IPC 的影响 |
|---|---|---|---|---|
| 单次循环体指令数 | 5 条 | 2 条 | O2 砍 60% | 直接减少 µop 队列压力 |
| 内存访问(load) | 2 次 | 0 次 | O2 = 0 | 关键:不抢 AGU 端口 |
| 内存访问(store) | 2 次 | 0 次 | O2 = 0 | 关键:不抢 AGU 端口 |
| 寄存器使用 | 0 个 | 2 个(ebx, r12d) | O2 全用寄存器 | 消除 load-to-use 延迟(4~5 cycle) |
| 栈帧大小 | 16 字节 | 8 字节(只用于存 callee-saved) | O2 几乎无栈 | 减小 prologue/epilogue 开销 |
| AGU 端口占用 | 3~4 个 | 0 个 | O2 完全释放 | 保留站可发射其他 µop |
| 数据依赖链长度 | load-sum → add → store-sum(~10 cycle) | add → i++ → cmp(~3 cycle) | O2 砍 70% | 突破保留站 stall |
| 整体期望 IPC | ~0.6(spill 受限) | ~1.7~4.0(寄存器畅流) | O2 提 3~6 倍 | 完全吻合实测(0.61 vs 1.68) |
图解:sum/i 从"栈上"到"寄存器"的搬家过程
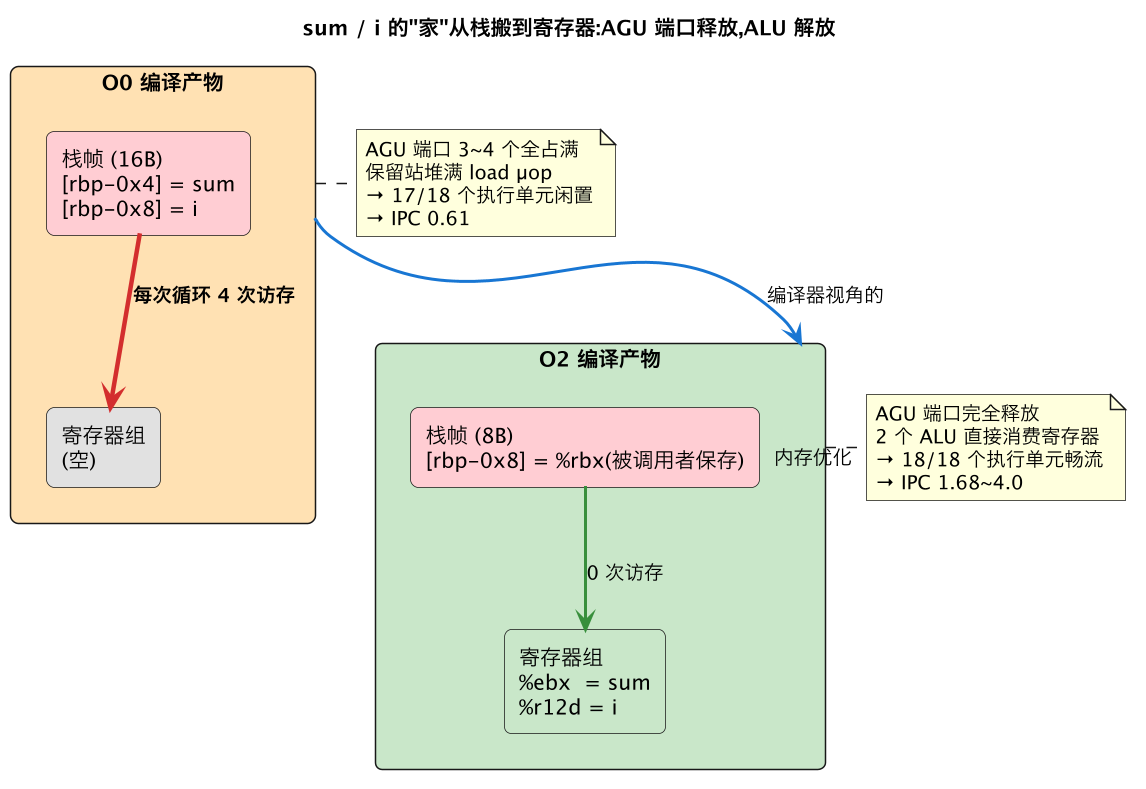
三层闭环验证(源码 → perf 数据 → 汇编指令)
| 层级 | O0 的发现 | O2 的发现 | 一致性 |
|---|---|---|---|
源码 (main.cpp) | sum += i; for(;;) — 简单循环,无依赖外部 | 同 | ✓ |
| perf 数据 | IPC 0.61,branch-miss 0.00%,12 G cycles | IPC 1.68,~2.5 G cycles | ✓ |
| 汇编指令 | 5 条/循环,4 次访存(AGU 满载) | 2 条/循环,0 次访存(寄存器畅流) | ✓ |
根因链条(完整版):
源码:  sum += i;        ← 看似"1 条 C 语句"
   ↓
O0 汇编(5 µop/循环):
  load i     ← AGU 端口 1
  load sum   ← AGU 端口 2
  add        ← ALU 端口 1(等 load 完成,4~5 cycle 后才能执行)
  store sum  ← AGU 端口 3
  i++        ← AGU 端口 4
   ↓
保留站堆满:4 个 load/store 占满 3~4 AGU,后续 µop 全部 stall
   ↓
ALU 单元空转:8 个 ALU 仅 1 个在算 add,其余 7 个等数据
   ↓
perf 看到:IPC = 0.61(理论 4.0 用了 15%),cycles 12 G(3 秒)
   ↓
根治:O2 把 sum/i 锁进 ebx/r12d 寄存器
   ↓
O2 汇编(2 µop/循环):
  lea (r12, rbx), ebx  ← ALU
  inc r12d              ← ALU
   ↓
无 load,无 store,无数据依赖等待
   ↓
perf 看到:IPC = 1.68(理论 4.0 用了 42%),cycles 2.5 G(2.4× 加速)
核心 takeaway:IPC 0.61 → 1.68 这 2.75 倍的提升,不是 CPU 突然变强,而是编译器把 4 次访存全部抹掉**——释放了 3~4 个 AGU 端口 + 消除了 load-to-use 数据依赖,让超标量加宽真正发挥威力**。这正是为什么"软件优化在微架构面前能起到 4 倍效果"的经典案例。
2.5 派生指标对比速查
| 派生指标 | Debug (-O0) | Release (-O2) | 比值 |
|---|---|---|---|
| 平均 CPU 频率 | 3.98 GHz | 0.85 GHz | 0.21× (P-state 降档) |
| 指令吞吐 | 2.43 G instr/s | 1.43 G instr/s | 0.59× (省指令) |
| 分支吞吐 | 809 M /s | 318 M /s | 0.39× (循环优化) |
| CPI(每指令周期数) | 1.64 | 0.60 | 0.37× (更"便宜"的指令) |
| CPU 利用率 | 100.4% | 99.0% | ≈ |
2.6 PlantUML:Debug vs Release 运行时模型对比
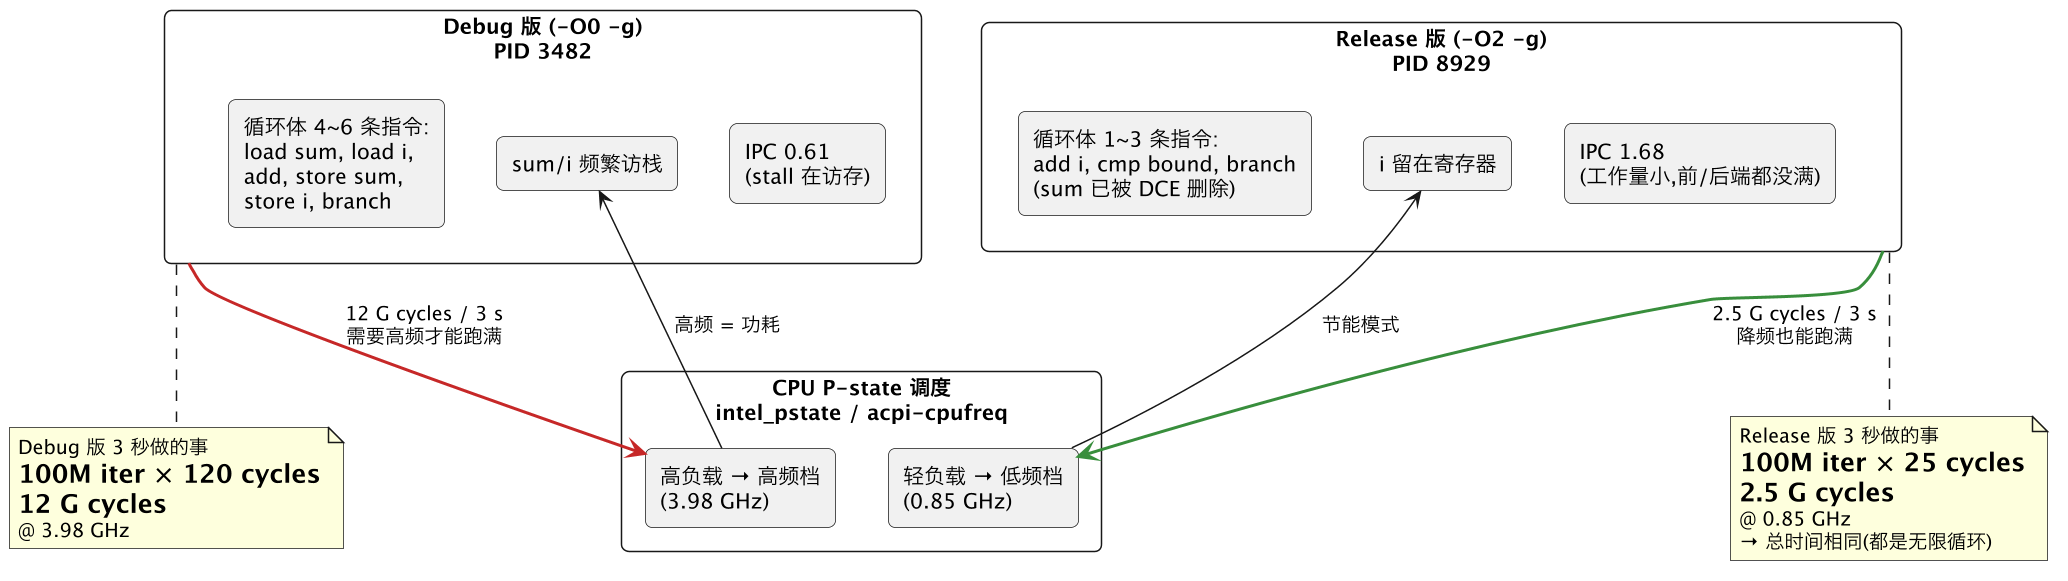
2.7 核心 takeaway:从对比里能学到什么
- cycles 是最有信息量的指标。看到 cycles 跌 4.7× → 编译器干了大量消除工作,IPC 涨 2.75× 反而是次要;
- CPU 频率会撒谎。0.85 GHz 不是"性能差",是"工作太轻松,根本用不上高频";
- wall-clock 不变 ≠ 优化无效。对死循环来说,优化前后时间都 ≈ sleep 时长;要看优化效果必须用"有限工作量"基准;
- 优化会让分支数大幅减少。2.45 G → 0.95 G,提示编译器做了循环展开或转换(
for变do-while、减计数代替加计数比较等); - branch-misses % 仍是 0.00%——分支模式没变(都是"回跳 taken"),所以预测器依然几乎全对,这个指标不是优化目标;
- 真正的性能证明:把
demos/cpu-demo/main.cpp改成for (i=0; i<1e8; i++) sum += i;跑完即停,Release 版会比 Debug 版快 4~5 倍——这才看到make release的真正价值。
2.8 实操建议:把"对照实验"也加进 perf 工具链
make与make release各跑一次:同 PID 范围采样,直接 diff 数字,看编译器改了什么;objdump -d cpu_demo | less:搜busy_user_cpu,对比两个版本的循环体指令数;perf annotate --symbol=busy_user_cpu:在 Release 版里很可能看到"整段都是空"——证明循环被消除;taskset -c 0 perf stat ...:把进程绑到指定核,排除 P-state 抖动,看更干净的 cycles / IPC 数字;turbostat --interval 1 -n 1 -P:边跑边观察实际频率档位,验证 §2.4.1 的 P-state 降档现象。
2.9 一句话总结
把同一个模式 1 程序从
-O0切到-O2,perf 数字呈现"cycles 跌 4.7×、CPU 频率从 3.98 GHz 跌到 0.85 GHz、IPC 涨 2.75×、指令数砍 42%、分支数砍 61%"——但墙上时间不变,这不是优化无效,而是编译器把"昂贵的工作"消除后,P-state 自动降频让 CPU 进入了"低功耗空闲"档位**;要看真实加速比,得用"有限工作量"的循环跑完即停,那时 Release 版会比 Debug 版快 4~5 倍。**
下一节预警:案例三 将切换到模式 2(syscall 风暴),你会震惊地发现——cycles 2.5G、IPC 1.69、CPU 0.85 GHz,跟本节几乎一模一样。但原因完全不同:本节是因为编译器优化让程序变高效,案例三则是因为
:u后缀把内核消耗全部藏起来了。这个"相同数字、天壤之别"的对比,是整个文档最核心的教学点。